能力第一,可靠性却只排第七:SO-Arena 拆穿了 System One 的“高分幻觉”
把选项 A、B、C 换成 C、A、B,模型还会选同一个答案吗?把正确选项悄悄删掉,它会发现“这题无解”,还是照常从错误答案里挑一个?
这两个问题看起来有点刁钻,却特别接近决策模型的真实使用场景。工具列表的顺序会变,检索结果可能全军覆没,网页上也不一定存在可执行动作。一个模型在固定试卷上答得漂亮,并不代表它能在这些变化里保持稳定。
SO-Arena 最让我感兴趣的结果就在这里:System One 能力榜冠军 GLiDE 拿到 70.2 分,可靠性却只排第七;JevAny-27B 能力总榜只排第 11,可靠性反而以 84.1 分居首。高分与可靠,真的不是同一件事。
核心摘要
SO-Arena 用 2,919 道题、11 个领域和五类能力,给不写长推理链、直接输出选项概率的 System One 模型做了一次全面体检。它不只统计准确率,还按领域内难度分层,把模型放进网页与工具沙盒,并用选项重排和删除正确项测试可靠性。21 个模型中,GPT-6 Sol、Luna 以 82.3 和 79.7 分领先;最强 System One 模型 GLiDE 与 KnowLine-31B 都是 70.2 分,但开放权重模型在单张 H100 上的平均延迟全部低于 0.3 秒。我觉得这套基准最值钱的不是又造了一张榜,而是把“会不会答”和“答案变了没有、无解时能不能察觉”拆成了两条独立坐标。
论文信息
- 标题:SO-Arena: Benchmarking the Capability Spectrum and Reliability of System One Models
- 作者:Lichen Li、Ziping Dong、Sicheng Feng、Qi Li、Xinchao Wang
- 提交日期:2026 年 11 月 11 日,v1
- 机构信息:arXiv 摘要页未集中列出作者单位
- 论文链接:https://arxiv.org/abs/2611.15777
- 项目主页:https://lichenlillc.github.io/SO-Arena
- 论文规模:32 页,10 张图,7 张表
System One 不写答案,它直接给“决策分布”
普通大模型做选择题,常见流程是先生成一段分析,再输出答案。System One 决策模型换了个接口:输入状态 \(s\)、决策问题 \(q\) 和候选集合 \(\mathcal{C}\),一次前向传播直接返回所有候选的概率。
它支持三种输出。Choice 在无序候选中做分类,Noul 回答是或否,Score 在有序等级中打分。模型可以由专门的决策头实现,也可以从语言模型 logits 读出概率;关键不在于内部一定长什么样,而在于它不需要先写一段推理文本,再把文本解析成程序能用的标签。
这个接口很像软件里的语义开关。工单分给哪个组、检索段落是否相关、下一步点哪个按钮、任务是否已经完成,都能写成固定候选上的概率分布。Jev 把这种接口推广成通用服务,Kev、JevAny 等开放实现随后出现;JevBench、JEVal 和 OpenDecisions 已经分别覆盖过校准、延迟、工作流或扰动评测。SO-Arena 并不是从零发明“决策评测”,它更进一步的地方,是把难度、交互执行、历史验证和可靠性放进同一套框架。
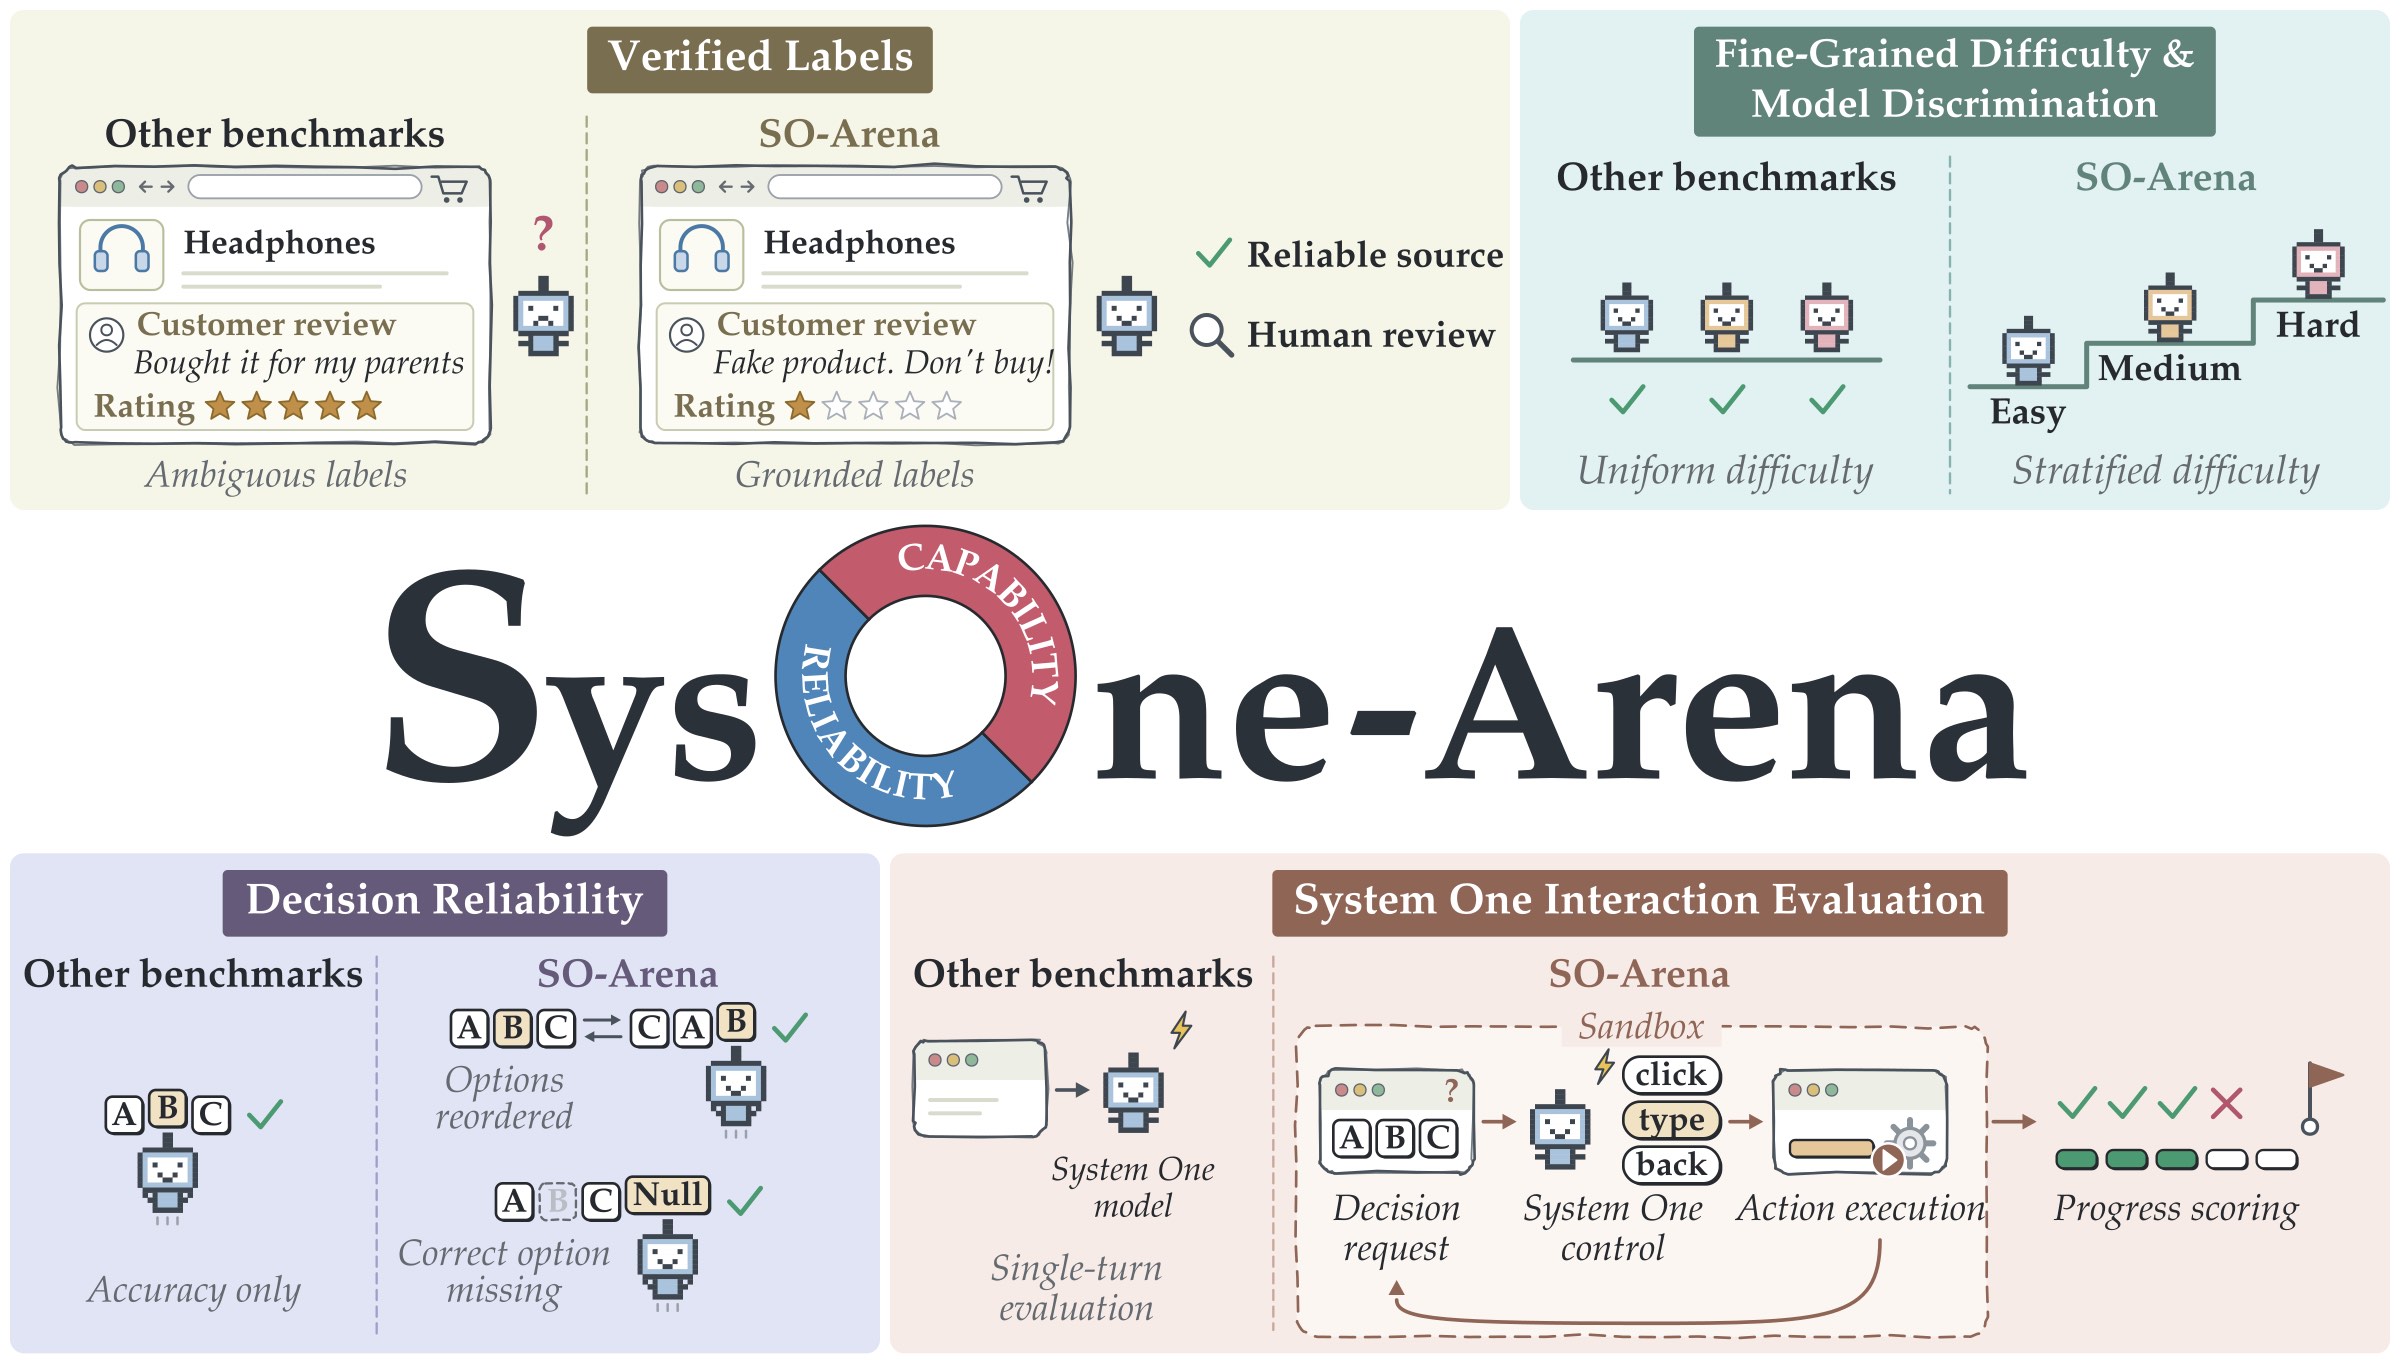
图1:SO-Arena 的四个设计重点。上排是参考标签核验与难度分层;下排左侧用重排和删除正确项检查可靠性,右侧把单轮判断扩展为沙盒中的多步执行与进度评分。
2,919 道题,不是把 40 个数据集简单拼起来
作者从 40 个公开数据集、基准和环境中取材,保留来源、版本和原始样本标识,再用人工与 LLM 复核参考标签。可疑样本会被丢弃,模型生成的参考答案则在元数据里单独标记。
这个流程很务实。很多评测把原始标签当成天然真理,但模型实际看到的输入可能缺了证据,原数据集的答案再正确,也没法从当前上下文推出来。SO-Arena 要检查的是“标签是否被模型可见信息支持”,不是只检查原数据集有没有答案。
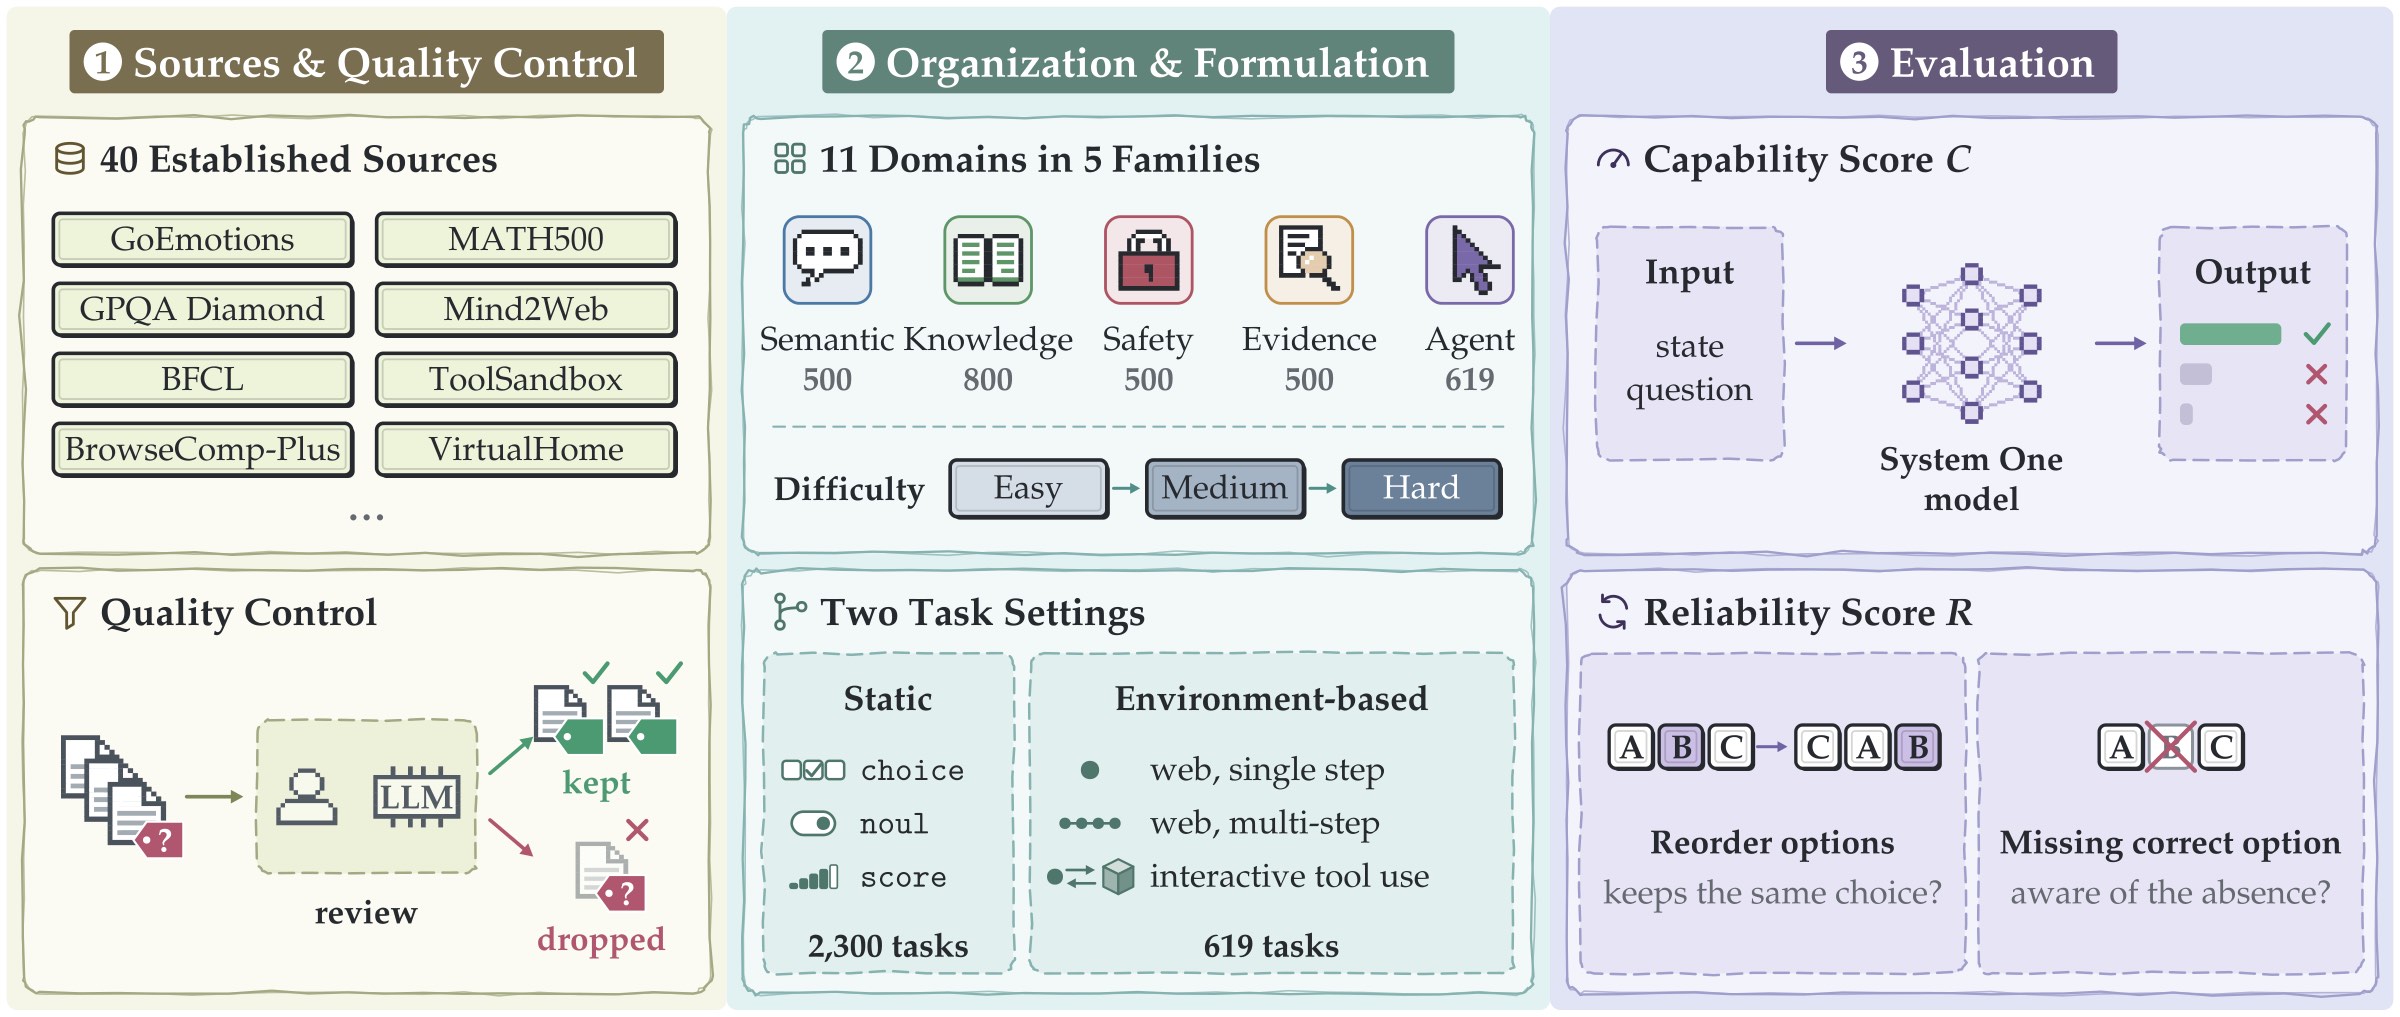
图3:左侧是 40 个来源及人工、LLM 复核;中间把任务组织成五类能力、11 个领域和两种任务环境;右侧分别计算能力分 C 与可靠性分 R。2,300 道静态题和 619 道环境任务使用统一的决策接口。
整套基准包含 2,300 道静态题与 619 道环境任务。后者拆成 337 道网页任务和 282 个交互式工具 episode;网页任务又包括 100 道单步判断和 237 道沿已验证路线执行的多步任务。静态题里的开放数学答案会被改成选择题,干扰项来自基础模型的错误答案、解题中间结果和规则生成的近似错误。
这带来一个不能忽略的边界:SO-Arena 评的是有限候选上的判断,不是自由生成。数学从“独立求解”变成“识别正确候选”,代码理解也被包装成 Noul 判断。它更接近模型作为决策器的使用方式,却不能替代开放式数学或编程基准。
| 能力族 | 领域 | 题数 | 难度分层 | 主要评测形式 |
|---|---|---|---|---|
| 语义理解 | 情绪与情感理解 | 200 | 不分层 | Choice、Score |
| 语义理解 | 意图与路由 | 300 | 100/100/100 | Choice、Noul |
| 知识与推理 | 数学 | 200 | 50/50/70,另有 30 道极难 | Choice |
| 知识与推理 | 代码理解 | 200 | 60/70/70 | Noul |
| 知识与推理 | 科学推理 | 200 | 50/70/80 | Choice |
| 知识与推理 | 知识与常识 | 200 | 不分层 | Choice |
| 安全与策略 | 安全 | 500 | 177/165/158 | Choice、Noul |
| 证据评估 | 检索与重排 | 300 | 100/100/100 | Noul、Score |
| 证据评估 | 任务完成验证 | 200 | 91/89/20 | Choice、Noul |
| 智能体执行 | 工具与 API 使用 | 282 | 100/78/104 | 连续 Choice |
| 智能体执行 | 文本网页交互 | 337 | 100/137/100 | Choice、Noul、连续决策 |
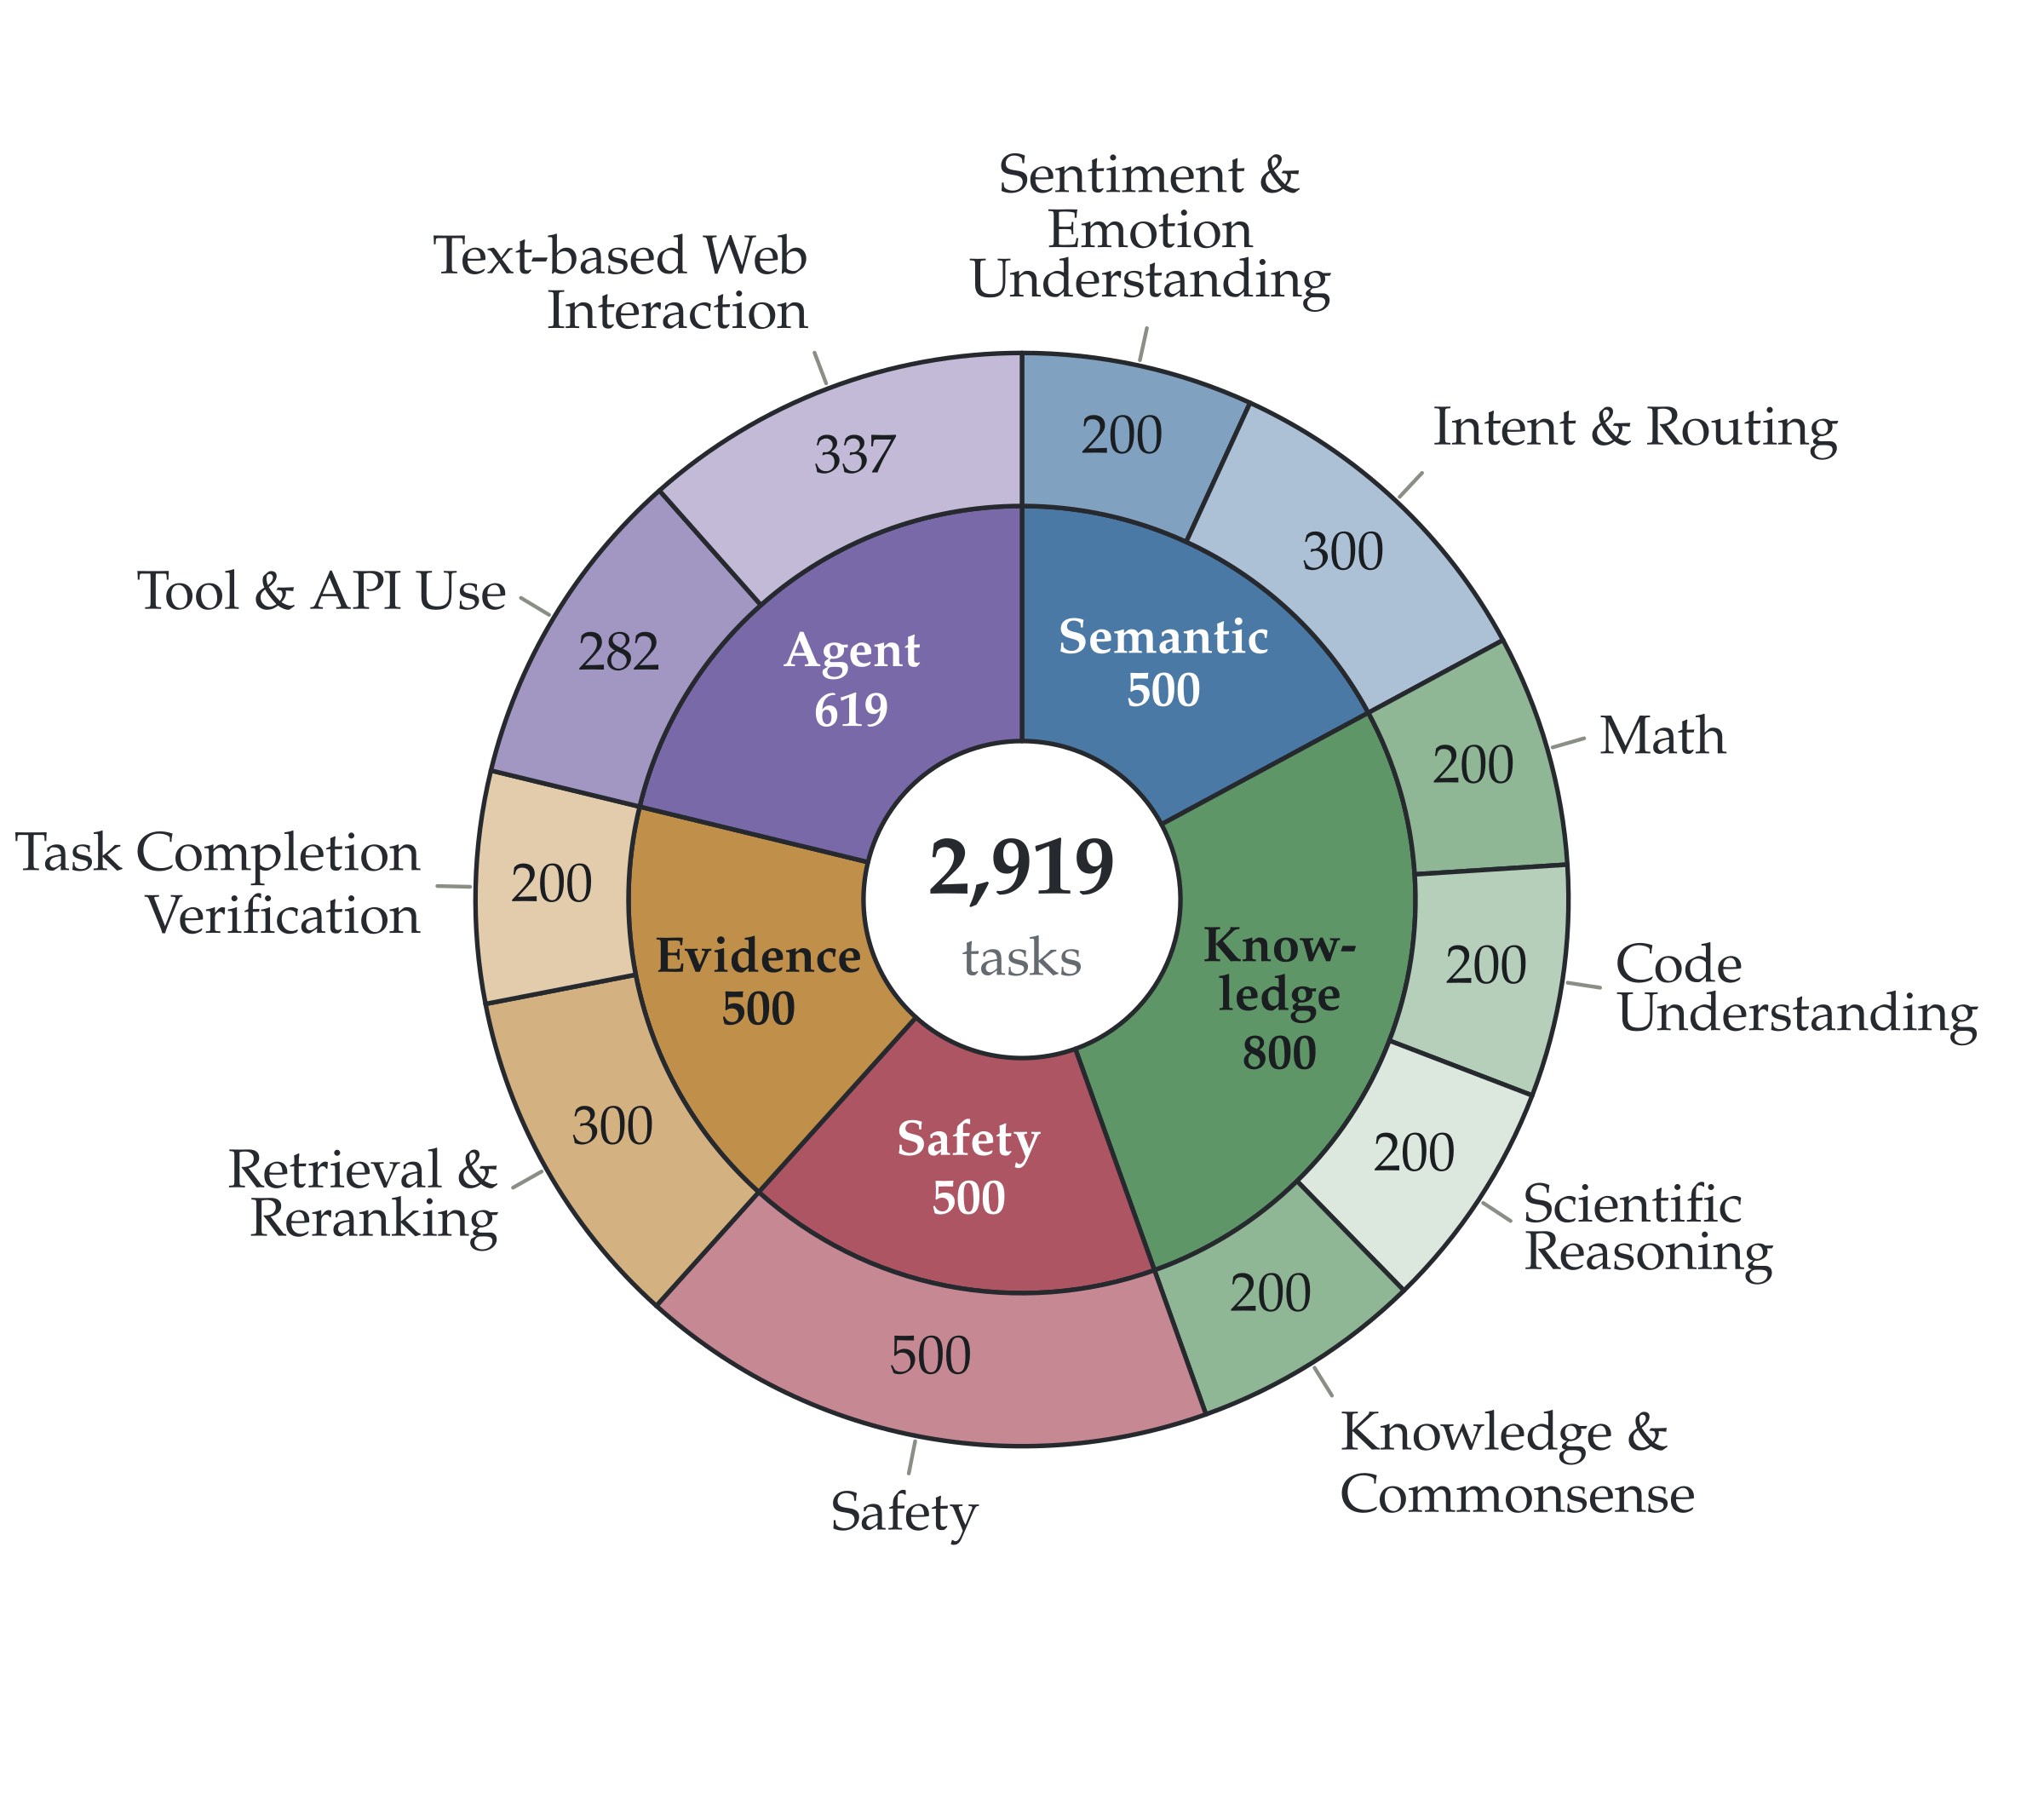
图4a:内环是五类能力,外环是 11 个领域。知识与推理共 800 题,智能体执行共 619 题;安全单独占 500 题。总题量不等于最终能力榜的计分题量。
难度分层有用,但不同领域的 Hard 不能横向比较
九个领域设置了难度层级,情绪理解和知识常识不分层。数学按来源难度或计算步数划分;任务完成验证则从直接状态检查,逐渐过渡到证据整合和历史依赖判断。
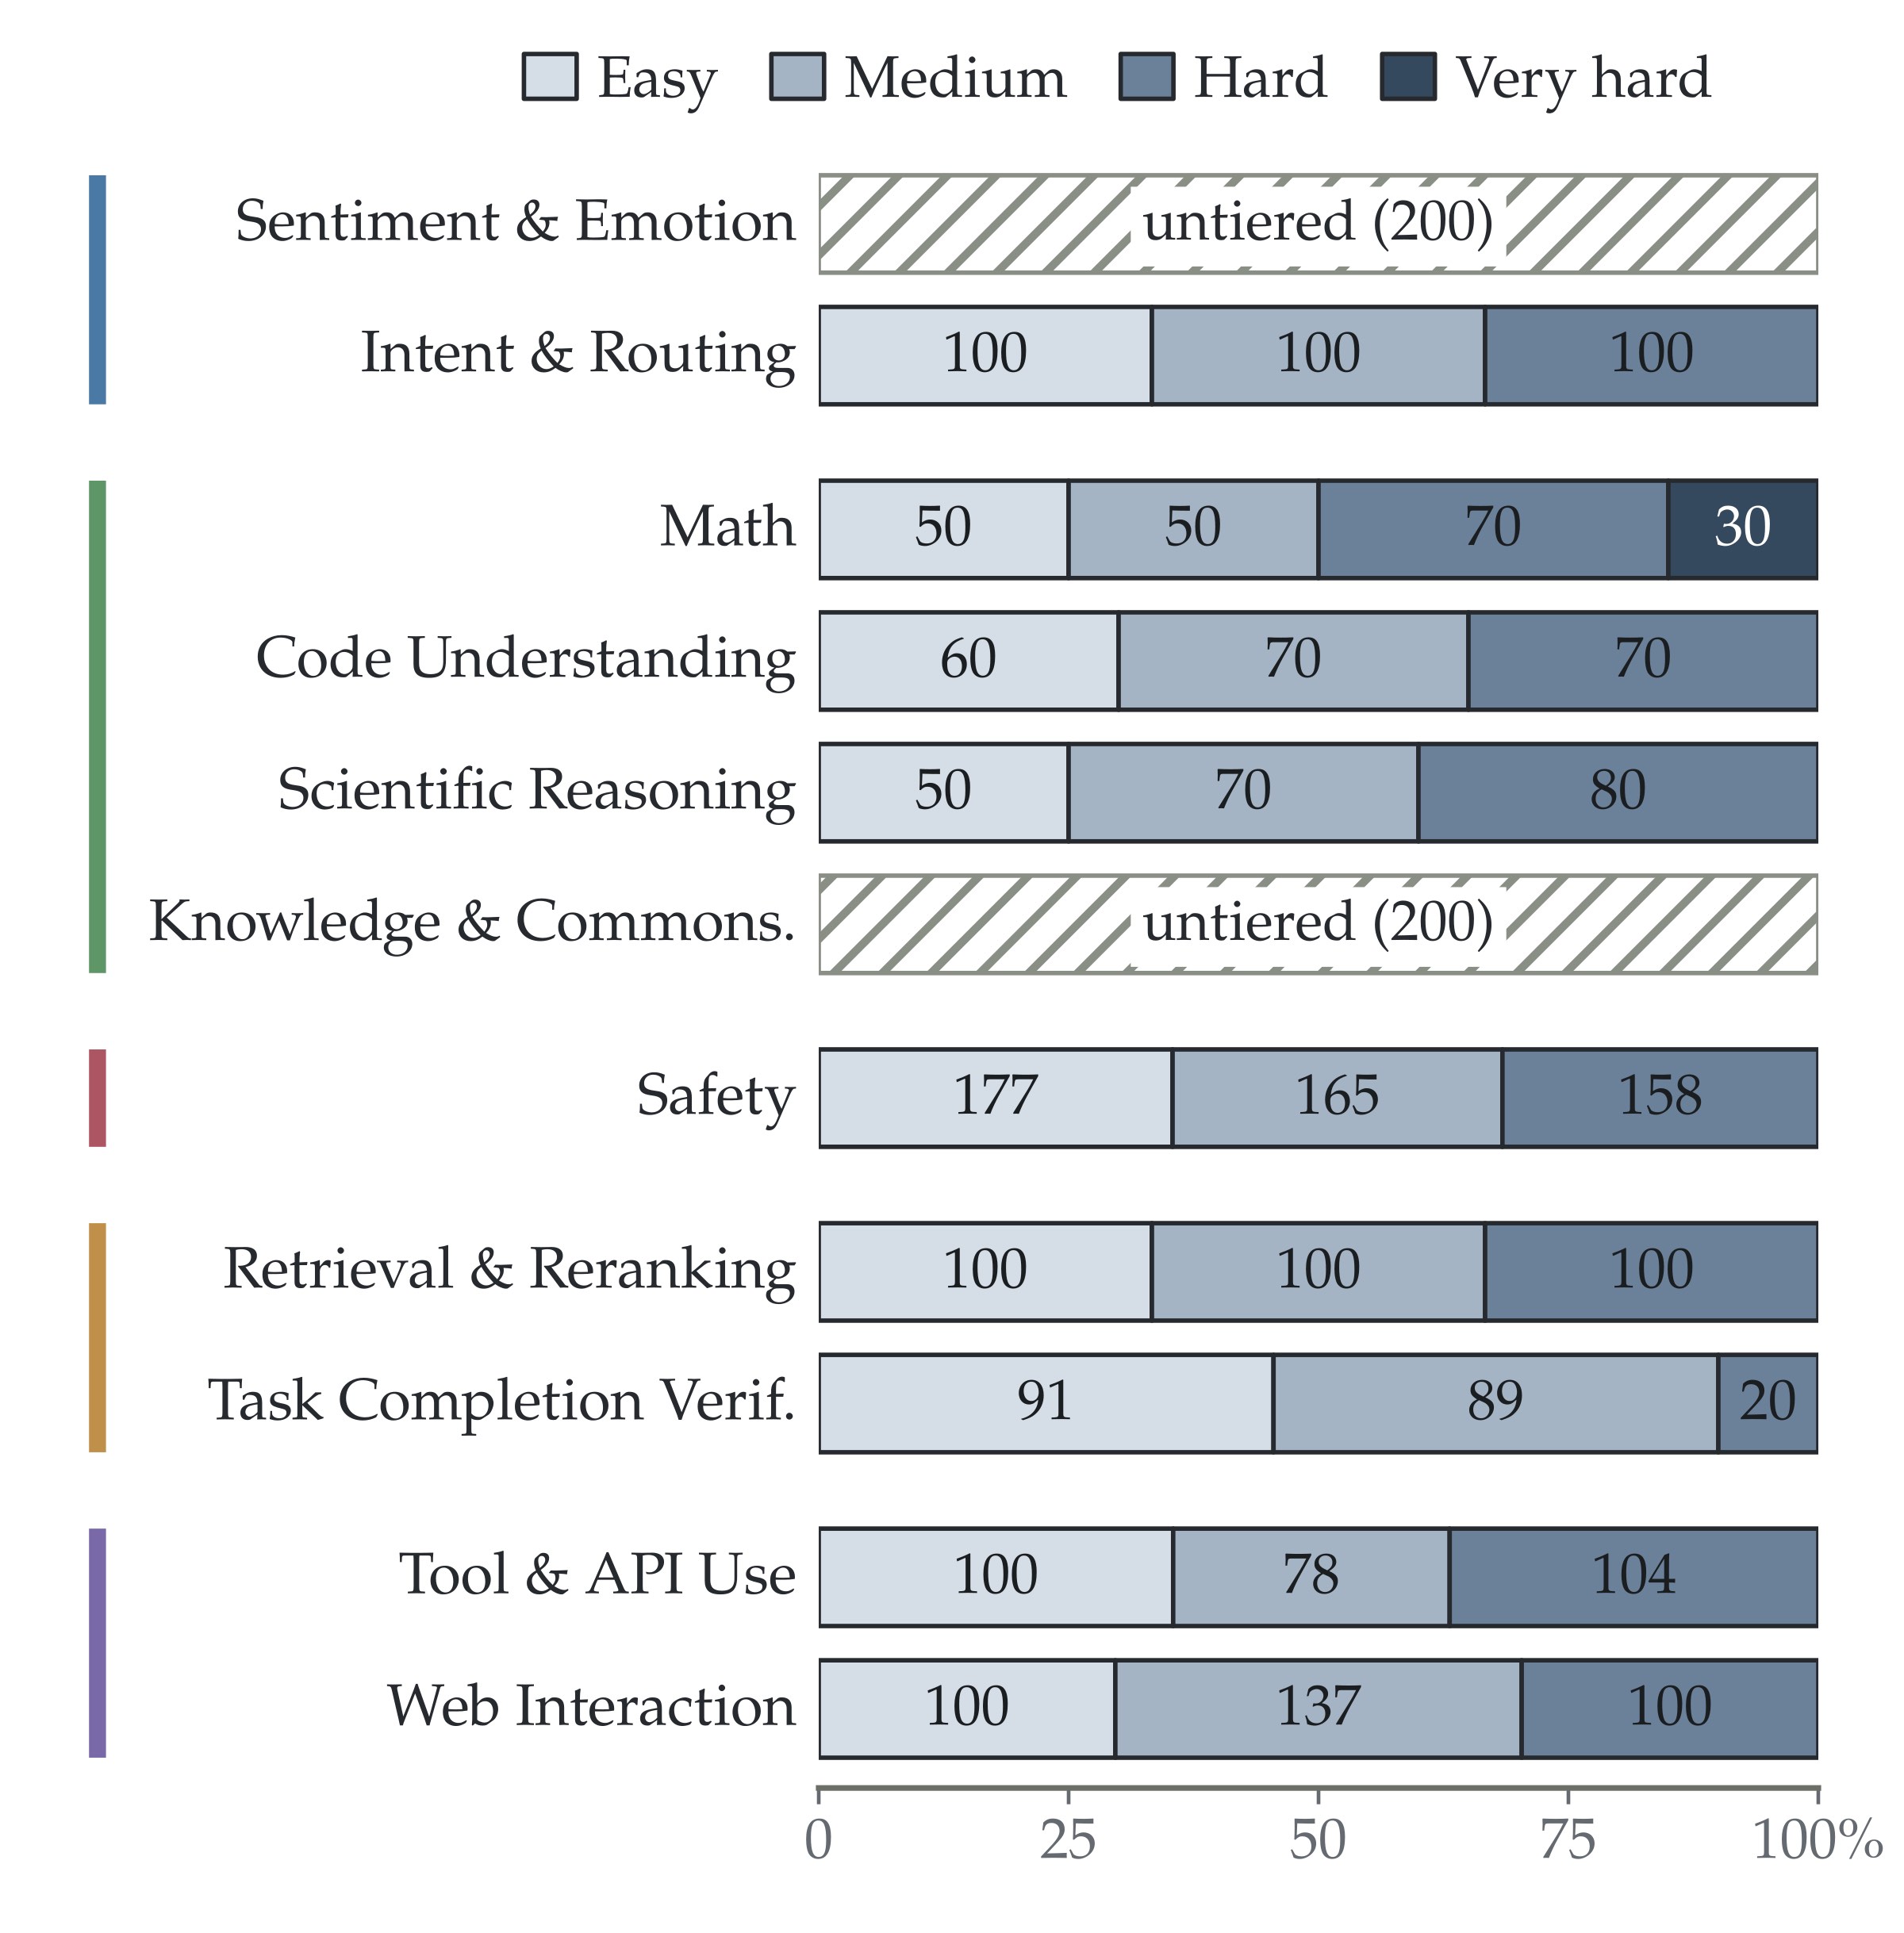
图4b:Easy、Medium、Hard 的数量在各领域差别很大。任务完成验证的 Hard 只有 20 题,安全有 158 题;数学额外加入 30 道 AIME 2025–2026 极难题。图中阴影明确提示,分层只在各自领域内部成立。
这里要踩一下刹车。Hard 不是一把跨领域通用的尺子:数学 Hard 可能来自 MATH500,科学 Hard 来自 GPQA Diamond,安全 Hard 又采用另一套标准。你可以比较同一个模型在数学 Easy 到 Hard 的下滑,却不能说“安全的 80 分”比“数学的 60 分”更容易或更难。
排行榜也没有平均全部 2,919 道题。它只取每个领域最高难度层;数学取 Hard 与 Very Hard,两个未分层领域取全部样本。最终计分集合是 1,232 道题,每个领域先算平均分,再对 11 个领域等权平均:
其中 \(c_i(m)\) 是模型在原始任务上的得分,\(D=11\)。这个设计避免 500 道安全题压过只有 200 道的代码题,也把榜单注意力推向难题。不过,任务完成验证的 Hard 只有 20 题,却仍占总分的十一分之一。等权很公平,小样本波动也会被等权放大,这两面得一起看。
沙盒评测:既考“会做”,也考“会验收”
SO-Arena 把 Agent 能力拆成两个角色。作为行动者,模型根据目标和当前观察选择动作;网页环境沿可回放的参考路线逐步前进,工具环境则由 BFCL 或 ToolSandbox 模拟器真正执行动作,再把新观察返回给模型。
作为验证者,模型要判断一段已记录执行是否完成目标。最难的地方不是看最终状态,而是检查历史:两段轨迹可能到达相同的最终目标投影,其中一段却违反了中间约束。只比较最终数据库或页面状态,根本分不出这两种情况。
我认为这是整套设计里很贴近工程的一笔。Agent 系统里“执行下一步”和“确认是否完成”通常是两个反复调用的决策点,后者的错误尤其隐蔽——任务看似结束,流程其实违规。SO-Arena 让同一个模型既当司机又当验收员,暴露的是两种不同的能力。
当然,网页多步任务仍以已验证路线和候选菜单为骨架,不是完全开放的网络探索。它比静态选择真实得多,但还不能代表长程自主规划的全部难度。
可靠性怎么测:换顺序,再把正确答案拿走
SO-Arena 的可靠性由两个互补指标组成。
选项顺序稳定性 \(S\) 会把每道题原始顺序之外的 12 种重排分别交给模型,并按选项内容而不是 A/B/C 位置追踪答案。原始一致率记为 \(A\),再扣除随机选择也会产生的一致率 \(p_e\):\(S=(A-p_e)/(1-p_e)\)。它只问“答案变没变”,不管原始答案对不对。
缺失答案识别 \(N\) 则把每道题展示两次,一次保留正确项,一次删除正确项。模型需要估计候选中包含正确答案的概率,作者用 \(p_{\mathrm{null}}=1-p(\mathrm{inc})\) 表示“无正确答案”的概率,再计算 \(N=2\operatorname{AUC}-1\)。随机区分得到 0,所有缺答案副本都获得更高 Null 概率才得到 1。
两项合成几何平均,只有两者都高于随机水平才有正分:
几何平均选得很合理。一个模型即使重排完全不动,如果正确答案被删掉后毫无察觉,也不该拿到“可靠”的高评价。
不过,这两个测试主要作用于静态选择题集合:顺序实验使用 939 个样本,Null 实验使用 597 个样本。它们揭示了重要的接口偏差,却没有覆盖交互环境中的所有可靠性来源,例如状态漂移、工具异常或多步误差累积。
主结果:快 10 倍以上,能力仍差约 10 分
论文评测 21 个模型:16 个开放权重 System One、一个自动切换推理的 StartLux Auto、两个闭源决策 API,以及 GPT-6 Sol 和 Luna 两个 System Two 参照。主榜按 11 个领域的最高难度层计算。
| 模型 | 能力分 C | 数学 Hard | 科学 Hard | 工具 Hard | 网页 Hard | 平均延迟 |
|---|---|---|---|---|---|---|
| GPT-6 Sol | 82.3 | 100 | 91 | 66 | 53 | 约 2.8 秒 |
| GPT-6 Luna | 79.7 | 100 | 88 | 68 | 48 | 约 2.7 秒 |
| GLiDE 27B | 70.2 | 64 | 55 | 65 | 49 | 113 ms |
| KnowLine-31B | 70.2 | 71 | 52 | 56 | 44 | 177 ms |
| Sieve-31B-v3 | 67.7 | 66 | 55 | 60 | 43 | 265 ms |
| Decider-27B | 66.7 | 61 | 52 | 67 | 50 | 153 ms |
| Jev API 1.14 | 60.4 | 63 | 71 | 59 | 41 | 249 ms |
| StartLux Instant 4B | 59.0 | 43 | 46 | 54 | 31 | 35.1 ms |
| JevAny-27B | 58.4 | 53 | 60 | 58 | 41 | 93.9 ms |
| Laya 0.4B | 30.9 | 23 | 24 | 0 | 2 | 6.0 ms |
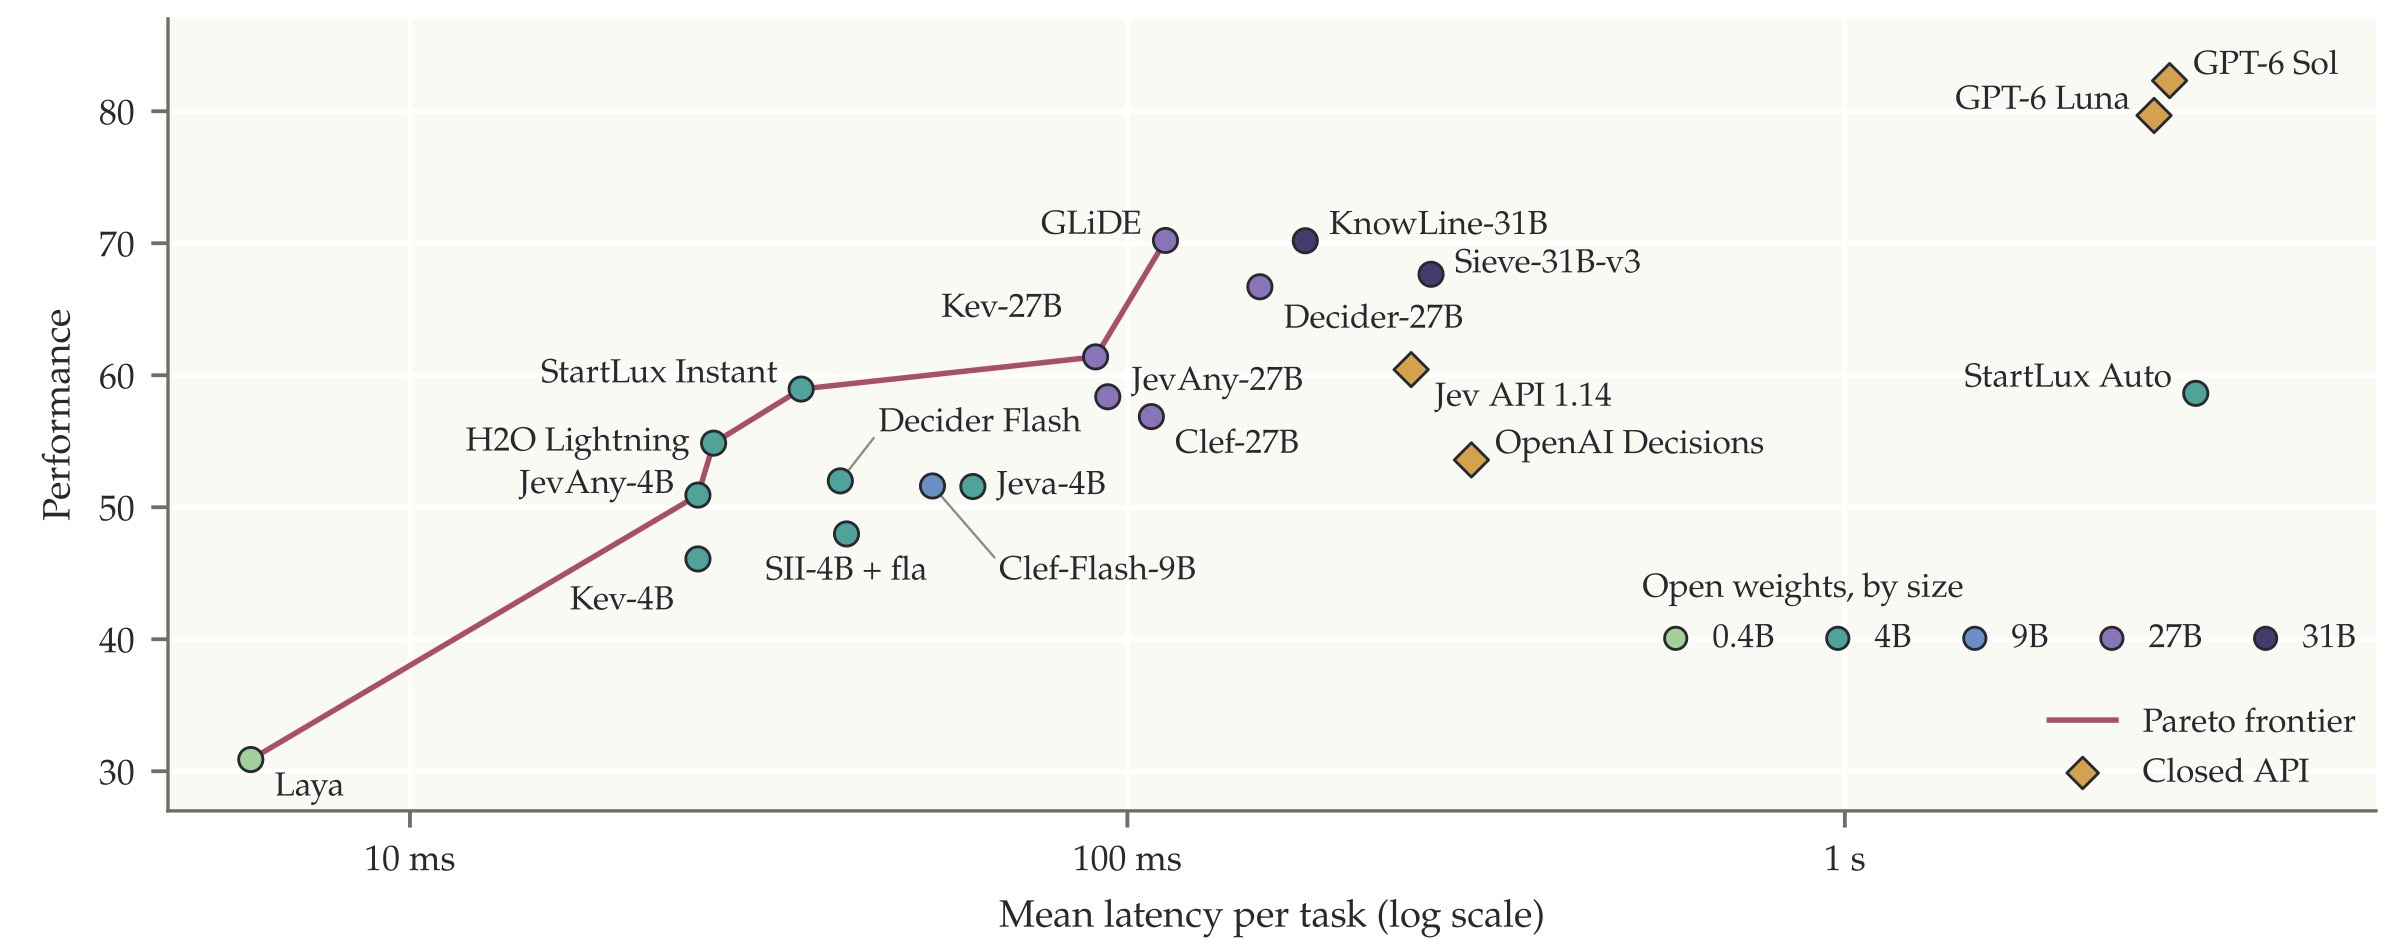
图5:横轴为单任务平均延迟,采用对数刻度;纵轴为能力分。GLiDE 位于开放 System One 的高分端,GPT-6 Sol、Luna 分数更高但落在秒级区域。红线连接不同速度下的 System One Pareto 前沿。
所有开放权重 System One 的平均延迟都低于 0.3 秒,测量使用单张 H100 80GB、每次一个请求,包含 tokenization 和本地服务往返。GLiDE 的 113 ms 与 Luna 的约 2.7 秒相比,确实是数量级差距。
但别把这个实验读成严格同硬件对比。开放模型跑在独占 H100 上,闭源 API 测的是带网络和排队的端到端延迟,而且采用四个并发请求。作者把协议写清楚了,这是好事;做采购决策时,仍应该用自己的输入长度、部署框架和并发量重新测。
还有一处工程细节挺扎眼:Sieve-31B-v3 的平均延迟为 265 ms,99 分位却到 2,475 ms。只报平均值会遮住长尾,线上实时系统更应该盯 P99。
最反直觉的一张榜:能力冠军只排可靠性第七
18 个 System One 模型进入完整可靠性分析。JevAny-27B 的 \(R=0.84\),Jev API 1.14 为 0.83,排在前两名;它们在这 18 个模型中的能力排名却只有第八和第六。GLiDE 能力第一,\(R=0.78\),可靠性排第七。
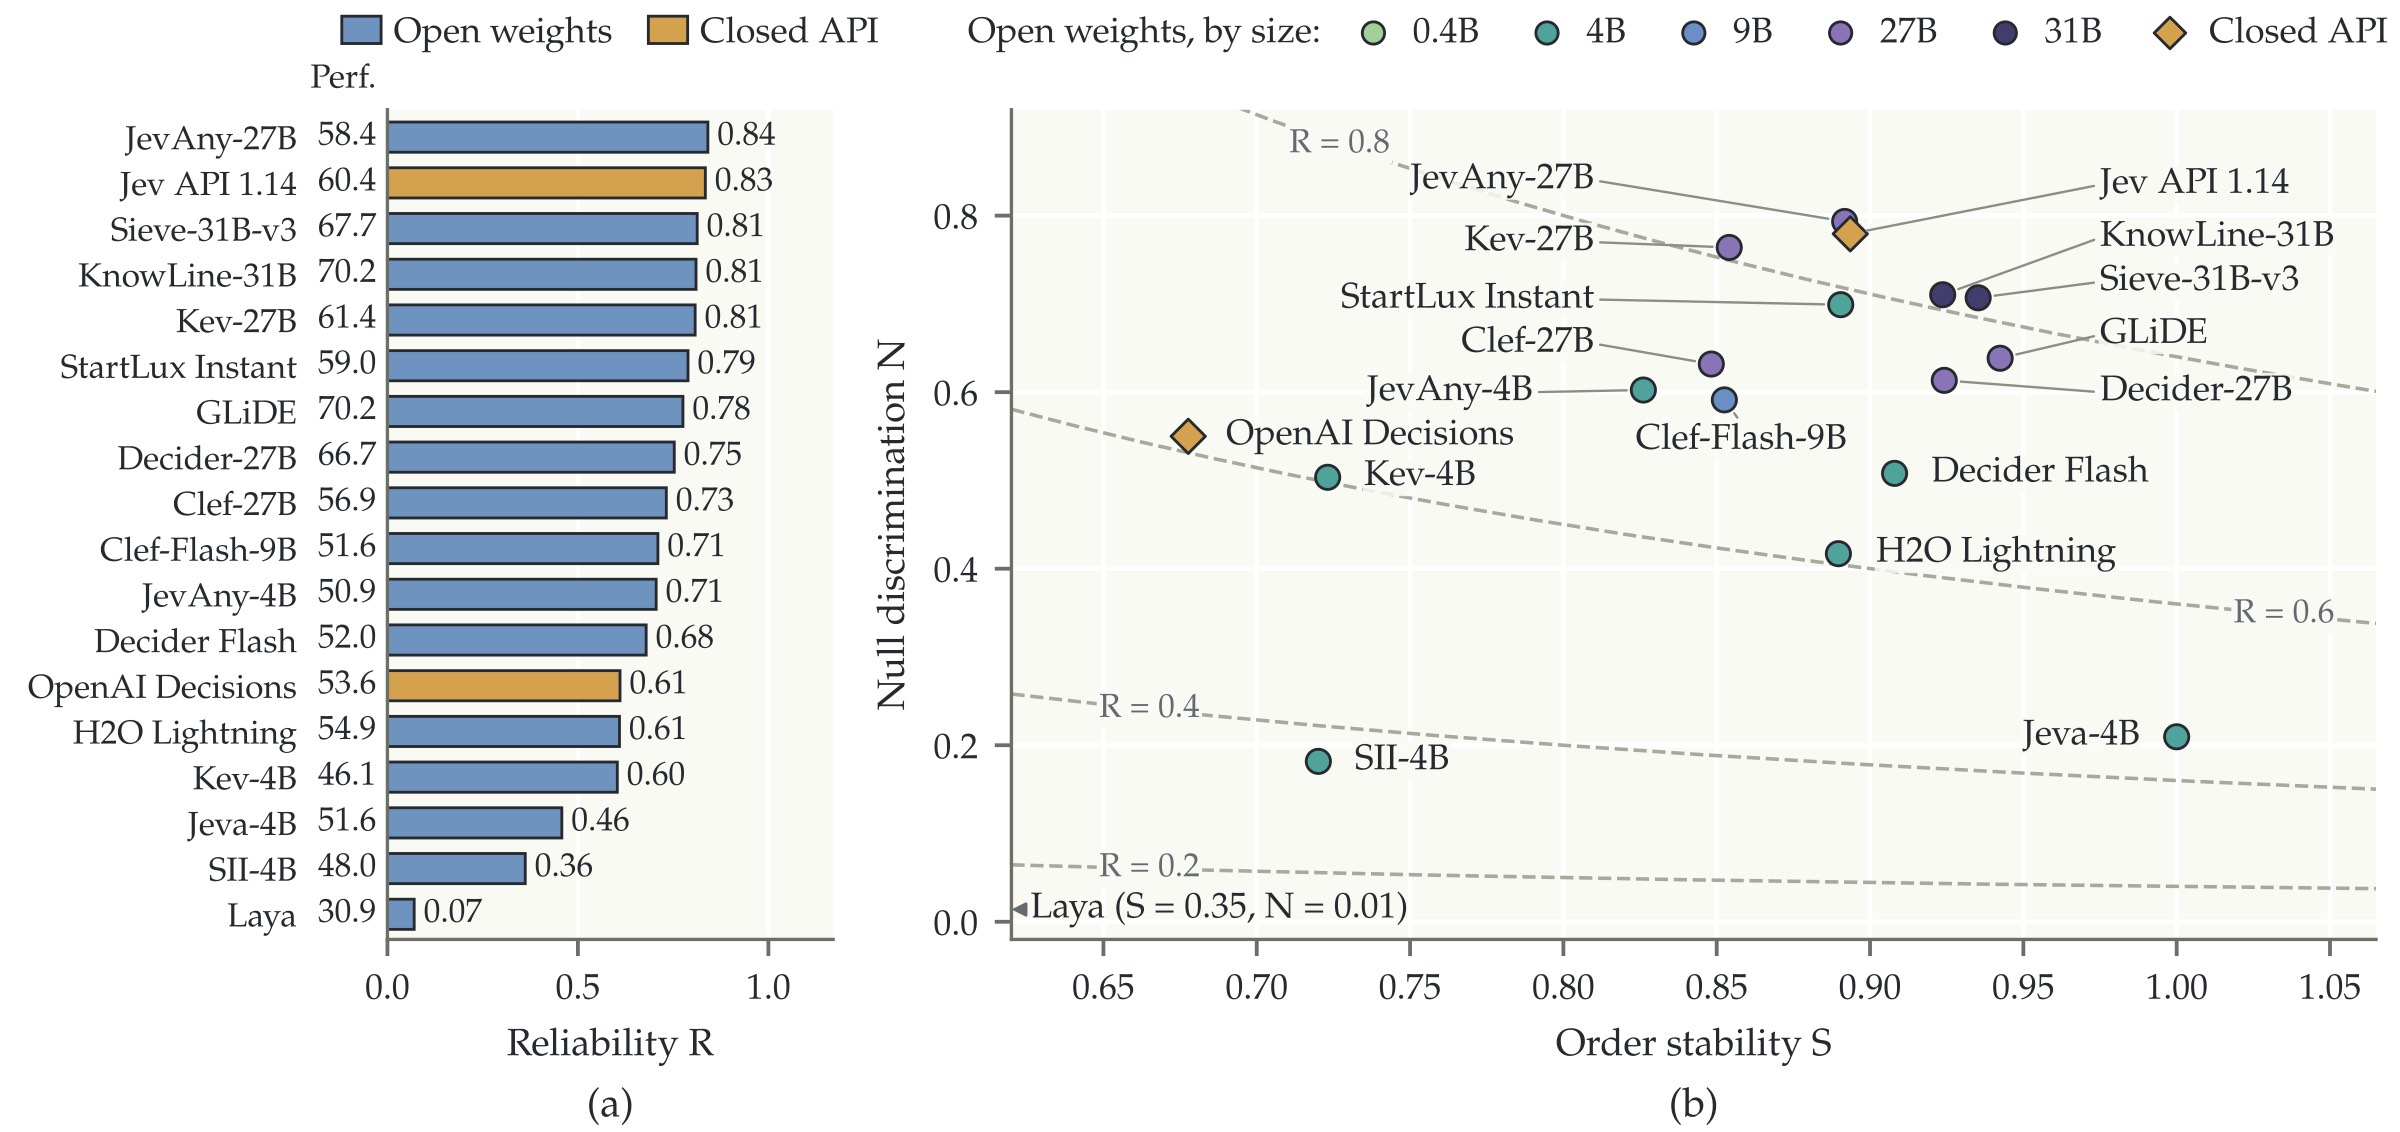
图6a:左侧 Perf. 是能力分,条形是可靠性 R。JevAny-27B 与 Jev API 1.14 领先,GLiDE 位于第七。图6b:横轴为顺序稳定性 S,纵轴为缺失答案识别 N;多数模型集中在高 S 区域,N 却从接近随机一直分布到约 0.8。
18 个模型中有 14 个的 \(S>0.8\)。除了 Jeva-4B 因逐项独立编码而天然得到 \(S=1\),其余高稳定模型大多落在 0.83 到 0.94。Laya、SII-4B、Kev-4B 和 OpenAI Decisions 对顺序更敏感,稳定性约为 0.35 或 0.68 到 0.72。
Null 识别完全是另一幅画面。它从接近随机到约 0.8 都有,同一家族的大模型通常比小模型好,但一些 4B 模型仍能超过 9B 和 27B 模型。参数规模不是可靠性的充分条件。
这里也有两个协议细节不能藏。Jeva-4B 的顺序稳定性由架构保证,并不是训练出来的“抗扰动能力”;StartLux Instant 和 Jeva-4B 都测试了原生 Null 输出与额外 Noul 问题两种格式,最终各取区分效果更好的一种。后者很贴近实际可用能力,但和其他模型只走统一推导路径相比,并非完全同条件。
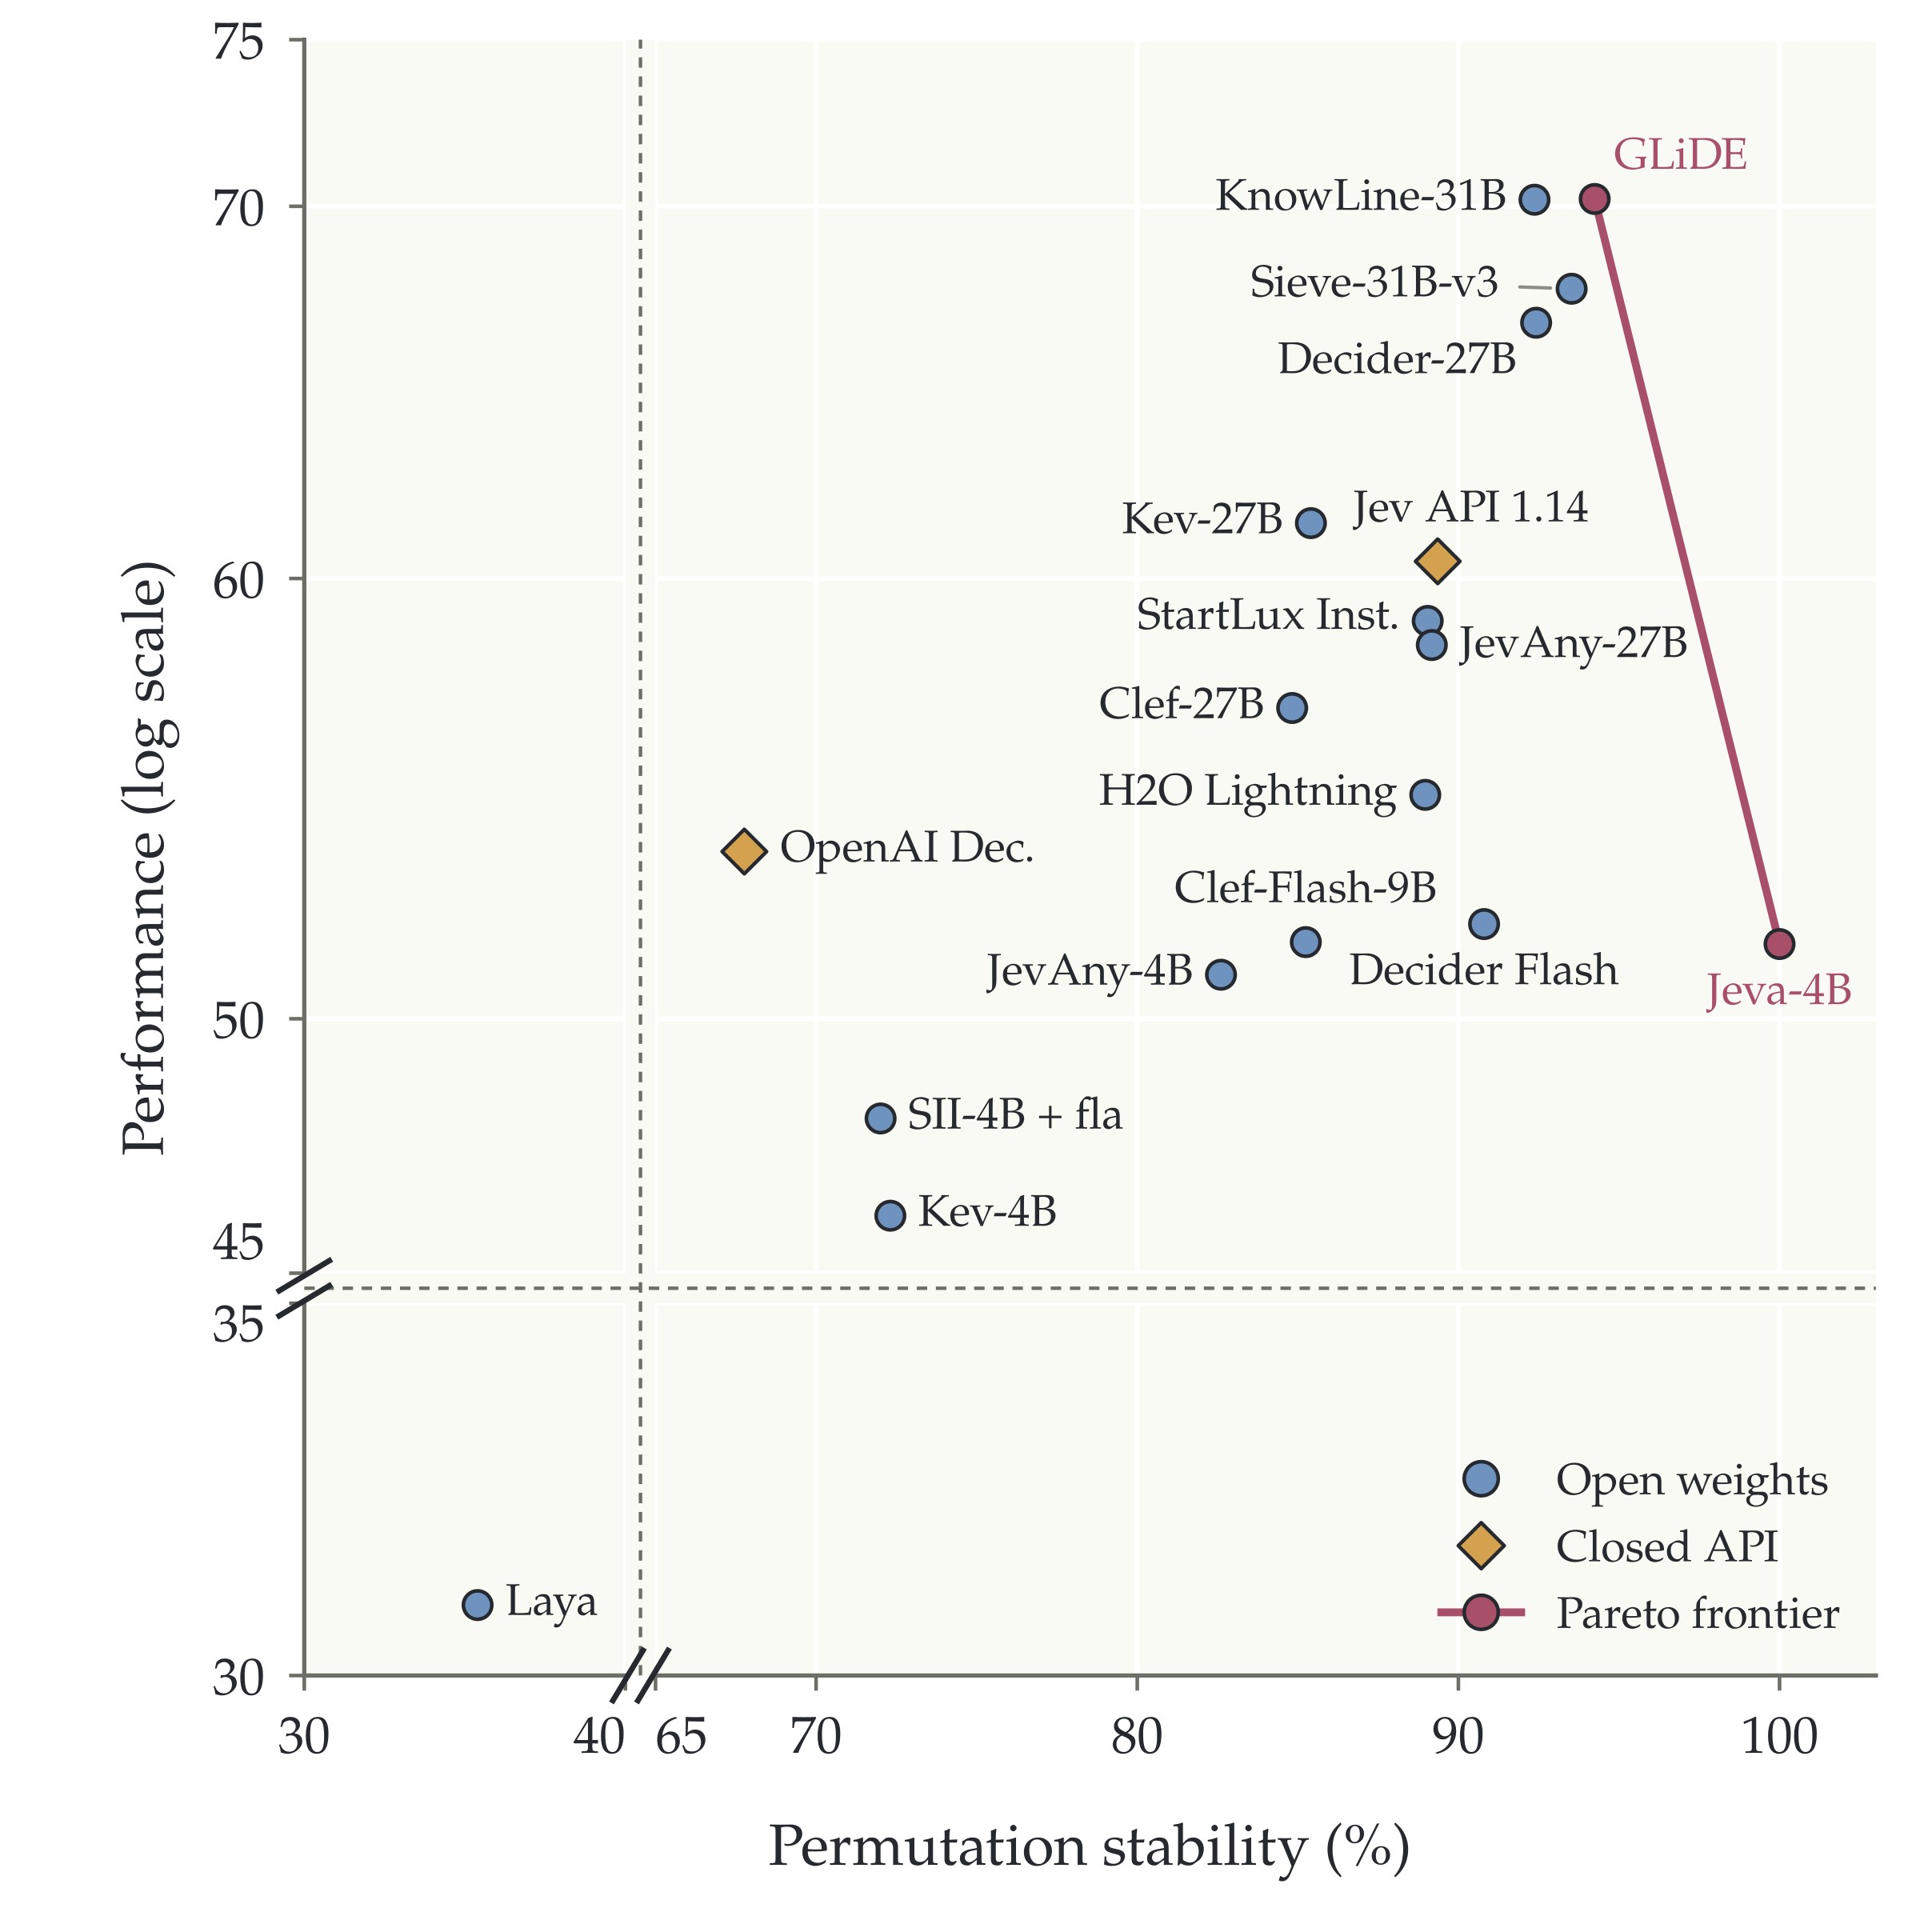
图2b:Jeva-4B 因架构设计处在 100% 顺序稳定性的最右端,但能力分只有 51.6;GLiDE 以约 70.2 分和约 94% 稳定性构成另一端。稳定性的 Pareto 前沿不等于完整可靠性排名,因为这里没有纳入 Null 识别。
哪些任务能省掉思考,哪些真省不掉
作者把 GPT-6 Luna 与两档代表模型 GLiDE 27B、StartLux Instant 4B 放到 Medium 和 Hard 任务上比较,并额外控制 StartLux Auto 的思考开关。结果分成了很清楚的三组。
| 任务类型 | 领域 | GLiDE 相对 Luna | StartLux Instant 相对 Luna | 更大/更新骨干的平均增益 | 始终思考的增益 |
|---|---|---|---|---|---|
| 直接语义判断 | 知识与常识 | 高 5.0 | 低 1.5 | 4.4 | 3.0 |
| 直接语义判断 | 情绪与情感 | 高 4.8 | 高 3.0 | 3.4 | 低 2.2 |
| 直接语义判断 | 检索与重排 | 低 5.8 | 低 8.2 | 3.9 | 1.8 |
| 细粒度落地判断 | 意图与路由 | 高 0.1 | 低 8.9 | 12.0 | 2.0 |
| 细粒度落地判断 | 安全 | 高 4.0 | 低 7.1 | 16.2 | 3.4 |
| 细粒度落地判断 | 完成验证 | 高 0.9 | 低 22.9 | 17.4 | 7.3 |
| 细粒度落地判断 | 工具与 API | 低 3.6 | 低 11.2 | 25.6 | 2.6 |
| 细粒度落地判断 | 网页交互 | 高 3.1 | 低 28.8 | 23.9 | 1.8 |
| 多步推导 | 数学 | 低 26.7 | 低 38.3 | 14.4 | 41.7 |
| 多步推导 | 科学推理 | 低 21.3 | 低 27.3 | 8.3 | 12.0 |
| 多步推导 | 代码理解 | 低 25.7 | 低 26.4 | 7.7 | 5.7 |
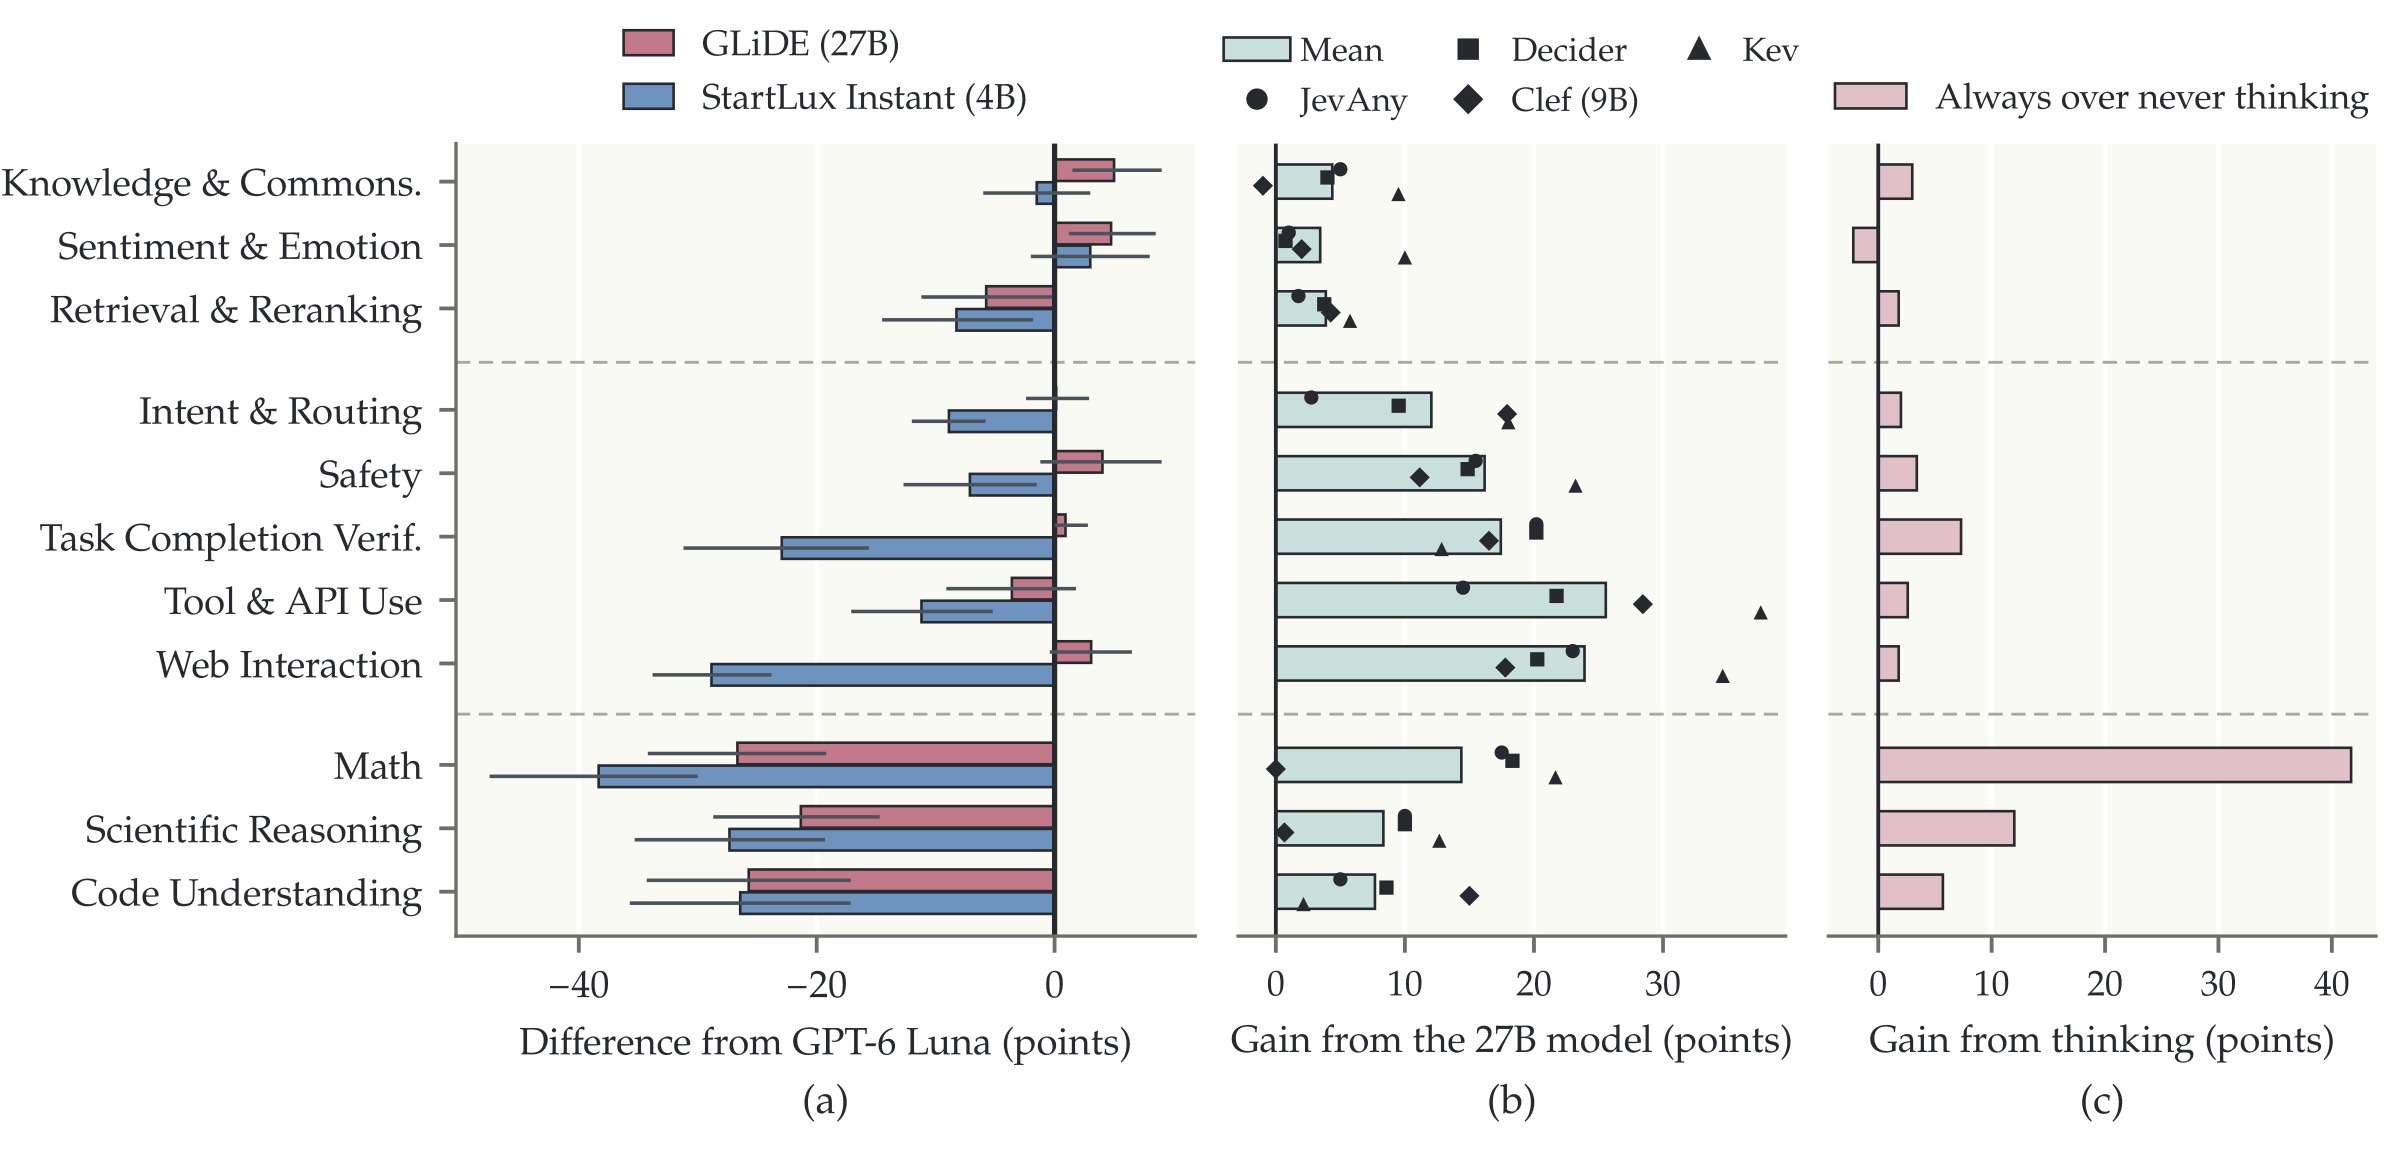
图7a:GLiDE 和 StartLux Instant 相对 Luna 的分领域差距及 95% 置信区间。图7b:四个模型家族从小模型到 27B 新骨干的增益。图7c:StartLux Auto 始终思考相对从不思考的增益,数学一项远超其他领域。
数学最有戏剧性。StartLux Auto 从不思考时的 50.8 分,始终思考后变成 92.5,提升 41.7 个点,接近 Luna 在这一切片上的 100 分。科学推理从 58.7 到 70.7,代码理解只从 55.7 到 61.4。思考不是统一加 Buff,它主要补多步推导的洞。
工具、网页和完成验证则更依赖骨干。四个家族从较小的 Qwen3.5 骨干升级到较新的 Qwen3.8-27B 后,工具使用平均涨 25.6 点,网页交互涨 23.9 点;同一模型始终思考带来的收益却只有 2.6 和 1.8 点。遇到这种问题,换一个更会读状态和约束的骨干,可能比单纯让它多想一会儿更有用。
说实话,这组结果比“System One 能否取代 System Two”的粗糙争论有信息量多了。知识、情绪、检索上可以直接用快速判断;数学和科学需要推理;工具与网页则更像细粒度状态理解问题。路由策略应该按任务类型设计,而不是给所有请求套同一个 thinking 开关。
没有训练消融,诊断实验反而揭出两个例外
这是一篇基准论文,没有常见的模块移除式训练消融。作者用难度切片、思考控制和可靠性分解替代消融,其中 Hard-only 复核很值得看。
在只保留 Hard 的分析中,数学思考增益从 41.7 升到 52.9,工具与网页的骨干增益依然达到 26.2 和 21.5,主结论很稳。意图路由的骨干增益却从 12.0 降到 4.9;完成验证更夸张,骨干增益从 17.4 降到 3.8,思考增益从 7.3 变成负 15.0。
等等,思考怎么还把完成验证做差了?
我不会急着给“思考有害”下结论。这个 Hard 层只有 20 道题,变化非常容易受少量样本影响;而且 Auto、Never、Always 的运行带有采样,静态题和交互题与原运行的一致率分别约 92% 和 90%。这个例外足以说明,不能只看 Medium+Hard 的平均故事,还不足以证明普遍的负效应。
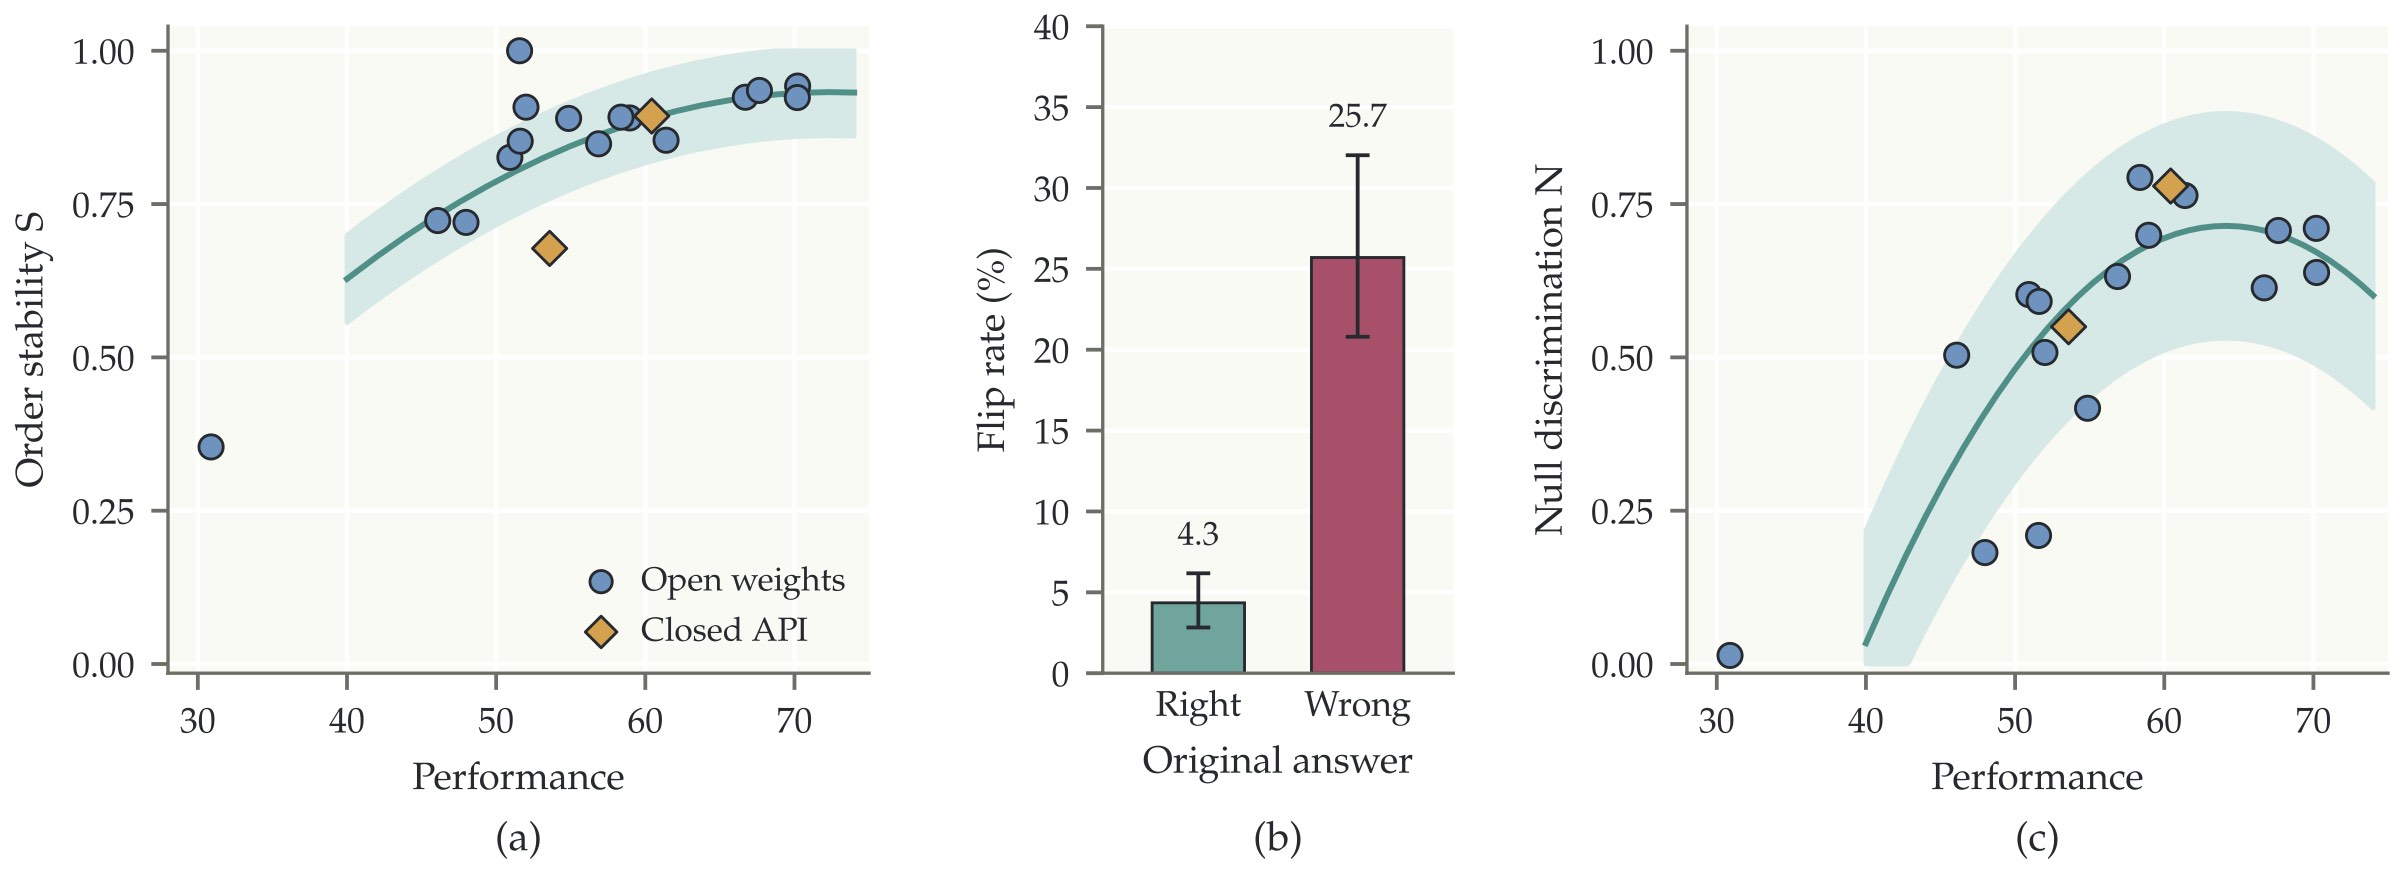
图8a:S 随能力分上升,拟合带较窄。图8b:模型原本答对时,重排翻转率中位数为 4.3%;原本答错时为 25.7%。图8c:N 与能力的关系松散得多,同分模型之间的差距很大。
原本答错时 25.7% 的重排翻转率,对比答对时的 4.3%,很符合直觉:模型真正理解并有把握的答案更稳定,瞎猜的答案更容易被位置牵着走。但这不表示所有稳定性都等于能力。Null 识别的拟合带半宽为 0.18,顺序稳定性只有 0.07;能力分能粗略预测后者,却很难替你判断前者。
作者还用 2,000 次重采样检查了 12 组配对:Kev-27B、Jev API 1.14、JevAny-27B 每一个都在 Null 识别上超过 GLiDE、KnowLine-31B、Sieve-31B-v3、Decider-27B 每一个,差值的 95% 区间都高于零。这个补充让“高分模型未必会发现无解”不只是散点图上的视觉印象。
我对 SO-Arena 的判断
这套基准最扎实的贡献,是把“能力谱”和“决策可靠性”变成了可分别测量的对象。领域内难度分层让总分之外的下滑曲线可见,网页与工具环境补上了静态判断缺少的执行维度,Null 实验则抓住了一个非常实际、又经常被准确率掩盖的失败。
第二个优点是对协议不太遮遮掩掩。作者交代了不同模型的默认设置、H100 与 API 延迟的差别、拒答如何计分、Jeva 稳定性的构造来源,也报告了小样本 Hard 切片中结论发生变化的地方。这些细节让榜单更容易被正确解读。
问题也很清楚。难度层级来自不同来源和规则,层级变化混合了任务复杂度与数据分布变化;不能把下滑全归因于“难度本身”。排行榜最高层只有 1,232 题,完成验证更只有 20 题,等权设计会让这个领域的随机波动影响总分。System Two 参照使用 medium effort,System One 与 API 又各自采用开发者推荐路径,这更接近实际产品横评,不是计算预算严格对齐的模型科学实验。
可靠性也还不是完整的生产可靠性。选项重排和缺失答案都很重要,但校准误差、长上下文干扰、提示注入、工具返回异常和多步误差恢复仍需要别的测试。同期关于 Jev 风格模型的扰动审计已经开始研究校准、跨问题干扰和解释忠实度,说明这张可靠性拼图还有不少空位。
如果你正在给 Agent 选决策模型
别从总榜第一名直接下单。先把线上请求按 SO-Arena 的三组任务切开:知识与情绪类可以优先看低延迟单 pass;工具和网页类重点比较强骨干的状态理解;数学、科学等多步推导则保留 System Two 或按需思考通道。
验收时至少加两项自己的小实验。随机重排真实工具或候选项,检查答案是否保持;构造确实没有可选项的请求,看模型能否把 Null 概率顶上去。不要只测“正确项永远存在”的测试集,那种测试集会把最关键的拒判能力藏掉。
还有一点很实际:监控 P99,不要只看平均延迟;记录拒答和上下文超限,也不要把它们从成功率分母里删掉。SO-Arena 对 OpenAI Decisions 的案例就显示,安全分类里的有害上下文、患者页面里的敏感信息都可能触发拒答。模型没有返回答案,在业务上就是失败,不是一条可以忽略的数据。
回到开头那两个问题。换顺序后不改答案,只说明模型不太受位置影响;发现正确项消失,才说明它知道自己面对的问题已经变了。SO-Arena 把这两件事从能力分里拆出来,我觉得这才是它最值得被后续基准继承的地方。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我