数学训练数据不该被打散:TOME-Math 用教材结构提升证明能力
一堆数学 QA 和一本数学教材,差别只在排版吗?
你想想看,一本《抽象代数》不会把“群的定义”“拉格朗日定理”和一道综合证明题随机撒在不同章节。定义先出现,引理为定理铺路,证明里省掉的小步骤又往往正是学习者最需要补的地方。可到了模型训练管线里,这些内容常常被压成互不相干的 problem → solution 对,章节顺序、定理依赖、证明出处全被抹平。
TOME-Math 想保住的,正是这些通常会消失在数据清洗里的关系。说实话,我一开始把它当成了又一篇“大规模数学数据集”论文;看到受控课程学习实验后才改了判断:规模只是外壳,真正值得读的是它把教材组织方式变成了可实验、可消融的训练变量。
核心摘要
TOME-Math 从 2,118 本大学数学教材提取 380,292 条证明监督,覆盖 29 个学科,同时保留章节顺序、命题—证明链接、依赖引用和来源位置。全量数据微调 Qwen3-30B-A3B-Base 后,六项评测的非加权均分从 29.17% 提到 45.83%,增加 16.66 个点;结构检索把 TOME-LongForm pass@1 从 13.25% 提到 17.38%。它不是新的推理算法,而是一套数据构建与训练组织方案。亮点是受控实验做得比较扎实,短板也很清楚:自然语言证明依赖模型评审,公开基线并非 token 对齐,全量对比不能单独证明“结构”的因果贡献。
论文信息
- 标题:Scaling Mathematical Proof Supervision from Structured Textbooks
- 作者:Youqing Fang、Zhouqi Hua、Yinhao Tang、Yuzhe Gu、Lingkai Kong、Bin Liu、Weiming Zhang、Kai Chen、Yanan Sun、Wenwei Zhang
- 机构:University of Science and Technology of China、Fudan University、Shanghai AI Laboratory、Shanghai Jiao Tong University
- 版本:arXiv v1,2026 年 10 月 29 日提交
- 论文链接:https://arxiv.org/abs/2610.40394
- 项目主页:https://tome-math.github.io/

图1:传统管线把多种来源压成孤立 QA;TOME-Math 则沿着“结构化教材—结构化 QA—结构化语料”的路径保留章节与证明关系。右侧给出 2,118 本教材、29 个学科、380,292 条 QA,以及六项评测均分约 16.7 个点的提升。
一、被抹平的不是格式,而是证明所需的上下文
数学指令数据的主流单位很简单:一道题,一份解答。这个抽象方便混合、去重和训练,却不天然适合大学数学证明。
一道定理证明通常至少连着三类上下文:它位于哪一章,依赖哪些前置命题,原证明省略了哪些局部推导。孤立 QA 可以保留题面和答案,却不一定保留这些关系。模型看到的是“结论与示范”,看不到“为什么此时该学这个结论”。
TOME-Math 的全称是 Textbook-Oriented Mathematical Evidence。作者把结构拆成三层:
| 结构层 | 保留的信息 | 能支持的用法 |
|---|---|---|
| 层级结构 | 教材、章节、命题及其先后顺序 | 按教学进度组织训练 |
| 依赖结构 | 定理证明与局部证明缺口、前置命题的链接 | 检索证明所需证据,补足局部推理 |
| 课程结构 | 章节进度与 Gap / Non-gap 的呈现顺序 | 控制 Forward、Reverse、Shuffle 等训练计划 |
这条路线和已有数学数据资源并不完全在同一条赛道上。
| 资源 | 论文中报告的规模 | 主要监督单位 | 保留的结构 |
|---|---|---|---|
| MetaMathQA | 395K QA | GSM8K、MATH 的增广解答 | 种子与增广类型 |
| OpenMathInstruct-2 | 14M QA | 问题—解答 | 来源标签 |
| NuminaMath-CoT | 约 860K QA | 多来源问题与 CoT 解答 | 来源标签 |
| MathPile | 9.5B tokens | 预训练文本 | 来源与文件路径 |
| NaturalProofs | 32K proofs | 自然语言证明 | 引用图 |
| TOME-Math | 380,292 QA | 自然语言命题证明与局部证明 | 章节、引用、出处、课程顺序 |
OpenMathInstruct-2 的研究已经说明,问题多样性、教师模型与解答格式会影响数据扩增收益;NaturalProver 则证明,给模型提供定理和定义等背景引用有助于自然语言证明。TOME-Math 更像是把两种观察接到一起:不只扩大 QA,也不只在推理时检索引用,而是把教材本身的组织关系一路保留到训练阶段。
所以,我不认为“从教材抽数据”本身有多新。真正拉开差异的是后面那组实验:同一份样本、同一份 token 预算,只换顺序,成绩会变多少?
二、TOME-Math 怎么从 PDF 变成证明监督
2.1 先恢复书,再抽取题
整条管线不是直接对 PDF 做“题目识别”,而是先恢复教材结构。

图2:左侧依据大学课程大纲和专家筛选确定教材,DeepSeek-OCR 输出多模态 Markdown 与页面图;中间用 gpt-oss-120b 恢复目录、切分章节并分离练习;右侧抽取命题证明、检测证明缺口,再做五维质量审核。
具体流程可以顺着一条样本走一遍:
- DeepSeek-OCR 把教材 PDF 转成多模态 Markdown 和页面图片。
- gpt-oss-120b 逐页识别目录与正文,重建层级目录。状态机再判断每页属于当前章、下一章,还是包含章节边界;模糊边界会重试。
- 章节内容被拆成核心讲解与原生练习。练习进入独立题库,不进入 Proof QA 生成路径,后来可用于书本级留出评测。
- gemini-3.1-flash-lite-preview 抽取 theorem–proof、lemma–proof、definition–proof 单元,并找回理解证明所需的前置命题。
- gemini-3-flash-preview 在开启 thinking 的配置下检查证明缺口,再由 gemini-3.1-flash-lite-preview 把缺口改写成自包含命题并补全证明。
这里的“缺口”不是随便删一句话让模型填空。附录列出的检查对象包括未验证的引理假设、省略的坐标或算子变换,以及“显然”“易见”后面没有支撑的跳跃。候选缺口还要声明符号、补入必要定义,尽量变成脱离原页也能回答的局部证明题。
这就是 Proof QA 与 Gap QA 的分工:Proof QA 学习书上写出来的证明,Gap QA 补上书里没有展开、但理解证明必须跨过去的台阶。
2.2 数据不少,但 Gap QA 的生成损耗很大
完整语料有 205,861 条 Proof QA 和 174,431 条 Gap QA。两者相加正好是 380,292 条。

图3:2,118 本教材最初产生 489,162 条 Proof QA 与 918,235 条 Gap QA 候选,过滤后分别剩下 205,861 和 174,431 条。Gap QA 的保留率只有 19.00%,也说明“发现缺口”远比“生成可用缺口”容易。
这个 19.00% 很值得盯住。它一方面说明质控确实筛掉了大量候选,另一方面也提醒读者:38 万条不是低成本、无损地从教材“倒出来”的,而是多模型生成与过滤后的产物。
质控分两层。结构检查负责目录层级、页边界、跨页连续性、问答对齐和自包含性;语义审核由 source-conditioned 的 gpt-oss-120b judge 完成,检查完整性、准确性、LaTeX 格式、自包含性和原子性。准确性是硬失败项:原资料不支持的新证明步骤、被改动的数学关系,都不能被当成文风问题放过。
坦率地讲,这套审核比只查格式完整要认真,但它仍然不是 Lean 编译器。通过模型审核,不等于证明获得形式化验证。这个区别在后面读实验分数时同样重要。
三、全量训练:六项均分涨 16.66 个点,但别只看一个平均数
3.1 训练与评测设置
所有模型都从 Qwen3-30B-A3B-Base 出发,只更换 SFT 语料。完整 TOME-Math 有 380,292 条记录、195.18M tokens;为避免来源泄漏,作者预留 64 本教材,删除对应的 15,661 条训练记录,实际训练集剩 364,631 条、约 170.92M tokens。
| 配置项 | 设置 |
|---|---|
| 优化器 | AdamW,\(\beta_1=0.9\)、\(\beta_2=0.95\),weight decay 为 0.1 |
| 学习率 | \(8\times10^{-5}\),3% warmup 后余弦衰减至 \(8\times10^{-6}\) |
| 序列长度 | 131,072 tokens,全局 packing |
| 等效 batch size | 64;每 GPU micro-batch 为 1,梯度累积为 4 |
| 训练轮数 | 每个语料各训练 1 个 epoch |
| 硬件 | 16 张 NVIDIA H200,2 个节点 |
评测包含两类自建集和四个公开基准。TOME-LongForm 有 300 道来自留出教材的长答案题,六个学科各 50 道,其中 227 道是证明题;TOME-Objective 有 145 道客观题。公开部分是 MiniF2F、ProofNet、MATH-500 和 AIME 2026。
长证明每题采样 16 份回答,每份回答接受 gpt-5.6-luna 的八次独立评审,只要有一次发现实质错误就拒绝。作者还用 600 份人工标注回答校准评审器,整体人机一致率为 85.9%,错误接受率为 8.7%,错误拒绝率为 18.1%。这个设计偏保守,能减少“错证明被放行”,也会误伤一部分正确证明。
pass@k 使用常见的无偏估计:
其中 \(n\) 是每题采样数,\(c_i\) 是第 \(i\) 题被接受的回答数。后面的课程实验用 pass@16,主表用 pass@1,两者不能直接横着比。
还有一个容易踩的读数陷阱:这里的 MiniF2F 和 ProofNet 评测的是自然语言证明,由 LLM 按相应官方评测流程改造后的提示词打分,不是把证明交给 Lean 编译。看到 MiniF2F 就自动理解成形式化证明通过率,会把结论读偏。
3.2 主实验完整结果
| SFT 语料 | TOME-LF | TOME-Obj. | MiniF2F | ProofNet | MATH-500 | AIME-26 | 六项均分 |
|---|---|---|---|---|---|---|---|
| 无 SFT | 13.25 | 32.93 | 34.45 | 17.14 | 68.80 | 8.44 | 29.17 |
| OpenMath1,1.82M | 20.16 | 33.86 | 22.87 | 19.25 | 70.40 | 8.21 | 29.13 |
| MetaMath,395K | 28.73 | 34.66 | 40.70 | 22.55 | 71.20 | 9.98 | 34.64 |
| MathInstruct,262K | 35.87 | 40.69 | 52.05 | 32.93 | 73.05 | 11.98 | 41.10 |
| TOME-Math,364.6K | 43.86 | 43.96 | 57.43 | 42.98 | 76.55 | 10.19 | 45.83 |
表1:数值均为百分比,六项均分是简单算术平均。TOME-Math 在五项上排名第一,AIME 2026 上排第二。
最有冲击力的不是 16.66 这个总提升,而是证明任务上的差距。相对最强的公开基线 MathInstruct,TOME-LongForm 从 35.87 提到 43.86,增加 7.99 个点;ProofNet 从 32.93 提到 42.98,增加 10.05 个点。MATH-500 也从 73.05 提到 76.55,说明收益没有只停留在自建证明集。
OpenMath1 那一行也很耐人寻味:1.82M 条样本约为 TOME-Math 训练集的 4.8 倍,六项均分却比未训练基线还低 0.04 个点,MiniF2F 还从 34.45 降到 22.87。数据量不是一张可以单独兑现的支票。
但等等,全量对比能证明“教材结构的作用”吗?不能。
这些语料不仅结构不同,题材、答案风格和 token 数也不同。OpenMath1 是 368.00M tokens,MetaMath 是 96.94M,MathInstruct 是 64.10M,TOME-Math 是 170.92M;每个语料训练一轮,计算量并未对齐。两个自建 TOME 评测又占总平均的三分之一,天然更贴近训练分布。作者自己在正文中也明确承认,这组对比不能单独隔离结构的因果作用。
AIME 2026 更不适合拿来下强结论。它只有 30 道题,TOME-Math 的 10.19 低于 MathInstruct 的 11.98,且 10.19 对应的置信区间平均半宽为 8.75。真要说“竞赛数学也全面提升”,证据不够。
四、结构检索:同样的上下文预算,挑对证据多拿 4.13 个点
作者先做了一项不更新参数的实验,直接测试保留的章节和依赖关系能不能帮模型找资料。
五种条件都使用冻结的 Qwen3-30B-A3B-Base。Closed 不给外部材料;Random Same-Book 从原书随机取内容;Local Chapter 只看当前章及紧邻前章;TOME Props Only 按章节位置和命题依赖检索;Props + Gap 再把局部证明缺口加入候选池。所有增强条件共享上下文 token 预算,目标题及与参考答案重叠的材料都会移除。
| 上下文策略 | 均分 | 抽象代数 | 微分几何 | 离散数学 | 数学分析 | 概率 | 拓扑 |
|---|---|---|---|---|---|---|---|
| Closed | 13.25 | 8.50 | 5.25 | 13.25 | 25.75 | 20.00 | 6.75 |
| Random Same-Book | 14.00 | 9.75 | 6.50 | 12.50 | 24.75 | 20.50 | 10.00 |
| Local Chapter | 14.71 | 10.50 | 6.75 | 14.50 | 25.50 | 20.00 | 11.00 |
| TOME Props Only | 15.54 | 11.00 | 8.50 | 15.00 | 27.25 | 20.50 | 11.00 |
| TOME Props + Gap | 17.38 | 12.75 | 10.00 | 15.25 | 31.75 | 21.75 | 12.75 |
表2:TOME-LongForm 上 300 道题的 pass@1。所有方法在相同学科、相同题目上配对比较。
从 Closed 到 Props + Gap 增加 4.13 个点,其中 Gap QA 在命题检索之上又贡献 1.84 个点。完整策略在六个学科都优于 Closed;随机同书内容却会让离散数学和数学分析略微下降。
这个结果很符合工程直觉:上下文不是越多越好,附近文本也不等于可用证据。证明卡住时,真正有帮助的往往是“这个结论依赖哪条引理”以及“被省略的那一步怎么补”。
不过,检索池限定在题目原书内,而且使用了来源书、章节和依赖元数据。它更像“知道答案出自哪本书后的结构化开卷证明”,还不能直接外推成跨千万文档的开放域数学 RAG。
五、课程学习:真正拉开差距的是章节方向
这块是我觉得全篇最值钱的地方。
作者把每本书的章节位置归一化后分成十个阶段。不同书在同一阶段内交错出现,避免强行规定“A 书必须排在 B 书前面”。随后构造四种只改呈现顺序的计划:
| 训练计划 | 章节方向 | 每阶段内部顺序 |
|---|---|---|
| Shuffle | 全局打乱 | 全局打乱 |
| Forward–Gap | 从教材前部到后部 | Gap 先于 Non-gap |
| Reverse–Gap | 从教材后部到前部 | Gap 先于 Non-gap |
| Forward–Mix | 从教材前部到后部 | Gap 与 Non-gap 混合 |
实验覆盖六个学科,每个学科分别训练,预算为 0.75M、1.8M 和 2.4M tokens。相同学科与预算下,四种计划使用完全相同的 QA ID、来源书、实际 token 数、初始化和优化参数。数据加载器随机打乱、序列 packing 和按长度分组都关闭,防止预设顺序被训练框架悄悄破坏。
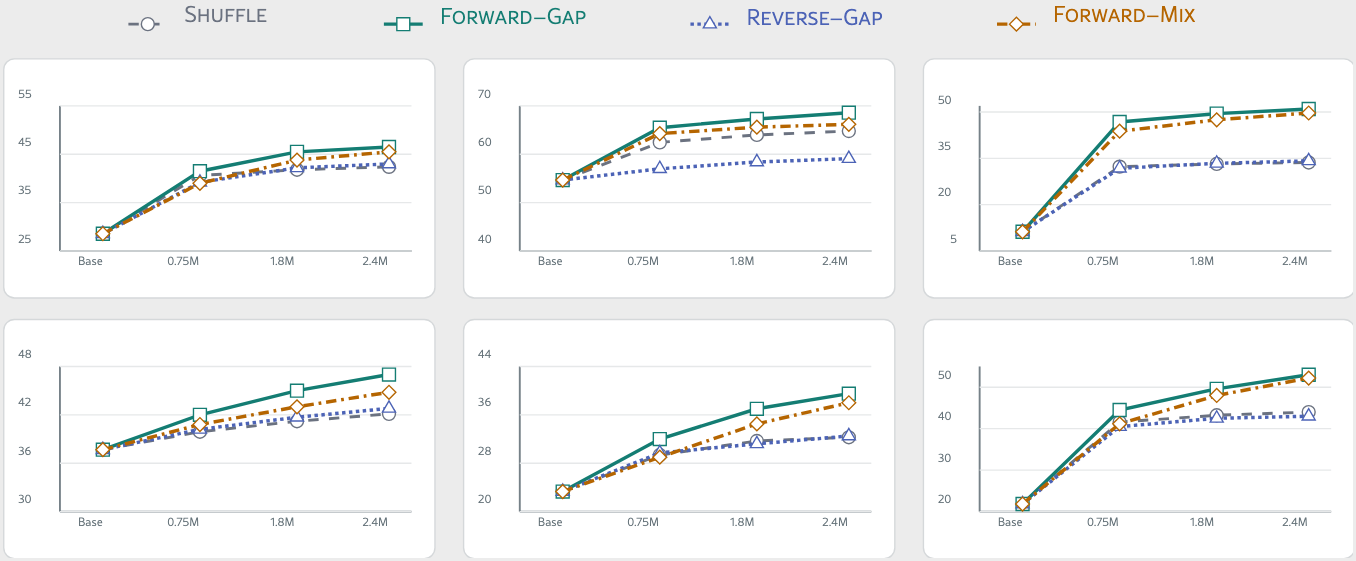
图4:六个面板按从左到右、从上到下依次对应离散数学、数学分析、抽象代数、概率论、微分几何和拓扑。绿色实线 Forward–Gap 在全部 18 个“学科 × 预算”组合中最高;指标为 pass@16。
| 训练计划 | 0.75M tokens | 1.8M tokens | 2.4M tokens |
|---|---|---|---|
| Shuffle | 41.04 | 42.52 | 43.21 |
| Forward–Gap | 45.38 | 48.98 | 50.93 |
| Forward–Gap 相对 Shuffle 的增益 | 4.34 | 6.46 | 7.72 |
表3:六学科 pass@16 的宏观平均。所有计划都随规模上升,但结构化顺序的收益没有随预算增加而消失,差距反而扩大。
更细的对照把两个因素拆开了。Forward–Gap 相对 Reverse–Gap 在三档预算下分别高 5.65、7.41 和 8.50 个点,说明章节正向推进是主要贡献;相对 Forward–Mix 则分别高 2.37、1.91 和 1.53 个点,说明 Gap-first 有帮助,但作用较小且随规模减弱。
这个拆分比一句“课程学习有用”有信息量得多。真正关键的是先学前置知识,再学后续命题;不是把 Gap QA 机械地塞到每个 batch 前面就万事大吉。
六、同样的 token,撒到更多教材上更好
课程实验里,预算变大时教材数也从 8 本增到 16 本、24 本,数据量与来源广度绑在一起。作者又做了一项固定 0.75M tokens 的对照:Narrow–dense 只用 8 本书,Broad–sparse 把相同预算摊到 16 本书。
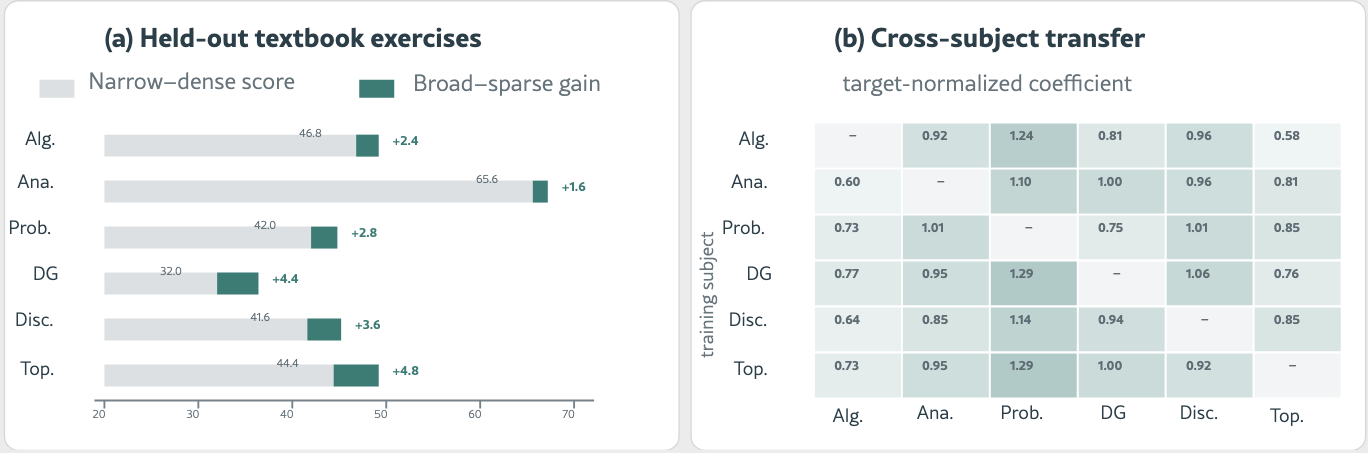
图5:左图灰段是 8 本教材的 Narrow–dense pass@16,绿段是改成 16 本教材后的增量;右图每行是训练学科、每列是目标学科,数值经过目标学科专家模型归一化。
| 学科 | Narrow–dense | Broad–sparse 增益 |
|---|---|---|
| 抽象代数 | 46.8 | 2.4 |
| 数学分析 | 65.6 | 1.6 |
| 概率论 | 42.0 | 2.8 |
| 微分几何 | 32.0 | 4.4 |
| 离散数学 | 41.6 | 3.6 |
| 拓扑 | 44.4 | 4.8 |
表4:固定 token 预算时,拓宽到两倍教材在六个学科都带来收益,平均增加 3.3 个点。
跨学科部分使用 0.75M-token Forward–Gap 专家模型,并计算目标归一化迁移系数:
\(P_{s\rightarrow t}\) 是用学科 \(s\) 训练的模型在学科 \(t\) 上的 pass@16,分母是目标学科专家模型的成绩。系数大于 1,表示外来学科模型甚至超过目标学科专家模型。
30 个有序跨学科组合的平均系数为 0.92,8 个组合超过 1.0。拓扑和微分几何作为训练来源时,来源侧均值分别达到 0.98 和 0.97;二者迁移到概率目标时都达到 1.29。
看到这个数我有点意外,但也保留一点疑问:这些学科共用证明习惯与数学语言,跨学科高分不一定都来自可迁移的“推理能力”,也可能包含题型、表达风格和相近数学内容的复用。论文没有进一步拆解这几类因素。即便如此,固定预算下的来源广度对照依然很实在——做数据配比时,别只盯着总条数,来源数量本身就是一个缩放轴。
七、全量消融:Gap 数据、Gap-first、章节顺序各贡献多少
受控小实验之外,作者还在书本级留出的全量训练集上做了消融。
| 变体 | TOME-LF | TOME-Obj. | MiniF2F | ProofNet | MATH-500 | AIME-26 |
|---|---|---|---|---|---|---|
| 去掉 Gap QA,仅 Forward | 38.72 | 38.91 | 50.73 | 36.21 | 73.84 | 9.12 |
| 去掉课程顺序,Shuffle | 39.87 | 40.42 | 53.76 | 39.12 | 75.22 | 9.58 |
| 去掉 Gap-first,Forward–Mix | 40.12 | 41.37 | 55.61 | 41.02 | 75.88 | 9.93 |
| 完整 Forward–Gap | 43.86 | 43.96 | 57.43 | 42.98 | 76.55 | 10.19 |
表5:所有变体都使用相同的书本级留出训练划分,指标为 pass@1。去掉任一组件,六项分数全部下降。
去掉 Gap QA 的损耗最大。相对完整方案,TOME-LF 降 5.14 个点,ProofNet 降 6.77 个点,MiniF2F 降 6.70 个点。Gap-first 与全局章节顺序也都有贡献,但幅度更小。
这里和小规模课程实验看起来有个细微差别:小实验里章节方向是主要因素,全量消融里 Gap 数据本身的影响更突出。其实不矛盾,一个是在固定数据里重排顺序,另一个直接删掉了一整类监督。真正值得记住的是三者并非同一个开关:有没有局部证明数据、何时呈现局部证明、是否按前置关系推进,是三个不同决策。
八、我的判断:强在数据实验设计,别把它读成形式化证明突破
我觉得这篇论文最值钱的地方有三点。
教材结构被变成了可操作的变量。 章节、引用和来源不再只是 JSON 里好看的 metadata,而是能控制检索池、训练顺序和来源配比的实验旋钮。
受控对照比主表更有说服力。 同样 QA、同样 token、同样初始化,只换顺序;同样预算,从 8 本书换成 16 本书。这样的实验比单纯展示“38 万条数据打败多少模型”更能解释收益从何而来。
Gap QA 是一个实用的数据构造思路。 教材里“显然”的两字,经常恰好是模型需要学习的局部推理。把这些隐含义务显式化,比继续增广相似题目更有针对性。
问题也不能略过。
自然语言证明的正确性主要靠模型评审,八票悲观聚合虽然做了人工校准,整体错误拒绝率仍有 18.1%。这不是机器可验证证明,更不能与 Lean 编译通过率混为一谈。数据构建端同样依赖多阶段模型生成与模型审核,教材中的原有错误、OCR 错误和补证明错误能否被完全拦住,论文没有给出“零错误”的承诺。
全量公开基线没有 token 对齐,也没有统一题目来源与答案风格;TOME-Math 的主表优势很大,但不能全部记到“结构”名下。两项自建评测进入六项均分,也会放大贴近训练分布的贡献。检索实验限定原书,课程实验只覆盖六个教材资源较多的学科,跨学科迁移又缺少对内容重叠和题型相似性的分解。
还有一个工程现实:这套管线动用多种大模型做 OCR 后处理、语义抽取、缺口补全和审核,Gap 候选只保留 19.00%。附录记录的设计阶段成本参考中,单本教材的高质量命题抽取配置约 40–50 美元,混合配置约 7 美元。即便混合方案便宜很多,乘以两千多本教材,再加上失败重试与评测,绝不是“爬一批公开 PDF 就能复现”的轻量项目。
如果你在做数学训练数据,我会优先抄这三件事,而不是先照搬全部模型栈:
- 给每条数据保留可回溯的书、章、命题和来源位置,后续去重、检索与课程编排都会用到。
- 把证明中省略的局部义务单独建流,别只保存最终定理与完整答案。
- 在扩大数据前做顺序对照,至少比较 Shuffle、Forward 和 Reverse;同时按训练 token 而不是只按样本条数对齐预算。
说到底,TOME-Math 没有发明新的模型结构,也没有解决自动形式化验证。它回答的是一个更朴素、也更容易被忽略的问题:同样一批数学知识,按照人类教材已经验证过的依赖顺序教给模型,确实比全部打散更值得认真一试。
参考与延伸
- TOME-Math:https://arxiv.org/abs/2610.40394
- NaturalProver: Grounded Mathematical Proof Generation with Language Models:https://arxiv.org/abs/2205.12910
- OpenMathInstruct-2: Accelerating AI for Math with Massive Open-Source Instruction Data:https://arxiv.org/abs/2410.01560
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我