机器人不再重训:WICL 把一次演示变成可迁移的任务记忆
看过一次“把碗叠好”,换一张桌子、换一组光照、再换一台机械臂,机器人还能做出来吗?
很多训练出来的策略会在这种变化面前突然变得脆弱。 FastWAM 在 RoboTwin 2.0 干净场景里有 77.8% 成功率,打开域随机化后只剩 1.9%。这个落差挺刺眼的:模型显然学到了某些东西,但它学到的是任务,还是训练场景里的外观规律?
arXiv:2611.12885 给出的回答很干脆:别急着改权重,让冻结模型先在一个可重置的世界里练习,把练习反馈写成一份可读的 Task Memory,再带着这份记忆去新场景干活。作者把这套范式称为 World In-Context Learning,简称 WICL;具体系统叫 RoboScript。
核心摘要:WICL 针对机器人策略受训练分布束缚、普通上下文学习又缺少世界反馈的问题,让冻结基础模型从单条演示出发,在模拟器中模仿、排演、纠错,并把经验沉淀为结构化 Markdown 任务记忆。RoboScript 在 RoboTwin 2.0 全部 50 个任务上取得 83.4% 的干净/随机场景平均成功率,比每任务使用 50 条演示训练的最强动作策略高 21.7 个点。真正吸引我的不是“免训练”标签,而是它把机器人学习变成了可检查、可修改、可迁移的上下文工程;代价则是每回合数十次模型调用和分钟级等待,离实时控制还很远。
📖 论文信息
- 标题:World In-Context Learning for Agentic Robot Manipulation
- 作者:Heng Fang、Zehui Guo、Yuehan Zhang、Mingyang Du、Dingkang Liang、Xiang Bai
- 机构:华中科技大学、ArcheOne AI
- 版本:v1,2026 年 11 月 9 日提交
- 论文:https://arxiv.org/abs/2611.12885
- 代码:https://github.com/ArcheOne-AI/RoboScript
- 项目页:https://ArcheOne-AI.github.io/RoboScript
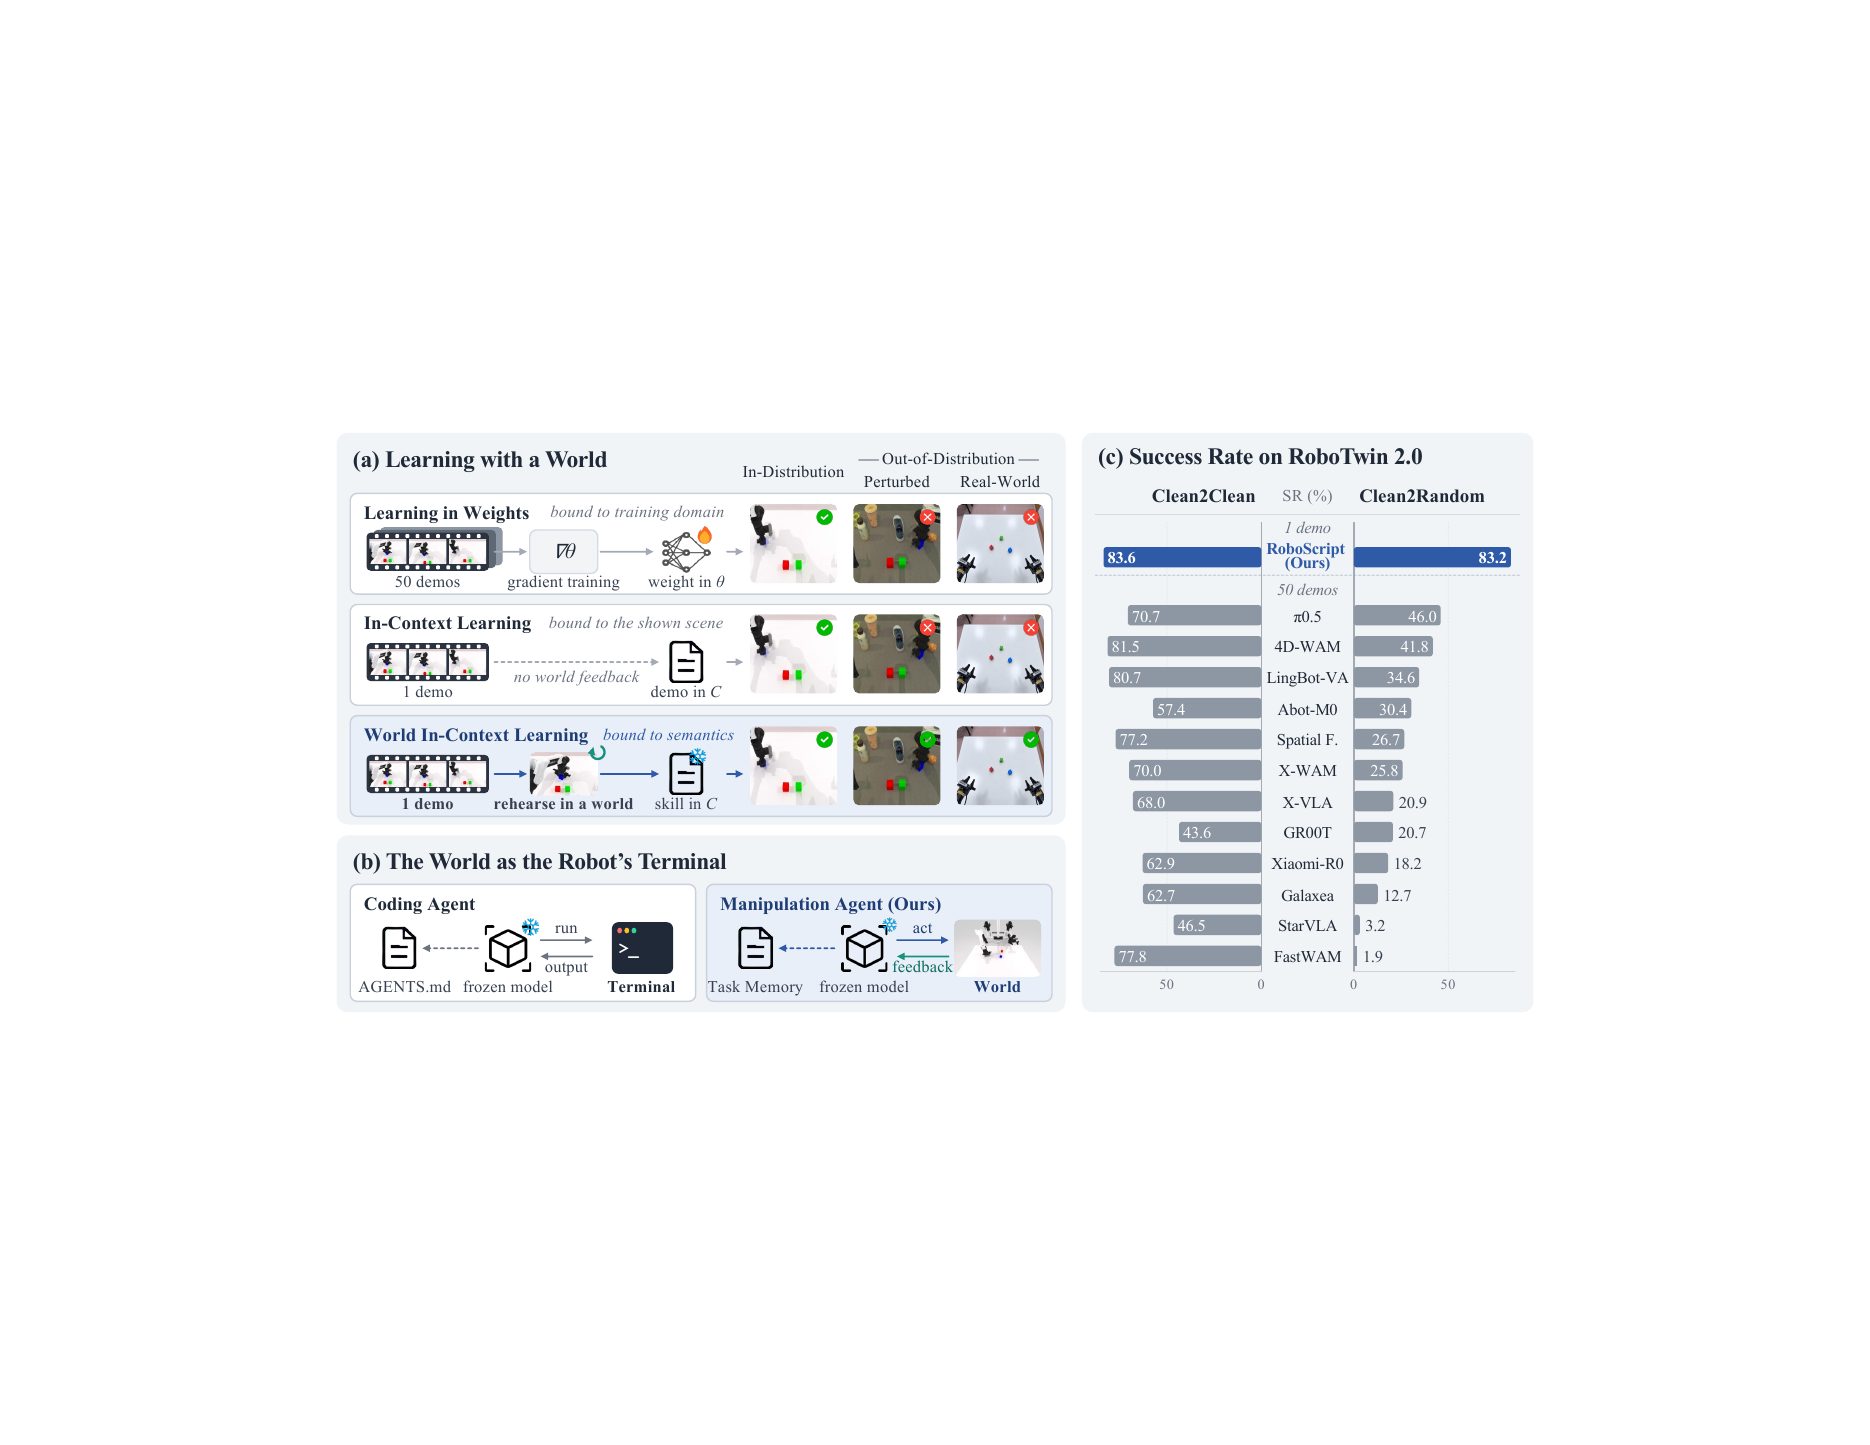
图 1:论文的概念总览与主结果。上左把三条路线放在一起:权重学习绑定训练域,普通 ICL 绑定所展示的场景,WICL 则通过世界排演把技能写进上下文。下左把模拟器类比为机器人的“终端”;右侧条形图显示 RoboScript 在 Clean2Clean 与 Clean2Random 上分别为 83.6% 和 83.2%,而图中训练策略在随机场景普遍明显下滑。
🎯 机器人缺的也许不是演示,而是“练过之后知道哪里错了”
传统 VLA 或 WAM 把技能压进网络参数。这条路已经能做出很强的策略,但数据分布变了,往往要继续收数据、再训练。普通 ICL 看起来很省:给冻结模型一条演示,让它照着做就行。可演示记录的是另一个场景,它不会告诉机器人“当前这个杯子没抓到”“这个放置角度会让手机斜着倒下”。
编程智能体在这里给了一个很直接的启发。模型面对陌生代码仓库,并不是把仓库整个背下来,而是运行代码、读终端输出、改上下文里的计划。机器人也可以有类似闭环,只不过终端变成了模拟器,报错变成了抓取落空、物体滑落、放置不满足约束。
这就是 WICL 与普通 ICL 的分界线:上下文里不只有演示,还有世界对行动的回应。
| 学习路线 | 经验来源 | 技能存放位置 | 是否更新权重 | 面对新场景的主要难点 |
|---|---|---|---|---|
| 模仿学习 / VLA / WAM | 演示数据 | 网络权重 | 是 | 容易吸收训练域的外观与物理规律 |
| 强化学习 | 世界反馈 | 网络权重 | 是 | 需要训练,仍可能绑定训练分布 |
| 普通 ICL | 上下文中的演示 | 上下文 | 否 | 演示无法提供当前世界的后果反馈 |
| WICL | 演示加世界排演反馈 | 可读写上下文 | 否 | 依赖世界保真度、模型推理与感知工具 |
这条脉络也并非凭空出现。Code as Policies 让语言模型生成机器人控制程序,VoxPoser 用模型合成三维价值图;Reflexion 把失败反思留在情景记忆里,Voyager 存可执行代码技能,ExpeL 从一批轨迹中提炼经验。WICL 更像是把这些思想接到物理操作上:把跨回合经验写成可部署记忆,并用未见实例检查它是否真的泛化。它不是第一个让机器人调用工具的框架,也不是第一个做文本反思的智能体。
🧠 WICL:参数不动,让上下文承担学习
一句话讲,WICL 把“训练集—梯度—新权重”换成“排演实例—世界反馈—新上下文”。
设基础模型为 \(\pi_\theta\),参数 \(\theta\) 全程冻结。演示 \(d\) 先被初始化为上下文 \(C_0\);模型在排演实例 \(e_k\) 上行动,世界 \(W\) 返回轨迹 \(\tau_k\) 和反馈 \(r_k\),随后模型只更新上下文:
这里初始化 \(\mathcal{I}_\theta\) 和修订 \(\mathcal{U}_\theta\) 都由同一个冻结模型完成。发生变化的是 \(C_k\),不是 \(\theta\)。排演结束后,最终上下文 \(C^\star\) 被冻结,模型只能带着它处理从未用于排演的测试实例:
这个拆分很重要。若模型反复刷同一个种子,成功率上升可能只是记住了这个场景;论文让排演集与测试集不相交,反思阶段的各评估种子块也互不重叠,测的是经验能否搬到新实例。
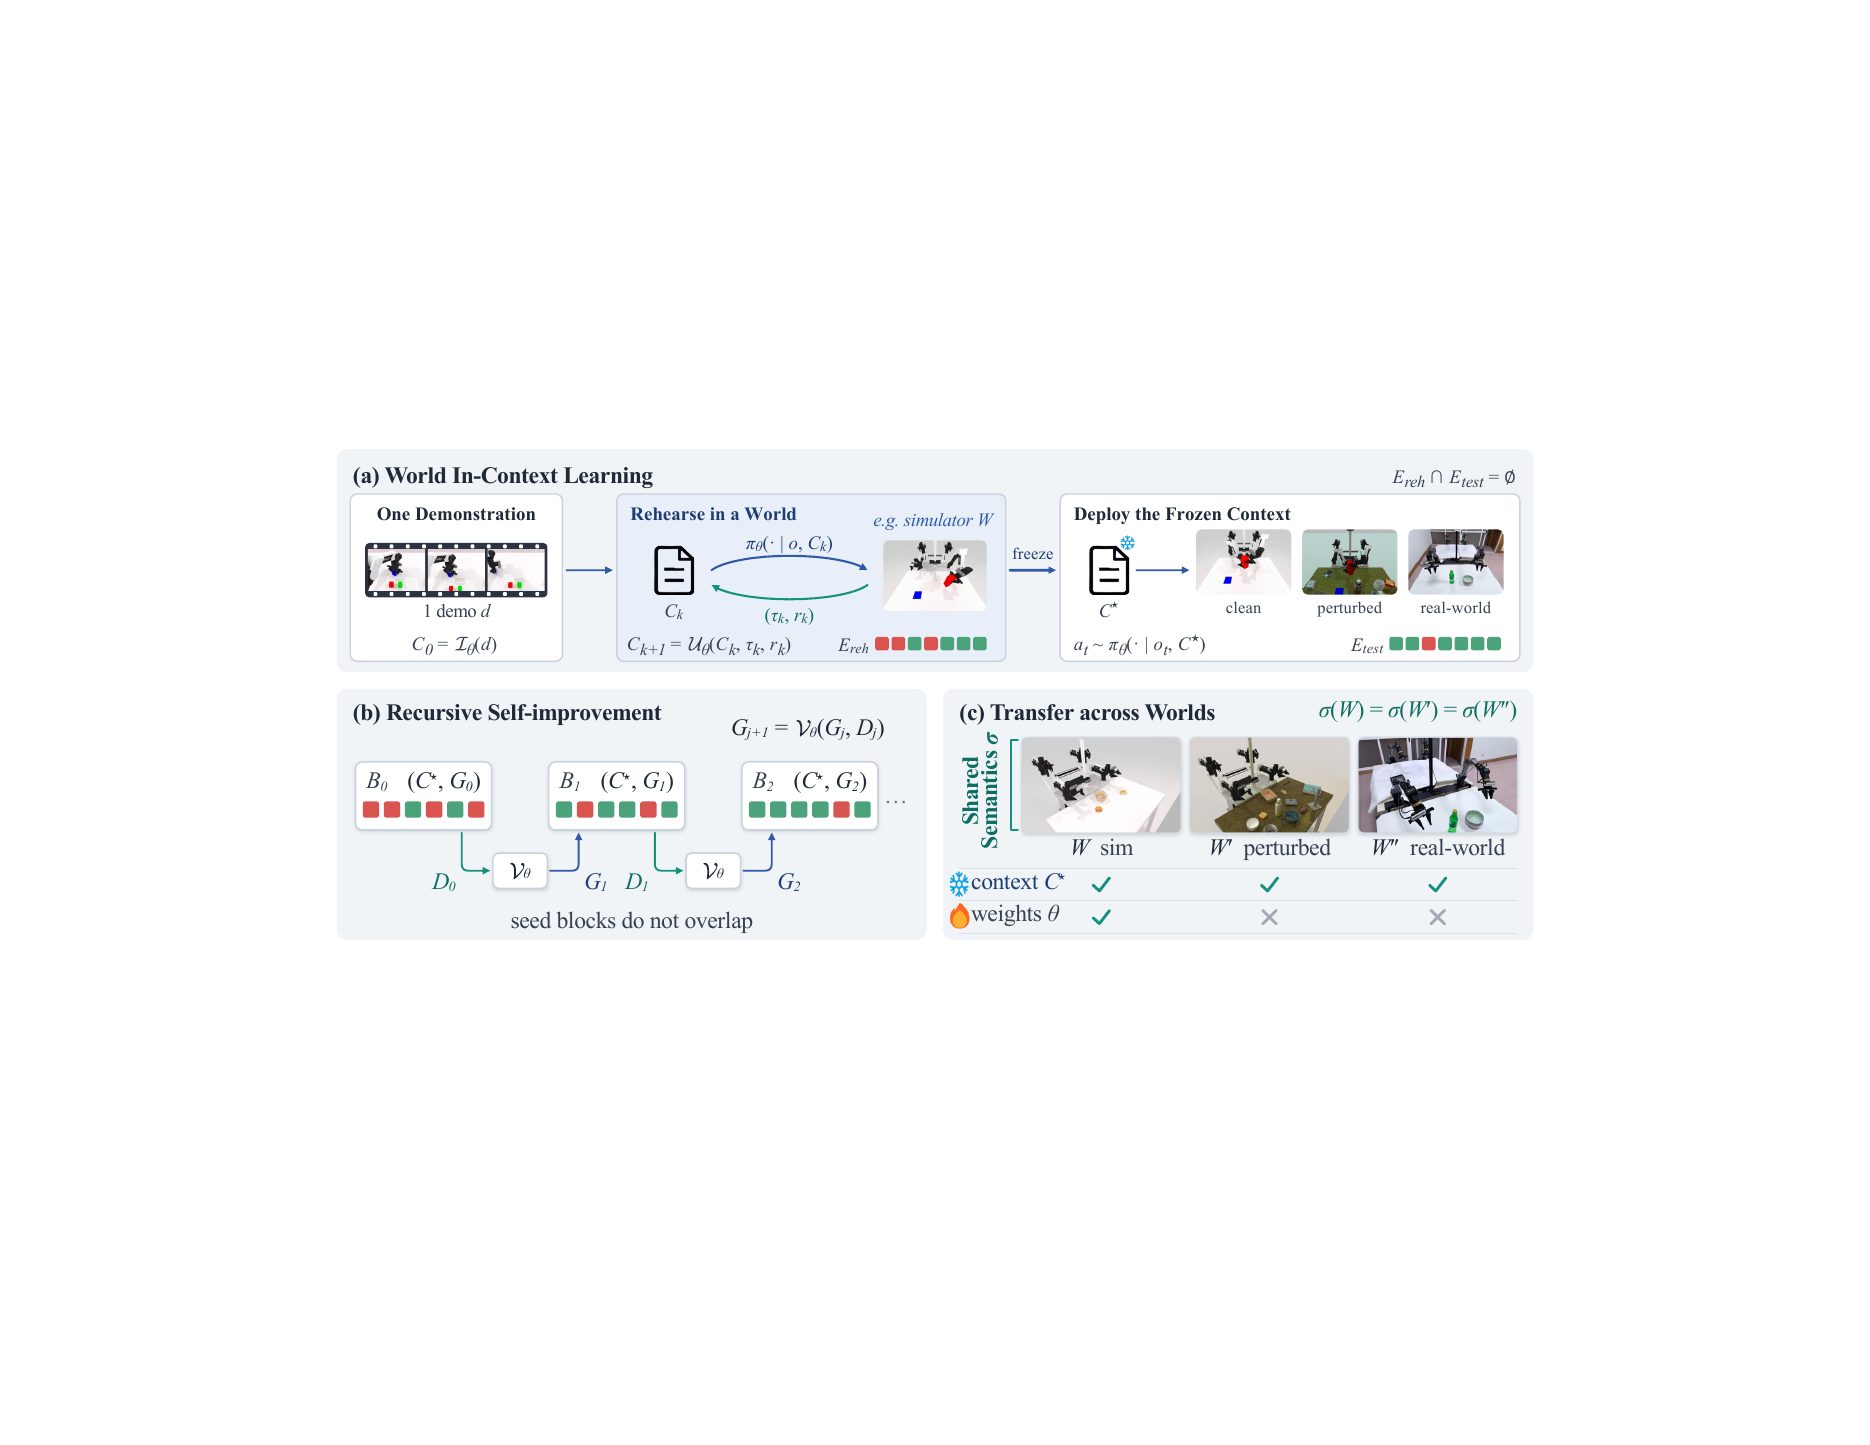
图 2:WICL 的形式化流程。面板 a 展示单条演示进入世界排演,随后冻结上下文并部署到干净、扰动和真实世界;面板 b 展示在互不重叠的种子块上反思并生成 guidance;面板 c 用 \(\sigma(W)=\sigma(W')=\sigma(W'')\) 表示不同世界共享任务语义,上下文可以迁移,训练权重则不具备同样的保证。
跨世界迁移的关键假设,其实挺强
作者认为上下文记录的是物体角色、任务步骤、相对几何和失败教训,而非背景纹理与光照。只要两个世界在任务语义 \(\sigma\) 上一致,在一个世界里练出的记忆就能服务另一个世界。
我喜欢这个表示层面的解释,但得把前提说清楚:语义一致不是天然成立的。如果模拟器的接触、摩擦或关节限制让同一个动作产生不同后果,记忆里的相对放置规则也可能失效。论文对“有用世界”的要求因此很实际:任务行为与后果要足够一致、环境要可重置、排演和评估实例必须隔离。WICL 没有绕开 sim-to-real,它只是把迁移对象从权重换成语义记忆。
🏗️ RoboScript:一份 Markdown 记忆背后的完整系统
RoboScript 是 WICL 的具体实现。它不是把一张图和一句指令丢给大模型就完事,而是由技能构建、任务学习、部署和反思四段流程组成。
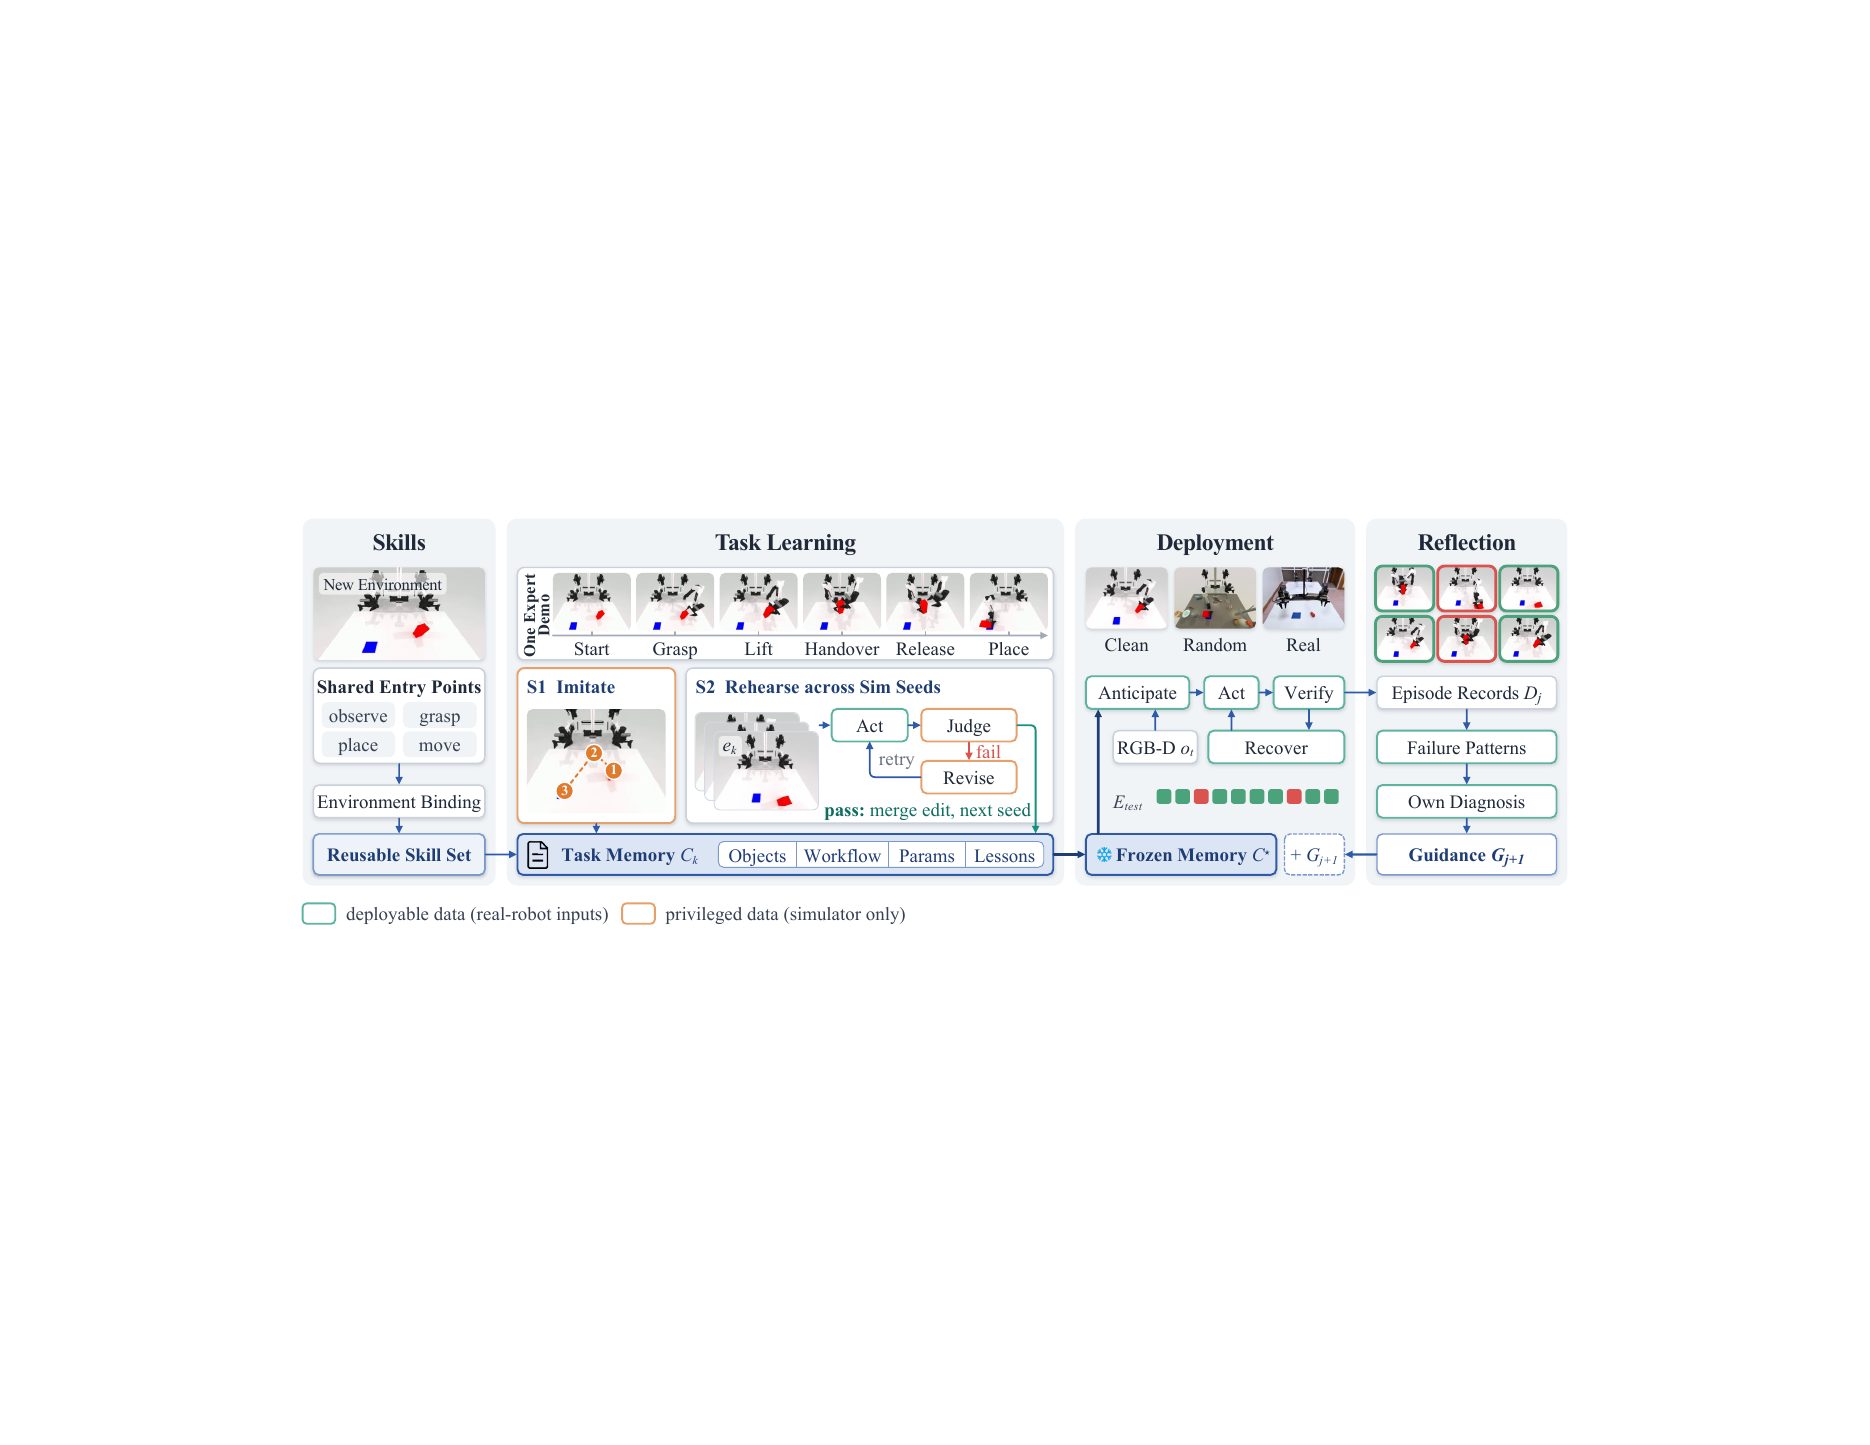
图 3:RoboScript 的系统流程。Skills 阶段生成可复用技能集;S1 在演示实例上模仿,S2 跨模拟种子排演并修订 Task Memory;Deployment 在冻结记忆下执行预判、行动、验证和恢复;Reflection 从评估记录提炼 guidance。绿框表示真机同样可获得的部署数据,橙框表示仅限模拟器的特权数据。
感知先看几何,动作必须给“回执”
机器人能看到头部与腕部 RGB-D 图像以及本体状态。系统先从深度图生成工作区高度图,再做连通域候选,把每个候选提升为带中心、尺寸和朝向的三维包围体。物体身份由 Set-of-Mark 标注、grounding 模型和 VLM 三方投票决定;回合开始识别一次,后续通过末端执行器与物体的抓取关系维持跟踪,避免每次动作后重新认一遍物体。
动作侧也不是简单发一个目标位姿。抓取、放置、纠偏、可达性检查和双臂协调都有共享入口,环境绑定提供坐标系、关节限制、桌高与夹爪参数。每条物理动作返回 receipt,包括命令位姿、实际到达位姿、夹爪开度、是否持有物体以及偏差和失败原因。
这个设计很对我的胃口。模型需要的是“实际发生了什么”,不是“我刚刚命令了什么”。命令执行完成和物理效果达成,是两回事。
技能构建还有一个容易被主结果一句话盖住的环节:系统会在全部 50 个任务的一条演示上切分抓取、搬运、放置等动作片段,让编程智能体补齐现有入口无法解释的技能,再用其他布局验证技能没有写死绝对位置。主结果所说“每任务一条演示”,不是“系统从空白机器人 API 直接学会一切”;它包含了这套自动构建并冻结技能库的过程。
Task Memory:把操作经验写成可审计文件
Task Memory 是结构化 Markdown,包含指令、物体角色与识别方式、分阶段工作流、抓取与放置参数、历史教训和备注。GraspSpec 与 PlaceSpec 都用物体部件及相对几何描述,例如“从把手左侧接近并抓中点”,而不是保存某场模拟里的绝对坐标。
S1 模仿阶段,reader 读演示并写初版记忆,actor 在演示实例上练习,reviewer 根据记录修订;最近 5 次无提示尝试中有 3 次通过才满足退出条件,最多 60 次尝试。S2 排演转到新训练实例,每个实例只有第一次尝试计入收敛统计;失败后,reviewer 在缓存副本上修改,重试成功才允许合并。最近 5 个计数实例中有 3 个首试成功可提前停止,常规上限也是 60 个实例。
随着排演进行,步长 \(\alpha_k=\max(0.2,10/(9+k))\) 和编辑预算逐步收缩,避免记忆一直被新经验反复改写。提交前还有 linter,拒绝模拟器名称、评估器术语、实例标识、绝对位置、相对机器人测得的固定距离和固定手臂分配。
说实话,这套“类型化修改、成功才合并、预算递减、提交前检查”的设计,比单纯让模型写一段反思靠谱得多。它把经验库当成会持续变更的工程产物,而不是越堆越长的聊天记录。
数据隔离:真机部署时看不到模拟器答案
系统把数据分为 deployable 与 privileged 两层。执行 agent 在排演和部署时只能使用真机也能提供的 RGB-D、相机参数、关节状态、夹爪开度、规划器反馈、步数和指令。物体真值位姿、接触状态、真值分割和成功判定只留在控制平面,用于学习阶段监督。
S1 的 reader 和 reviewer 可以看到演示真值,S2 的 reviewer 可以收到失败诊断,但知识必须通过 Task Memory 才能到达 actor,并接受 linter 检查。部署阶段干脆不挂载特权工具。后面消融还显示,在这 10 个任务上去掉这些特权监督,重新学习得到 86.5%,对照为 86.0%;这至少说明结果并非简单来自把模拟器坐标偷塞给执行模型。
部署时,agent 会把记忆中的角色映射到当前物体,检查手臂可达性,再执行动作。失败后回到安全位姿、重新观察,在不重置环境的前提下继续,直到官方步数上限。完成前还要把场景与演示终态做视觉比对,但最终是否成功仍由模拟器官方判定,agent 自己宣布“完成”不算数。
🧪 主实验:21.7 个点的差距,主要来自随机场景
实验使用 RoboTwin 2.0 的 50 个双臂任务。干净场景固定背景,随机场景改变纹理、光照、桌面高度和干扰物。RoboScript 只在干净场景排演,之后用同一份冻结记忆评测两种设置,指令为未见指令。
每种设置每任务评测 10 个 episode,三种基础模型各跑 1,000 个部署 episode。训练策略基线每任务使用 50 条干净演示联合训练,评测每任务 100 个 episode,结果来自官方榜单或公开报告,并排除了使用随机化数据训练的策略。
| 方法 | 每任务演示 | 干净场景 | 随机场景 | 两者平均 | 保留率 |
|---|---|---|---|---|---|
| FastWAM | 50 | 77.8 | 1.9 | 39.9 | 2.4% |
| LingBot-VA | 50 | 80.7 | 34.6 | 57.7 | 42.9% |
| 4D-WAM | 50 | 81.5 | 41.8 | 61.7 | 51.3% |
| \(\pi_{0.5}\) | 50 | 70.7 | 46.0 | 58.4 | 65.1% |
| HarnessVLA + Claude Code | 微调演示数未报告,另加 1 | — | 58.4 | — | — |
| RoboScript + DeepSeek-V4.1-Flash | 1 | 77.8 | 78.4 | 78.1 | 100.8% |
| RoboScript + GPT-5.6-Luna | 1 | 79.8 | 76.0 | 77.9 | 95.2% |
| RoboScript + GPT-6.1-Sol | 1 | 83.6 | 83.2 | 83.4 | 99.5% |
表 1:RoboTwin 2.0 主结果。保留率是随机场景成功率除以干净场景成功率;DeepSeek 超过 100% 只是因为随机场景分数略高,不代表额外“超额能力”。HarnessVLA 只报告随机场景,因此不计算两场景均值。
最强配置 GPT-6.1-Sol 的 83.4% 对应 95% Wilson 区间 81.0% 到 85.6%。与 4D-WAM 相比,干净场景其实只高 2.1 个点,两者称得上接近;平均分高 21.7 个点,主要是随机场景拉开了 41.4 个点。
所以我更愿意把主结论说成:WICL 在这里赢的是分布变化下的稳定性,而不是干净场景里全面压住训练策略。标题里若只写“少 50 倍演示还领先 21.7 点”,很容易遮住真正的故事。
另外,两组评测的 episode 数不同,基线成绩又取自公开榜单,并非所有方法都在同一轮服务与同一批种子上重跑。论文对 API 服务波动也有明确说明。这不推翻结果,但横向比较小分差时应当克制。
随机化后,知识错误没有变多
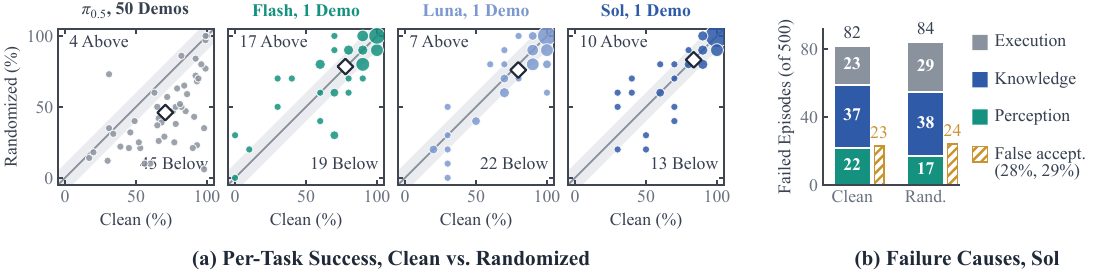
图 4:左侧面板比较逐任务的干净与随机场景成功率。\(\pi_{0.5}\) 有 45 个任务落在对角线下方,三种 RoboScript 配置的点则分布在对角线两侧。右侧统计 GPT-6.1-Sol 的 166 个失败 episode:干净/随机场景分别有 82/84 个,知识失败为 37/38,感知失败为 22/17,执行失败为 23/29;完成检查误判比例分别为 28% 和 29%。
这组失败归因给“语义记忆可迁移”提供了比总分更具体的证据。随机化没有让知识失败激增,增加的是执行失败,和桌高变化导致动作更难完成的解释一致。知识仍然可能错,只是错得没有随纹理与光照一起变多。
不过也别把 83.2% 看成接近 solved。逐任务附录里,hanging_mug 只有 30%/20%,rotate_qrcode 为 30%/60%,pick_diverse_bottles 为 50%/30%。部分精细定位、特定物体和放置任务依旧很难,平均分不会替这些失败说话。
🔬 消融:世界反馈有用,演示更是不可缺
消融在覆盖五种类别的 10 个任务上进行,每任务每设置 10 个 episode。各组与控制共享种子,并使用固定端点做配对比较;重新学习组与直接部署冻结记忆组的绝对水平不能混着比。
| 变体 | 干净场景 | 随机场景 | 平均成功率 |
|---|---|---|---|
| 完整 RoboScript,冻结记忆 | 77.0 | 80.0 | 78.5 |
| 去掉手臂检查 | 78.0 | 72.0 | 75.0 |
| 去掉完成检查 | 72.0 | 82.0 | 77.0 |
| 去掉失败恢复 | 68.0 | 70.0 | 69.0 |
| 只把演示写成记忆,不与世界交互 | 69.0 | 69.0 | 69.0 |
| 部署时直接展示演示 | 69.0 | 66.0 | 67.5 |
| 只有指令 | 68.0 | 68.0 | 68.0 |
| 完整 RoboScript,重新学习 | 87.0 | 85.0 | 86.0 |
| 重新学习但去掉演示 | 58.0 | 55.0 | 56.5 |
| 重新学习且去掉特权监督 | 87.0 | 86.0 | 86.5 |
表 2:消融结果。第一组移除部署组件;第二组不使用世界排演;第三组从头重新学习记忆。
只从演示写记忆得到 69.0%,加入世界交互后同组对照为 78.5%,McNemar 检验 \(p=0.003\)。但“演示本身有没有用”不能只看这三个无世界变体:直接展示演示为 67.5%,只有指令为 68.0%,差距很小,论文报告两两 \(p\geq0.76\)。真正强烈的锚定作用出现在学习组:去掉演示后,从 86.0% 掉到 56.5%。
我的解读是,演示更像一个能收敛的起点,世界排演则负责把这个起点修到能跨场景工作。两者不是简单各加几分,而是一个先提供可行动结构、另一个提供纠错信号的组合。
这里也有实验边界。去演示变体同时移除了由演示终态支撑的完成检查,论文坦承下降包含两部分损失;10 任务主消融还排除了学习成本特别高、特别难的任务。另在 11 个困难任务上,模仿后不排演的成功率为 46.1%,完整方法为 54.5%,平均多 8.4 个点,随机场景多 13.3 个点。这个补充实验反而更能说明排演在困难任务上的价值。
部署组件里,去掉恢复跌得最狠,从 78.5% 到 69.0%。这很符合物理直觉:真实执行很少每一步都完美,能从当前状态继续,往往比一次性生成漂亮计划更重要。
🔁 反思能继续涨,但“递归自我改进”别理解得太满
冻结记忆部署后,reflection agent 还会读取互不重叠评估种子块的记录,写下供下一块使用的 guidance。记录只有部署时可获得的观测与成功/失败,不直接告诉模型失败原因。
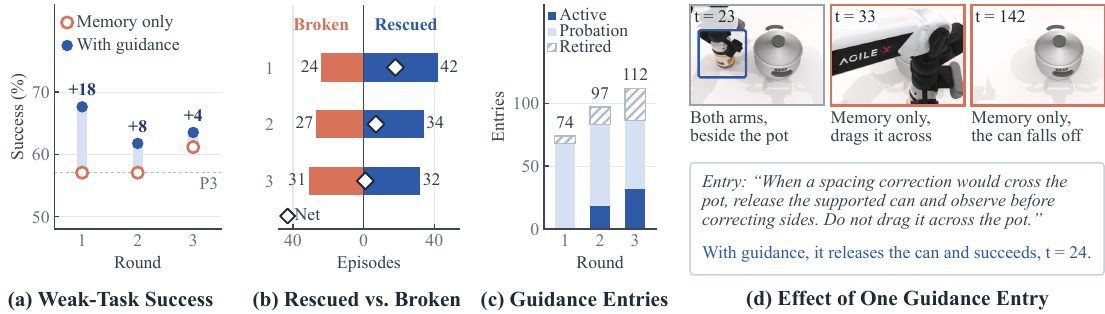
图 5:三轮反思结果。17 个弱任务上的净增益依次为 18、8、4 个 episode;全部 50 个任务中,rescued/broken 分别为 42/24、34/27、32/31,对应净增益 18、7、1。guidance 条目从 74 增至 97、112。右侧案例中,新规则要求横跨锅前先释放并观察,避免把罐子拖过锅面,加入 guidance 后同一案例成功。
每轮救回的 episode 都多于弄坏的,说明文本记忆确实还能在参数冻结时继续修订。不过净收益衰减得很快,到第三轮全部任务只净增 1 个 episode。论文也指出,容易修的失败模式会先被处理,剩余失败在稀疏成功信号下更难归因。
所以我对“recursive self-improvement”的理解比较克制:这是跨未见评估块、经过配对验证的上下文迭代,不是开放式能力自我扩张。它很有用,但边界仍是原模型的感知、推理、技能和评估协议。
💰 免梯度不等于低成本:一次部署要调用模型 54.7 次
看到主结果时我兴奋了一下,看到成本表又冷静了。
| 基础模型 | 两场景平均成功率 | S1 通过退出规则 | 每任务 S2 实例数 | 每部署回合模型调用 | 每部署回合 token | 总成本 |
|---|---|---|---|---|---|---|
| DeepSeek-V4.1-Flash | 78.1 | 50/50 | 11.1 | 53.1 | 389 万 | 739 美元 |
| GPT-5.6-Luna | 77.9 | 47/50 | 14.5 | 62.2 | 261 万 | 308 美元 |
| GPT-6.1-Sol | 83.4 | 49/50 | 12.5 | 54.7 | 233 万 | 1,911 美元 |
表 3:总成本包括 50 个任务的学习与 1,000 个评估 episode,按论文采用的 API 标价计算。token 为每部署回合平均值。
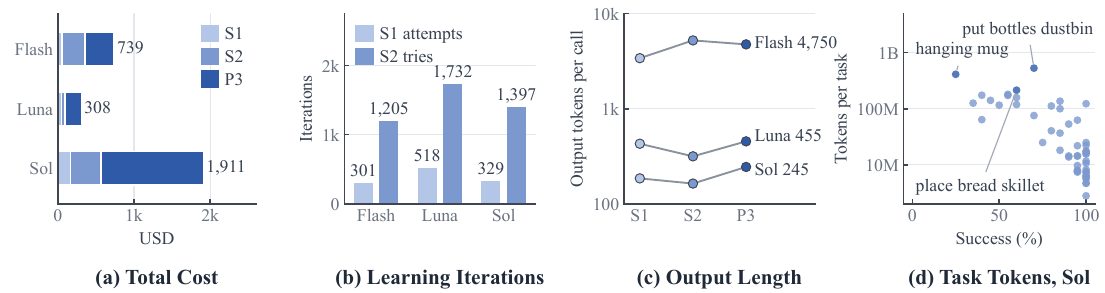
图 6:成本拆解。GPT-6.1-Sol 的总成本主要来自 P3 部署评估;中间面板给出三种模型的 S1 尝试、S2 尝试次数与每次调用输出长度,Flash 在部署时每次调用输出 4,750 个 token,约为 Sol 的 19 倍;右图显示低成功任务通常消耗更多 token。
GPT-6.1-Sol 每个部署回合中位耗时 6.4 分钟,约 80% 时间等基础模型返回;单回合评估成本约 1.33 美元。模拟器、运动规划与视觉模型还用了两台服务器上的 16 张 RTX 4090。这里没有梯度更新,但推理、仿真与排演的计算账单一点也不轻。
这也是论文最现实的工程瓶颈。离线学习一份记忆可以复用,成本还能摊薄;若每次部署都要几十次串行 API 调用,它更适合低频、长时序、允许等待的任务,而不是高频闭环控制。WICL 与训练策略未必只能二选一:高层语义记忆负责规划和恢复,底层快速策略负责接触密集控制,可能更接近实用系统。
🤖 真机迁移:30/40 成功,但仍只是四项任务
真机部分把模拟 ALOHA 上学到的冻结记忆迁到双臂 PiPER。两者运动学结构不同,PiPER 使用两个 6 自由度机械臂和平行夹爪。轻量 adapter 重映射坐标约定、手臂运动学和夹爪参数,任务流程、物体角色与相对规格保持不变,不重新录演示,也不重新排演。
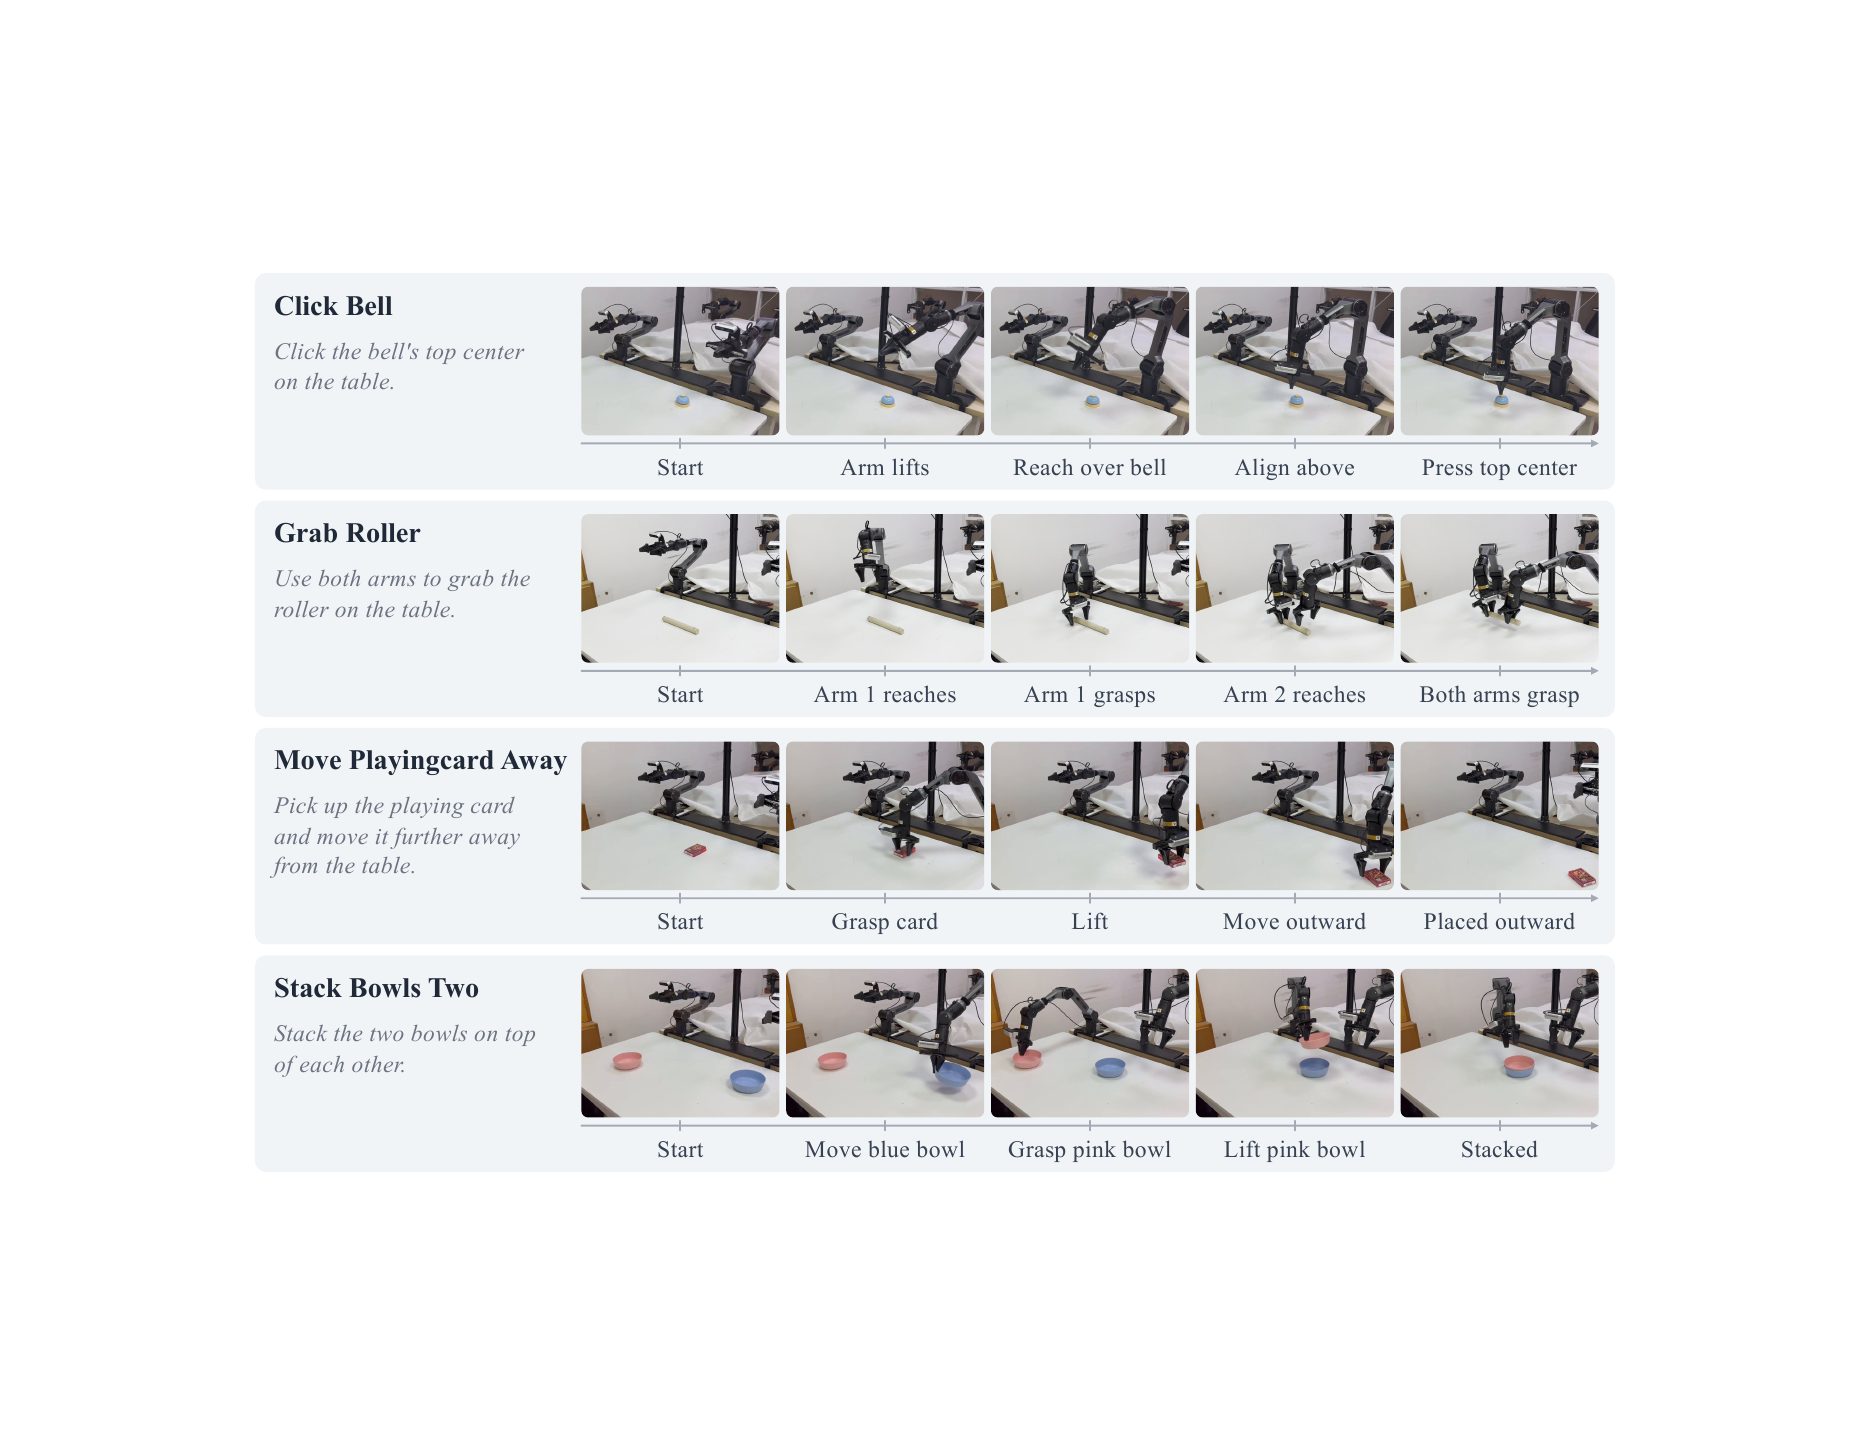
图 7:四个真机任务的关键帧。Click Bell 展示抬臂、到达、对齐并按压铃顶;Grab Roller 展示两臂依次到达并共同抓取;Move Playingcard Away 展示抓牌、抬起和外移放置;Stack Bowls Two 展示移动蓝碗、抓取粉碗并完成叠放。
四项任务各测 10 次,Click Bell、Grab Roller、Move Playingcard Away、Stack Bowls Two 分别成功 10、7、7、6 次,总计 30/40,即 75%。失败主要来自夹爪对齐和真实传感器深度估计误差。
这个结果足以证明“不是只在模拟器里跑通”,但还不足以证明广泛真机泛化。任务只有四个,完整动作序列在离线规划后执行,没有在线重规划;adapter 也承担了不少本体适配工作。说实话,我还想看看它在更长时间、更复杂接触和更多物体实例上的表现,再判断这条路线能否进入日常部署。
💡 我的判断:最值钱的是学习对象的变化,不是“免训练”三个字
这篇论文最打动我的地方,是把机器人技能从难以检查的权重,拆成三种可以独立处理的工程对象:
| 对象 | 存放内容 | 更换时改什么 |
|---|---|---|
| 冻结基础模型 | 通用推理、工具使用与反思能力 | 更换模型服务 |
| 可复用技能集 | 感知、抓取、放置、纠偏等执行能力 | 修改工具与技能代码 |
| Task Memory | 特定任务的物体角色、流程、相对参数与教训 | 修改可读上下文 |
这种拆分让经验可读、差异可查、失败可回溯,也让跨本体迁移有了更轻的操作面。真机 adapter 不需要重新学习整个任务,只改本体相关参数,就是这个拆分带来的直接收益。
但论文的证据也划出了清楚边界。它依赖高能力商业模型、RGB-D、运动规划器、可重置高保真模拟器和一套相当复杂的工具基础设施;实验对象都是刚体或铰接物体,布料、线缆与紧密双臂接触仍难。API 波动能让成功率跨 session 变几个点,反思收益迅速减弱,逐任务低分也没有被平均分消灭。
如果把它称为“上下文版机器人强化学习”,我觉得只说对了一半。它确实用世界反馈改进行为,却没有价值函数、策略梯度或权重更新,真正的承载物是受约束、经验证、可冻结的文本状态。与其说是新训练算法,不如说是一套把经验固化成语义记忆的机器人学习协议。
对工程落地而言,最值得借鉴的不是立刻替换 VLA,而是三个动作:给每次执行返回结构化 receipt;把任务经验写成不含绝对场景坐标的相对规格;让记忆修改通过重试验证,并在完全未见的实例上评测。即便继续训练底层策略,这三件事也能提升系统的可调试性。
还有一个问题留给后续工作:当没有现成模拟器时,学习到的世界模型能否提供足够可靠的反馈?如果世界本身会误判,错误经验进入记忆后又该怎样被撤回?WICL 把“学什么”从权重里释放出来了,下一步要解决的是“该相信哪个世界”。
🔗 参考资料
- 论文原文:https://arxiv.org/abs/2611.12885
- RoboScript 代码:https://github.com/ArcheOne-AI/RoboScript
- RoboTwin 2.0 项目与榜单:http://robotwin-platform.github.io
- Code as Policies:https://code-as-policies.github.io
- VoxPoser:https://voxposer.github.io
- Reflexion:https://arxiv.org/abs/2303.11366
- Voyager:https://arxiv.org/abs/2305.16291
- ExpeL:https://arxiv.org/abs/2308.10144
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我