把模型手术变成 2,048 个 QUBO:Tree-Ising 的位级修复
一个模型做数学题时,反复输出 so x = 2, x = 2...,一直写到 32k token 上限。你会怎么处理?继续训练,调解码参数,还是让一个更强的 Agent 读懂权重、手写一份补丁?
Tree-Ising 给了一个很不一样的答案:把哪些权重该改、改多少,变成一组可以用 GPU 求解的离散优化问题。不反向传播,不消耗 LLM token,也不让 Agent 逐轮判断。
核心摘要:Qwen3.5-0.8B 有 93% 的 MATH-500 回答循环到 token 上限。Tree-Ising 只允许 BF16 符号翻转和 2 的幂缩放,把修复拆成 2,048 个逐行 QUBO,再由模拟退火或模拟分岔求解。统一评测下,MATH-500@4 从 Agent 编辑的 51.7% 提到 54.6%;同一配方迁移到 Qwen3.5-2B,GSM8K 从 21.6% 提到 69.4%。我觉得它最值钱的不是量子实验,而是把行为目标、存储格式和稀疏补丁审计放进了同一个框架。
| 论文信息 | 内容 |
|---|---|
| 原标题 | Tree-Ising: Repairing Language Models with Bit-Level Ising Edits |
| 作者 | Hadi Salloum、Ammar Ali |
| 作者单位 | QDeep(沙特阿拉伯利雅得);LEAD(Lab for Efficient AI and Data),ITMO University |
| 提交时间 | 2026 年 11 月 10 日,v1 |
| 论文链接 | https://arxiv.org/abs/2611.14210 |
| 主题 | 模型修复、权重空间编程、BF16、QUBO / Ising 优化 |
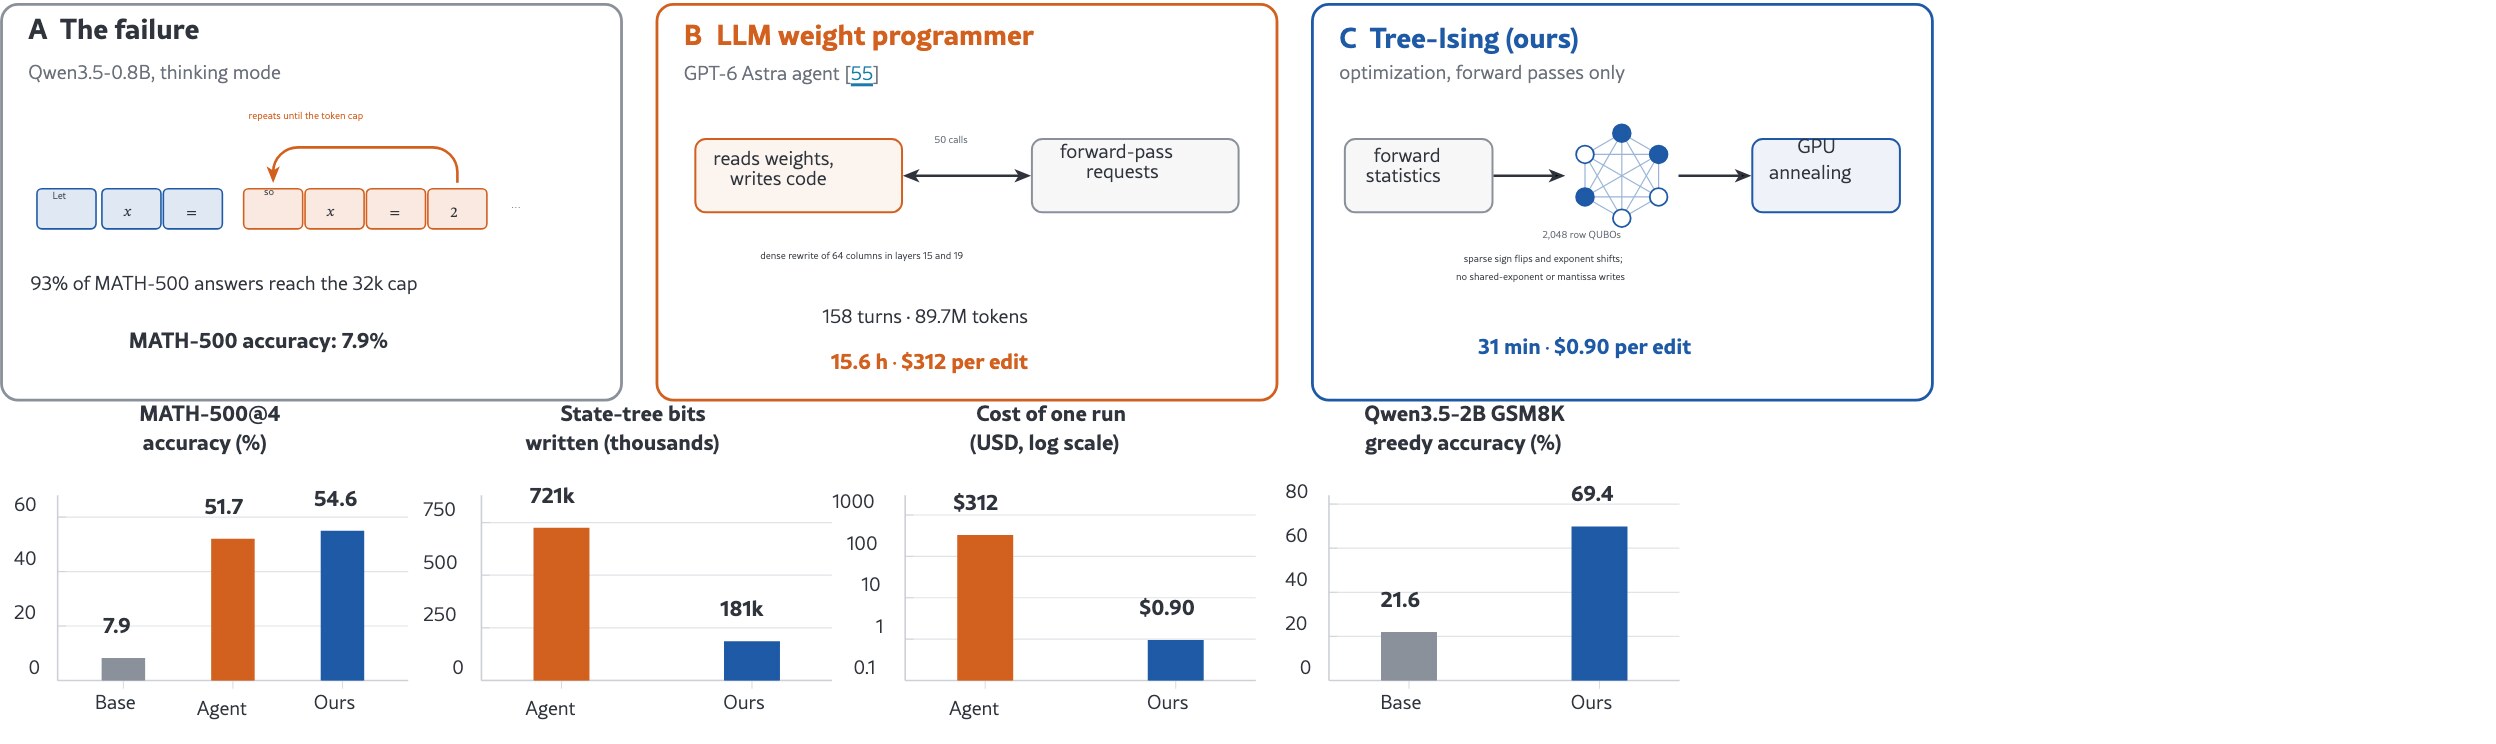
图 1:上方对比循环故障、GPT-6 Astra 的 Agent 修复和 Tree-Ising;下方汇总 MATH-500、状态树写入位数、单次运行成本与 2B 模型迁移结果。注意,0.8B 基座的 7.9% 是前序工作报告的数字,Agent 与 Tree-Ising 的 51.7% 和 54.6% 则来自这篇论文的统一评测。成本对比也有前提,后面会拆开讲。
🎯 93% 的回答撞上限,问题未必是“不会做题”
先看故障本身。
Qwen3.5-0.8B 开启 thinking mode 后,在 MATH-500 上有 93% 的回答一直生成到 32,768 token 上限,准确率只有 7.9%。这不是普通的“算错一步”,而是模型根本停不下来。
MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 在前序研究博客《Sparks of Weight-Space Programming》中,让 GPT-6 Astra 读取权重并修复这个故障。Agent 将问题定位到第 15、19 层 MLP 的输出投影,改写两层各 64 列,原报告把 MATH-500 提到 48.1%。
这个结果很吸引人,但代价也很具体:158 轮 Agent 交互、89.7M token、50 次前向请求,发现修复方案的一次运行花了 15.6 小时和 312 美元。
我的第一反应不是“Agent 太贵,所以该淘汰”,而是另一个问题:Agent 找到的那些证据,能不能从自然语言判断沉淀成明确的目标函数?
如果可以,搜索权重补丁就不必每步都问一次大模型。Tree-Ising 正是沿着这条线往下做。
🧠 从 Agent 手写补丁,到可求解的修复问题
这项工作和普通模型编辑有个明显区别:目标不是修改一条事实知识,而是改变一种动态行为——少循环,该收尾时收尾。
因此,只看权重大小不够。作者用基座模型自己的回答构造四类 token 集合:
| 集合 | 通俗理解 | 论文中的取法 |
|---|---|---|
| \(\mathcal{R}\) | 正在循环的位置 | 找到重复 8-gram 占比至少 80% 的首个 256-token 窗口,在后续 1,000 个位置中取重复 8-gram 的末尾 token |
| \(\mathcal{P}\) | 需要保护的正常输出 | 循环开始前第 2,000 到第 50 个 token,以及正确且完整回答中的全部生成 token |
| \(\mathcal{Z}\) | 准备收尾的位置 | 正确回答中 </think> 前的末尾 64 个 thinking token |
| \(\mathcal{M}\) | 还应继续推理的位置 | 同一批正确回答里更早的 thinking token |
循环方向来自 \(\mathcal{R}\) 与 \(\mathcal{P}\) 的平均残差之差,收尾方向来自 \(\mathcal{Z}\) 与 \(\mathcal{M}\) 的平均残差之差,再组合成
\(u \propto u_{\mathrm{loop}}-\beta u_{\mathrm{end}}\),其中 \(\beta=0.5\)。
这个设计挺关键。只压低循环方向,模型可能换一种方式继续写;还要告诉它,成功回答在结束前呈现什么状态。后面的消融也确实显示,拿掉收尾方向后,截断率从 22.7% 飙回 53.1%。
说到这里,Tree-Ising 的定位就清楚了:它不是让优化器凭空理解“循环”这个概念,而是先把循环与收尾写成可测量的方向,再搜索符合存储格式约束的权重编辑。
🏗️ Tree-Ising 的五步拆解
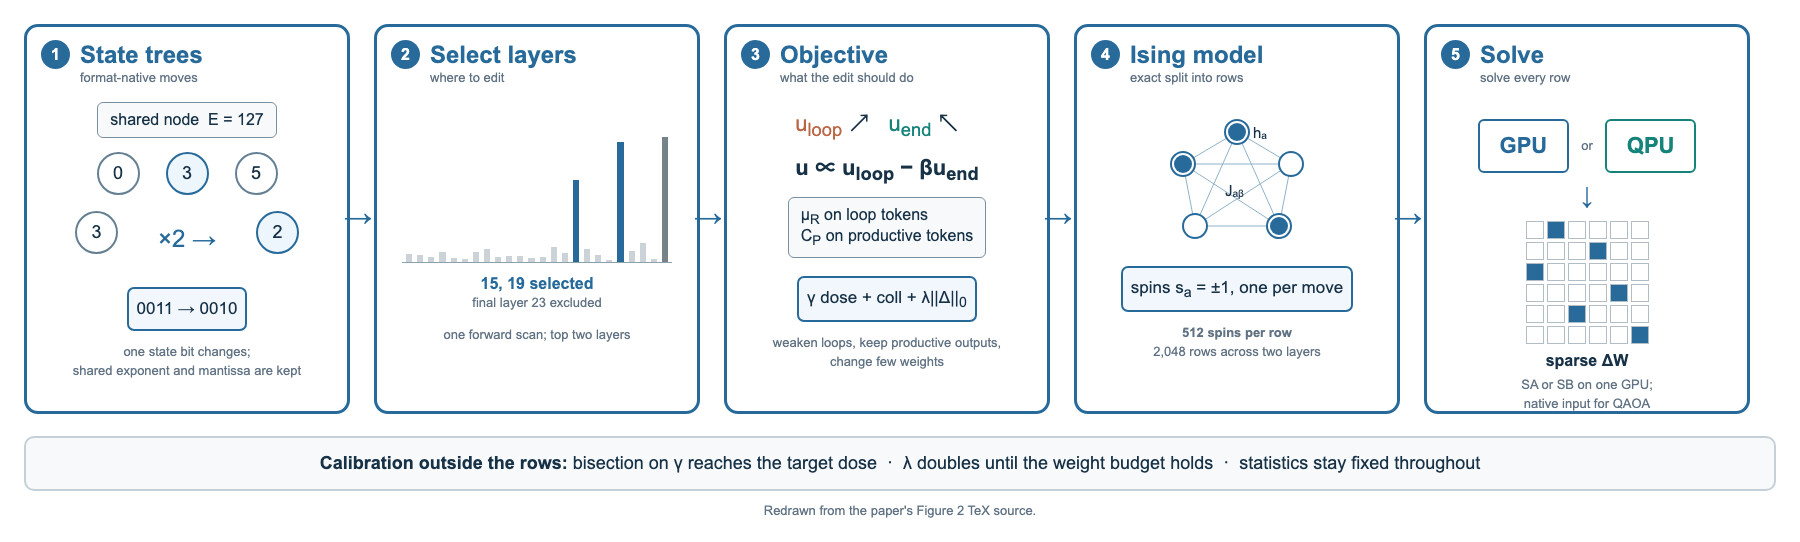
图 2:依据论文 Figure 2 的 TeX 源重绘。五步依次是状态树表示、层选择、目标构造、逐行 Ising 分解和求解。底部的两个全局校准旋钮是 \(\gamma\) 与 \(\lambda\):前者对准修复剂量,后者控制改动预算,统计量在校准过程中保持固定。
1. 只允许 BF16 原生支持的离散动作
BF16 有 1 位符号、8 位指数和 7 位尾数。论文采用的无损状态树表示,将一行中连续 64 个权重分为一组,共享最大指数 \(E\);每个权重另存 4 位状态 \(D=E-e\)、符号和尾数。状态 15 是少见的 escape,需要额外侧表。
每个候选权重可以保持不动,也可以乘以下列因子之一:
\(\mathcal{F}=\{-1,2,\tfrac12,4,-2,-4,-\tfrac12,\tfrac14\}\)。
乘以 2 的幂只移动指数偏移,乘以负数再翻符号。动作只有在不破坏组内最大指数、不产生新 escape 时才被允许。于是,共享指数和尾数不动是由动作集合保证的,不是实验后碰巧观察到的。
举个例子,组内共享指数 \(E=127\) 时,一个权重若满足 \(D=3\),数值为 0.125;翻倍后是 0.25,\(D\) 变成 2,4 位状态从 0011 变为 0010,只动了一个状态位。
这里有个容易被包装带过去的细节:二进制 QUBO 并不是状态树自动变出来的。真正让问题二元化的是“每个候选权重预先只保留一个动作,再决定做或不做”。状态树提供的是格式原生的动作集合和位写入账本。
2. 用一次前向扫描决定改哪几层
对第 \(\ell\) 层,作者计算 MLP 在循环 token 与保护 token 上,沿 \(u_\ell\) 方向的平均写入差:
\(s_\ell=u_\ell^\top(\bar m_{\ell,\mathcal R}-\bar m_{\ell,\mathcal P})\)。
规则是排除末层,再选分数最高的两层。0.8B 上,末层 23 的分数很高,接下来就是 19 和 15,于是与 Agent 的选择重合。
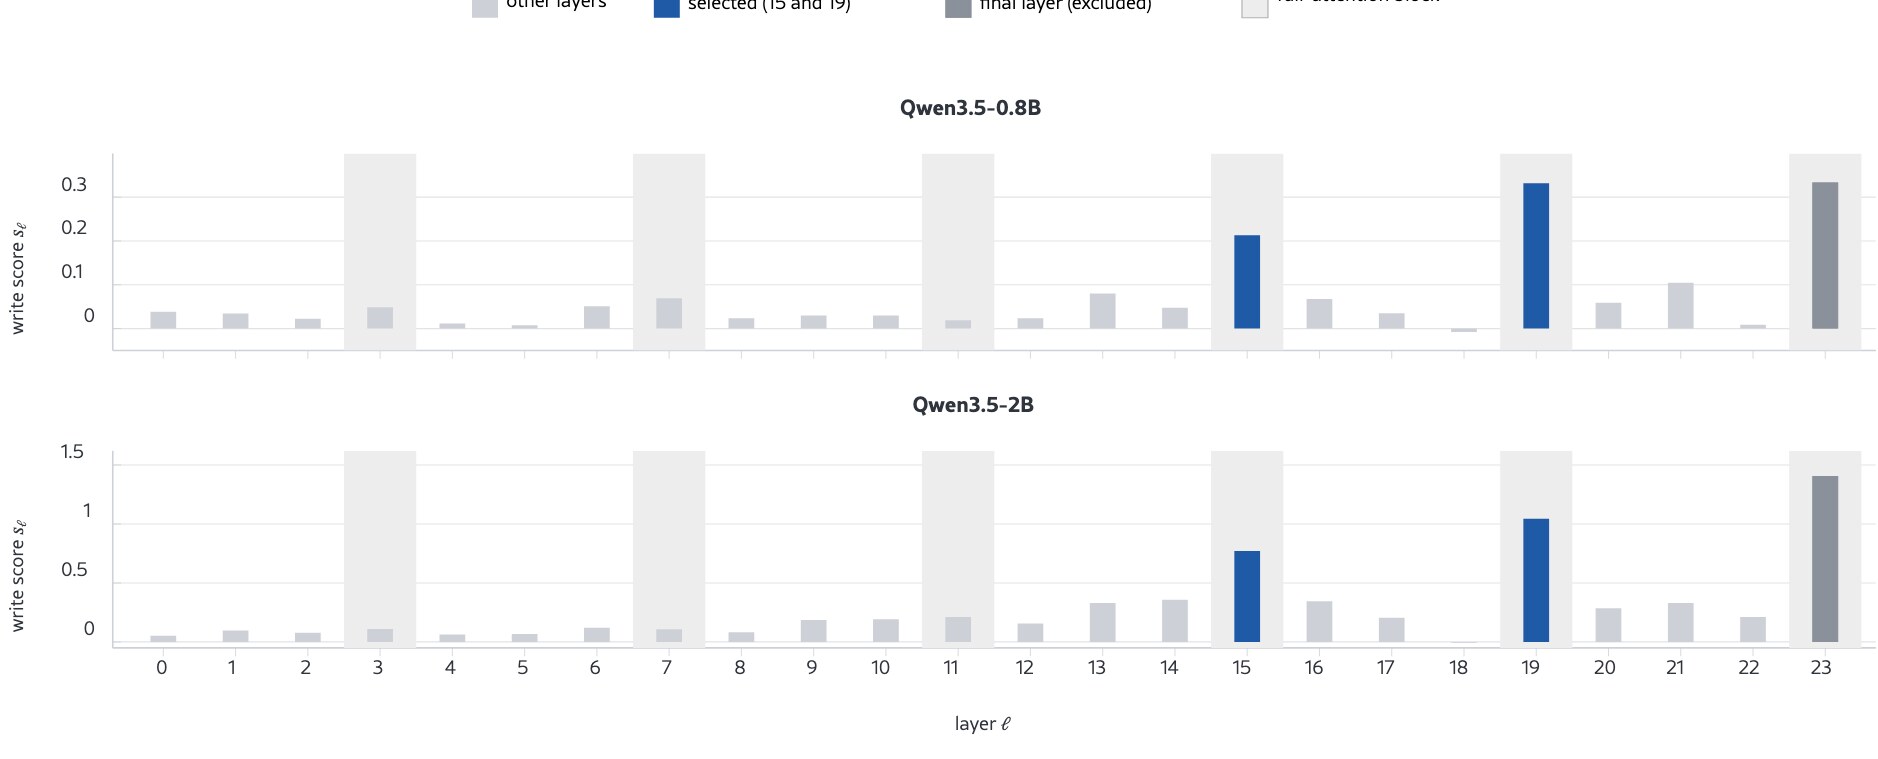
图 3:蓝色是选中的第 15、19 层,深灰是被排除的第 23 层,浅灰底纹标出 full-attention block。两种模型的高分层都落在 full-attention block 上。这个一致性很漂亮,但也可能是共享架构带来的,不足以证明扫描规则普遍成立。
作者在这里很坦诚:排除末层的规则是在看到 0.8B 扫描结果后定下的,而且两种模型都采用每四层一个 full-attention block 的混合结构。说实话,这个证据比我初见“两个模型都选中 15 和 19”时想象的要弱一些。
3. 目标函数同时管修复、误伤和稀疏性
设权重编辑为 \(\Delta\),循环 token 上输出投影的平均输入为 \(\mu_{\mathcal R}\),保护 token 的输入为 \(a(t)\)。核心目标是:
三项各管一件事。
第一项叫 dose。让 \(u^\top\Delta\mu_{\mathcal R}\) 更负,就是在压低目标方向的写入。第二项是 collateral,约束正常 token 上的层输出别被带偏。第三项直接数改了多少个非零权重。
\(\gamma\) 通过几何二分调到目标剂量,\(\lambda\) 从基于单权重 collateral 中位数的初值开始,超出预算就翻倍;每次改完 \(\lambda\),都重新调 \(\gamma\)。目标剂量相对于该层自身沿 \(u\) 的写入来定义,迁移到新模型时使用 \(\tau=6.5\)。
但 0.8B 主实验不是严格等剂量对比:Tree-Ising 使用 Agent 编辑剂量的 1.6 倍,对应第 15、19 层目标分别为自身写入的 6.7 和 6.1 倍。作者没有跑 1.0 倍的严格等剂量版本。看到“比 Agent 高 2.9 个点”时,这个前提得一起记住。
4. 固定候选和动作后,精确拆成逐行 QUBO
每层先保留 \(K=512\) 个候选列。对每个候选权重,在当前 \(\gamma,\lambda\) 下预选单权重能量最低的可行动作,记其造成的数值变化为 \(\delta_a\),再用 \(x_a\in\{0,1\}\) 表示是否执行。
每个输出行 \(r\) 都得到一个独立问题:
\(h_a\) 汇总单动作的剂量收益、自身 collateral 和稀疏惩罚,\(J_{ab}\) 表示两个动作共同造成的 collateral。令 \(s_a=2x_a-1\),它就是标准 Ising 模型。
“精确分解”有明确边界:统计量、候选列和每权重一个动作都固定之后,目标按行拆开是精确的;候选筛选、动作预选和具体求解器仍然是启发式。外层预算通过 \(\lambda\) 间接耦合所有行,并不是一次性求出全局离散最优。
0.8B 的两层各有 1,024 个输出行,因此一共是 2,048 个 512-spin 稠密 QUBO。
5. 求解器可以换,配方不必换
默认模拟退火把一层的所有行组成 GPU 批次,每行跑 16 个 replica、300 次 sweep,温度从每行 \(|h_a|\) 中位数的 2 倍几何降到 \(10^{-4}\) 倍,保留能量最低的解。
模拟分岔则积分耦合分岔振子的经典动力学,从轨迹符号读取 spin。论文用 1,200 步、步长 0.5,并做 float64 单 bit 下降。两种求解器共用候选、动作和校准协议,换的只是搜索器。
这就带来一个很好用的实验:如果两种求解器得到的模型表现接近,收益更可能来自目标和约束,而不是某个退火随机种子碰巧挑中了好补丁。
🧪 0.8B 主实验:五个数学基准都领先,但别只看最高分
统一评测使用 thinking mode,temperature 0.6、top-p 0.95、top-k 20、presence penalty 1.5,最多生成 32,768 token。两个编辑后的 checkpoint 使用同一 harness 和相同随机种子。
下表全部是论文重新评测的 Agent 与 Tree-Ising 数字,不把前序工作的 48.1% 混进来:
| 基准,准确率 % | Agent 编辑 | Tree-Ising,SA | Tree-Ising,SB |
|---|---|---|---|
| MATH-500@1 | 51.2 | 54.0 | 54.4 |
| MATH-500@4 | 51.7 | 54.6 | 55.1 |
| GSM8K@1 | 65.6 | 70.5 | 70.8 |
| AMC23@16 | 22.0 | 22.7 | 25.0 |
| Minerva Math@4 | 24.2 | 26.1 | 25.6 |
| OlympiadBench@1 | 21.4 | 24.3 | 24.0 |
SA 在 MATH-500@4 上领先 2.9 个点,\(p\approx0.003\);SB 领先 3.4 个点,\(p\approx0.0005\)。GSM8K 上,SA 有 155 题只有自己解对、90 题只有 Agent 解对,\(p=4\times10^{-5}\);SB 对应 156 对 87,\(p=10^{-5}\)。这两项结果在两种求解器下都通过了对 12 次 Agent 比较做 Bonferroni 校正后的门槛。
其他数据集不必硬说成全面胜出。SA 在 OlympiadBench 的 \(p=0.045\) 过不了多重校正,MATH-500@1、AMC23 和 Minerva 的差异也处于噪声范围。SB 相对 SA 在 MATH-500@4 只高 0.45 个点,\(p=0.62\);GSM8K 的求解器对比 \(p=0.84\)。两种求解器没有分出高下。
真正更有说服力的是终止行为。MATH-500@4 的截断率从 Agent 的 31.6% 降到 SA 的 23.9%;GSM8K 从 8.0% 降到 3.1%;OlympiadBench 从 47.8% 降到 32.5%。准确率提升主要来自更多回答能在预算内收尾,而不是模型突然学会了此前不会的数学。
还有个数据污染问题。早期探索用过固定 100 道 MATH-500 题,完整测试集并非完全未见。作者单独报告剩余 400 题:SA 为 53.8%,Agent 为 50.8%,差 2.9 个点,\(p\approx0.009\);SB 为 53.6%,\(p\approx0.007\)。这个补测值得肯定,也让主结论扎实了一些。
成本:31 分钟和 0.90 美元是真的,对比口径也得读完整
| 单次编辑成本 | Agent 发现过程 | Tree-Ising 固定配方 |
|---|---|---|
| 前向请求 | 50 | 4 |
| 模型前向 GPU 时间 | 12.2 小时 | 21.8 分钟 |
| 搜索时间 | 1.8 小时 Agent 响应 | 8.8 分钟 GPU 退火 |
| 墙钟时间 | 15.6 小时 | 31 分钟 |
| LLM token | 89.7M | 0 |
| 总成本 | 312 美元 | 0.90 美元 |
四次前向请求分别是生成练习回答、两次 teacher-forced 统计、一次筛选验证。GPU 成本按单张 A100 40GB 每小时 1.76 美元估算。
不过,这一栏比较的是“Agent 从零发现修复”与“执行已经设计好的 Tree-Ising 配方”。0.8B 配方读了 Agent 的公开日志,复用层选择,还参考 Agent 编辑校准剂量;两边都不计方法研发成本。直接拿 350 倍成本差去证明所有场景都该换掉 Agent,不公平。
2B 实验去掉了这两项依赖,才更接近“固定配方能否独立工作”的证据。
编辑足迹:少改权重,更少改存储位
| 两层合计 | Agent 编辑 | Tree-Ising,SA | Tree-Ising,SB |
|---|---|---|---|
| 改动权重 | 130,188 | 112,630 | 108,327 |
| BF16 bit flips | 621,388 | 278,767 | 268,090 |
| 状态树 bit flips | 720,586 | 181,062 | 174,245 |
| 共享指数写入 | 1,261 | 0 | 0 |
| 尾数改动 | 129,668 | 0 | 0 |
SA 少改 13% 的权重,SB 少改 17%;BF16 写入位分别减少约 2.2 和 2.3 倍,SA 的状态树写入位减少 4 倍。补丁只落到两个 down_proj 矩阵的约 1.5% 权重上,推理图不变。
这对工程审计很实在:你可以逐项记录“哪个位置执行了哪个离散动作”,而不只是保存一份所有浮点数都可能变化的稠密差分。
但论文也承认,状态树位数按直接编码器计算,escape payload 内的变化不计;对压缩 checkpoint 的直接补丁尚未实现。位级可审计的叙事很完整,部署链路还缺一块。
🔬 消融:收尾方向不可少,离散求解器反而不是主角
消融在 128 道保留练习题上进行,每题一次生成,准确率标准误约 4.4 个点。小样本不足以分辨一两点差异,适合看大趋势。
| 变体 | 准确率 % | 截断率 % | 改动权重 |
|---|---|---|---|
| 选定配置,\(\beta=0.5\)、1.6 倍剂量 | 57.0 | 22.7 | 112.6k |
| 只要循环方向,\(\beta=0\) | 43.8 | 53.1 | 112.3k |
| 较弱收尾方向,\(\beta=0.25\) | 53.1 | 28.1 | 115.4k |
| 较强收尾方向,\(\beta=1\) | 53.9 | 21.1 | 93.2k |
| 较低剂量,1.2 倍 | 57.8 | 16.4 | 77.4k |
| 只用 \(-1,2,\tfrac12\) 三种动作 | 50.0 | 22.7 | 122.7k |
| 零温贪婪求解 | 53.9 | 18.0 | 112.0k |
| 每层预算缩到 28k | 49.2 | 24.2 | 45.6k |
| Agent 编辑 | 52.3 | 25.0 | 130.2k |
\(\beta=0\) 是最刺眼的一行。只削弱循环,模型还是停不下来,准确率掉到 43.8%。这让我觉得论文真正抓住的是“循环与收尾之间的方向组合”,而不只是又找到一种权重扰动方式。
较低剂量的 57.8% 看起来比选定配置还好,还少改 31% 权重,但它在剂量扫描后才出现,作者没有用扫描结果重新选主配置,而且筛选集噪声很大。主结果保留 1.6 倍是更克制的报告方式。
连续对照更值得琢磨。去掉稀疏约束和离散动作后,同一个目标可以写出 ROME 风格的闭式 rank-one 更新。它在筛选集上也拿到 57.8%,截断率只有 12.5%,却改了 7.02M 个权重和 28.7M 个 BF16 位。相比 Tree-Ising,权重改动约 62 倍,位写入约 103 倍。
等等,那 QUBO 到底贡献了什么?
我的判断是:行为收益主要来自目标函数,Tree-Ising 的独特贡献是用稀疏、格式原生的编辑拿到相近收益。闭式连续解只在这 128 题筛选集上评过,没有完整基准结果,不能据此宣布它更好;但它确实削弱了“模拟退火或量子求解器带来模型能力”的想象空间。
同剂量的纯方向消融只有 38.3%,也说明简单减去一个方向不够,保护项和具体权重选择确实在起作用。
📊 迁移到 2B:这次没有 Agent 参考答案
Qwen3.5-2B 的故障更适合观察“能力被循环遮住”这件事。贪心解码、8,192 token 上限下,基座在 1,319 道 GSM8K 上只对 21.6%,77.9% 的回答截断;1,028 个截断回答中有 1,018 个存在循环。能正常结束时,正确率高达 97.9%。
Tree-Ising 这次只用基座模型选择层和剂量:扫描后排除第 23 层,选 15、19;剂量设为自身写入的 6.5 倍;每层预算 200,000 个权重。流程在单张 A100 上运行 26 分钟,不看 Agent 编辑,也不看参考 checkpoint。
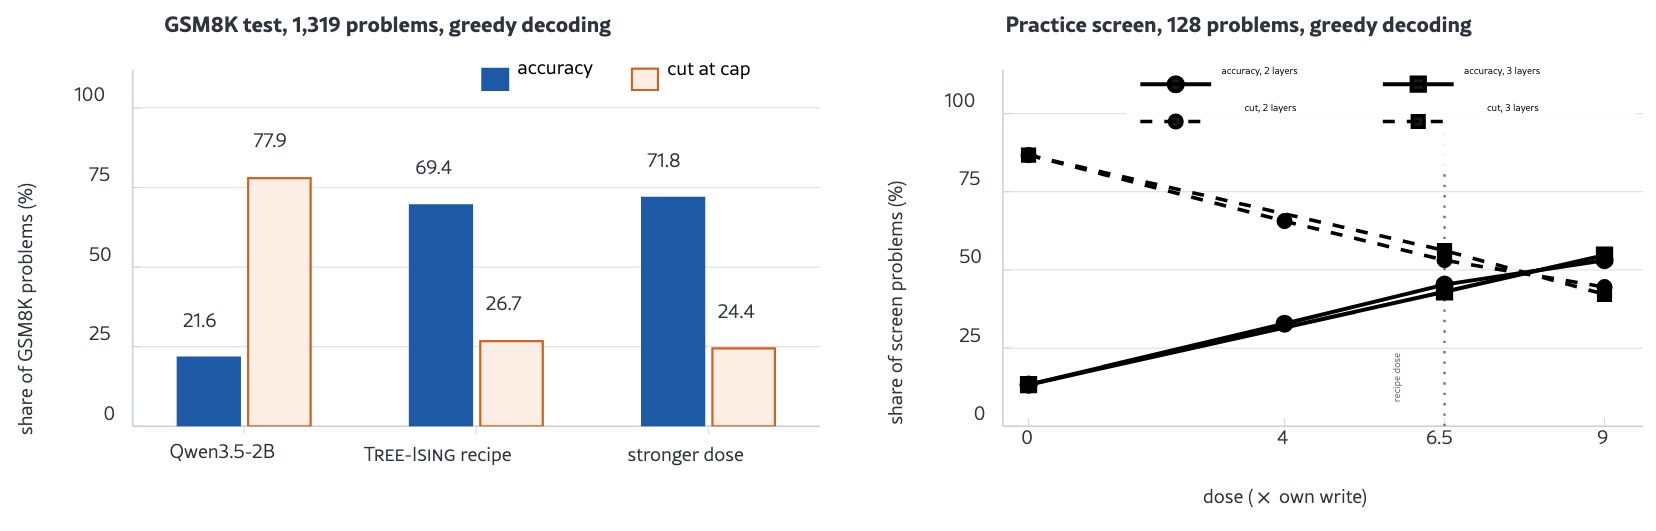
图 4:左侧是完整 GSM8K 测试集,标准配方把准确率从 21.6% 提到 69.4%,截断率从 77.9% 降到 26.7%;加强版为 71.8% 和 24.4%。右侧显示练习筛选集上,剂量增加时准确率上升、截断率下降。
| Qwen3.5-2B,GSM8K 贪心解码 | 编辑层 | 剂量 | 准确率 % | 截断率 % | 改动权重 |
|---|---|---|---|---|---|
| 基座 | — | — | 21.6 | 77.9 | — |
| 标准配方 | 15、19 | 6.5 倍 | 69.4 | 26.7 | 292,845 |
| 加强版 | 14、15、19 | 9 倍 | 71.8 | 24.4 | 482,423 |
标准配方多解出 669 道基座做错的题,但也把基座原本做对的 285 题中的 38 题改错了,损失约 13%。所以“正常结束时 97.9% 正确”不能误读成编辑毫无副作用;编辑后完成回答的正确率为 94.7%,而且前后对应的题目子集不同。
加强版相对标准配方多领先 2.4 个点,但 \(p=0.09\),没有跨过统计检验,状态树写入位还增加到约 1.7 倍。作者把标准配方放在主结果里,这个选择合理。
坦率讲,2B 结果很有冲击力,外部效度却仍然有限。作者先用 200 道 GSM8K 测试题探过基座表现,再选择它最吃力的贪心解码和 GSM8K;推荐采样设置与 MATH-500 都没测。剩余 1,119 题上的 69.6% 与全量结果接近,缓解了选择测试题的担忧,却不能替代跨任务、跨解码设置验证。
⚛️ 量子硬件实验:能跑通,离量子优势还很远
论文还把第 15 层某一行的 8 个候选变量单独拿出来,其余变量固定为 0,在 IBM Heron r2 的 ibm_fez 上跑 QAOA。8 个变量只有 256 种赋值,经典枚举可以立刻知道精确最优解。
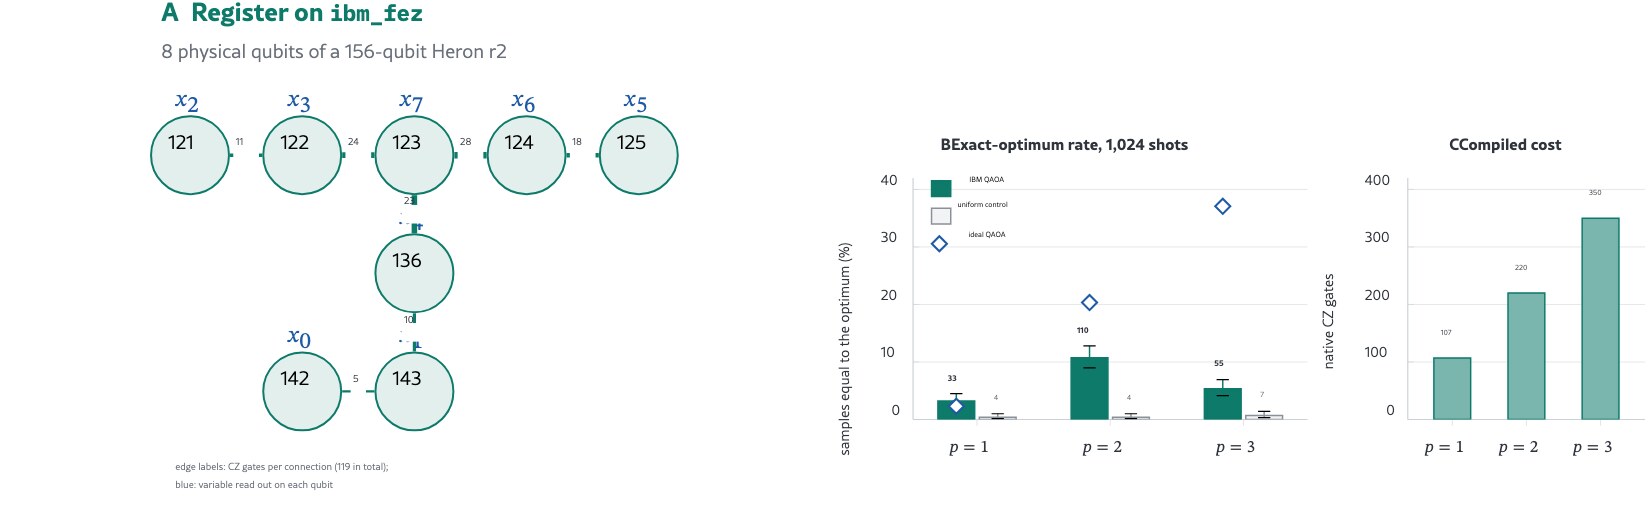
图 5:A 是 8 个物理量子比特及连接;B 比较 QAOA、均匀采样对照和无噪声理想结果;C 是编译后的 CZ 门数。深度二的实测命中率最高,深度三虽然理想命中率更高,门噪声却随之增加。
| QAOA 深度 | 最优解命中 | 实测命中率 | 理想命中率 | CZ 门数 |
|---|---|---|---|---|
| \(p=1\) | 33 / 1,024 | 3.22% | 2.31% | 107 |
| \(p=2\) | 110 / 1,024 | 10.74 | 20.33% | 220 |
| \(p=3\) | 55 / 1,024 | 5.37% | 37.06% | 350 |
均匀对照在 \(p=2\) 时是 4 / 1,024,即 0.39%。但均匀采样是很弱的优化基线,论文没有跑相同编译电路的随机角度对照,也没有把量子解写回模型做下游评测。QAOA 角度由经典 statevector 模拟优化,硬件只执行了一次 job。
所以这部分的正确读法是“一个真实修复目标可以映射到量子硬件并采样”,不是“量子计算已经能修 LLM”。作者自己也明确否认了量子优势结论。全模型结果全部来自经典 GPU 求解器。
🤔 我的判断:真正有意思的是稀疏、可审计的行为编辑
把几类方法放在一起,Tree-Ising 的位置会更清楚:
| 路线 | 如何决定权重变化 | 存储与推理形态 | 更适合什么 |
|---|---|---|---|
| Agent 权重空间编程 | 大模型读权重、调用前向、写代码 | 连续或稠密写入,形式灵活 | 故障未知,需要探索诊断 |
| ROME 风格闭式更新 | 对二次目标求连续 rank-one 解 | 直接写回时触及大量权重 | 目标明确,接受稠密更新 |
| 方向消融 / 激活引导 | 沿测得方向投影或在推理时加方向 | 简单,但可能改变推理路径或误伤输出 | 快速验证行为方向 |
| Tree-Ising | 对离散动作做逐行 QUBO 搜索 | 稀疏 BF16 原生补丁,推理图不变 | 故障明确,重视补丁审计和存储局部性 |
它既有前置工作的影子,也有自己的组合点。层输出重建误差早已用于剪枝和量化,AdaRound 与后续量化研究也把逐行二值问题交给 QUBO;ROME 使用连续低秩更新,状态树工作提供共享离散决策的表示。Tree-Ising 新拼上的部分,是循环与收尾的行为方向、稀疏惩罚,以及不改共享指数和尾数的 BF16 原生动作。
我会把它看成一个设计得很讲究的工程与方法整合,而不是通用模型修复框架。理由也很具体:
实验只覆盖同一 Qwen3.5 家族的两个模型、同一种循环故障和数学任务。两种模型共享混合线性 / 全注意力架构,层扫描可能依赖这个结构。一般语言建模、非数学任务和指令遵循副作用都没有测。
目标函数是从未编辑模型统计得到的一阶代理。编辑第 15 层后,第 19 层实际看到的输入会变,但统计量不会跟着变。逐行分解在代理内部精确,不代表对真实模型动态精确。
每个基准只用一个生成种子,每个求解器也只跑一次;成本计时来自单次运行和不同版本的求解脚本,不能当作严谨的扩展性测量。0.8B 基座的 7.9% 没有在这套 harness 中重跑,连续对照也只在筛选集出现过。
这些限制不妨碍结果有趣,只是提醒我们别把 69.4% 直接外推成“任意模型都能修好”。
🔧 如果要落地,我会先守住评测,再谈求解器
这套方法适合一个相当具体的工程场景:你有开放权重,能稳定复现某种行为故障,能收集失败与成功轨迹,而且希望产出可回滚、可逐项审计的小补丁。
落地时,保护集 \(\mathcal P\) 不能只覆盖目标 benchmark。除了正常数学推理,还应加入通用对话、指令遵循、长上下文和安全回归样本,否则 collateral 只保护你看得见的那部分行为。层选择与剂量要在开发集定,最终测试集保持隔离;至少补多随机种子、推荐解码配置和非目标任务,别只报告最吃力的故障设置。
补丁评估也不该只看准确率。截断率、原本正确答案被改错的比例、BF16 与状态树写入位、非目标能力回归,应该放在同一张验收表里。对线上模型,还要把离散动作日志、基础 checkpoint 哈希和回滚包一起保存。
至于求解器,我会先用经典 SA 或 SB 把目标和评测跑通。当前 512 变量逐行问题对经典方法并不难,更快的求解器最多压缩整个配方的一部分时间。量子硬件可以研究,暂时不是工程收益的主要来源。
回到开头那个反复写 x = 2 的模型。Tree-Ising 最打动我的地方,不是“0.90 美元修一次”这个孤立数字,而是它把一次看似依赖 Agent 直觉的修复,拆成了可测量方向、可约束误伤、可审计位写入和可替换求解器。
这条路线能不能走出 Qwen3.5 的循环故障,我还不能确定。但如果以后更多模型补丁需要像代码变更一样被审查,这种格式原生、稀疏离散的表达方式,很可能比一整片浮点差分更好用。
📚 参考材料
- Hadi Salloum, Ammar Ali. Tree-Ising: Repairing Language Models with Bit-Level Ising Edits, arXiv:2611.14210, 2026.
- Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab. Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights, MIT CSAIL, 2026.
- Ammar Ali, Stamatios Lefkimmiatis. Every Weight Is a Path: Representing Neural Networks as Trees of Discrete Decisions, arXiv:2610.31931, 2026.
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我