不只提出想法,还会决定下一步怎么研究:Sage-Taiyi 的元认知科学智能体
让一个科研 Agent 连续跑十轮,很容易看到这样的场面:它生成了很多假设,也给每条假设补了实验方案,但第五条和第九条其实建立在同一个没验证的前提上。某个分支已经撞上死路,另一个分支却还在重复同样的错误。系统看起来一直在“思考”,研究理解却没有真正积累下来。
Sage-Taiyi 盯上的正是这个问题。它不只问“下一个想法是什么”,还追问“我们现在理解了什么、哪些前提仍不可靠、下一步该换目标还是换方法”。这个转变挺有意思:从自动产出科研点子,走向管理科研搜索本身。
核心摘要:Sage-Taiyi 把科学发现拆成对象层的科学搜索与元层的认知调控,用可修订的 Cognitive State 保存证据、假设和冲突,再由监控与控制机制选择研究目标及推理方法。在覆盖 10 个学科、50 篇论文和 265 个任务的 Taiyi-Bench 上,它的 Overall 为 53.95,高于 AI Scientist-v2 的 47.85,并在五项专家参与的合作中把构想接到实验或仿真验证。我的判断是,这篇论文最值钱的不是“又一个多智能体框架”,而是把科研中的共同前提、证据边界和方法选择显式放进了状态管理;但缺少组件消融,让元认知究竟贡献了多少仍然不好量化。
论文信息
- 英文标题:Sage-Taiyi: A Metacognitive Architecture for Scientific Discovery
- 作者:Weida Wang、Benteng Chen、Yigeng Jiang 等,Sage-Taiyi Team;完整作者名单见 arXiv 页面
- 署名机构:上海人工智能实验室(Shanghai Artificial Intelligence Laboratory)
- 提交时间:2026 年 11 月 9 日
- 论文链接:https://arxiv.org/abs/2611.12762
- 项目主页:https://alpha-innovator.github.io/Sage-Taiyi/
- 论文规模:38 页,18 张图
1. 科研 Agent 的短板,不一定是想法不够多
前几年自动科研系统的主线很清楚:把“读文献—提假设—做实验—写报告”串起来,让模型多跑几轮。问题是,流程闭环不等于认知闭环。
根据 AI Scientist-v2 的公开设计,它用 agentic tree search 管理候选实验方案;Google 的 Co-Scientist 靠生成、反思、排名和进化组成假设锦标赛;Robin 则把文献、实验设计和数据分析智能体接入 lab-in-the-loop。它们都在解决真实问题,但侧重点不同:有的优化候选解,有的提高假设质量,有的把物理实验反馈接回来。
Sage-Taiyi 关注的是另一个缝隙:一条研究分支里形成的判断,怎样改变另一条分支的后续搜索?
| 系统 | 主要组织方式 | 擅长的事情 | 与 Sage-Taiyi 的差别 |
|---|---|---|---|
| AI Scientist-v2 | 候选方案的树搜索与实验管理 | 从构想推进到计算实验和论文 | Sage-Taiyi 更显式地维护跨分支科学理解与方法选择 |
| Co-Scientist | 多智能体生成、辩论、进化、锦标赛排序 | 扩展并筛选研究假设 | Sage-Taiyi 不只排序想法,还决定何时修订目标、换方法或停分支 |
| Robin | 文献、实验设计、数据分析智能体闭环 | 将实验反馈带回生物学研究 | Sage-Taiyi 把反馈进一步转成可修订的认知状态和后续控制 |
| Sage-Taiyi | 对象层搜索 + 元层监控与控制 | 管理目标、证据、共同依赖和研究方法 | 核心不是新基础模型,而是科学搜索的状态与调控架构 |
我的第一反应是,这不就是给 Agent 加了一份“研究笔记”吗?看到后面才发现,作者想做的不只是记忆。普通记忆回答“发生过什么”,元认知状态还要回答“这些结果对下一步搜索有什么约束”。
这个区分很关键。十条想法如果共享一个未经验证的前提,它们不是十份独立证据。一个只会统计赞成票的系统可能越跑越自信,一个会检查共同依赖的系统则应该先停下来验证前提。
2. 两层架构:一层做研究,一层管理研究
Sage-Taiyi 把系统分成对象层和元层。对象层处理科学问题本身;元层评估搜索进展,决定后续行动。二者通过 Monitoring 和 Control 连接。
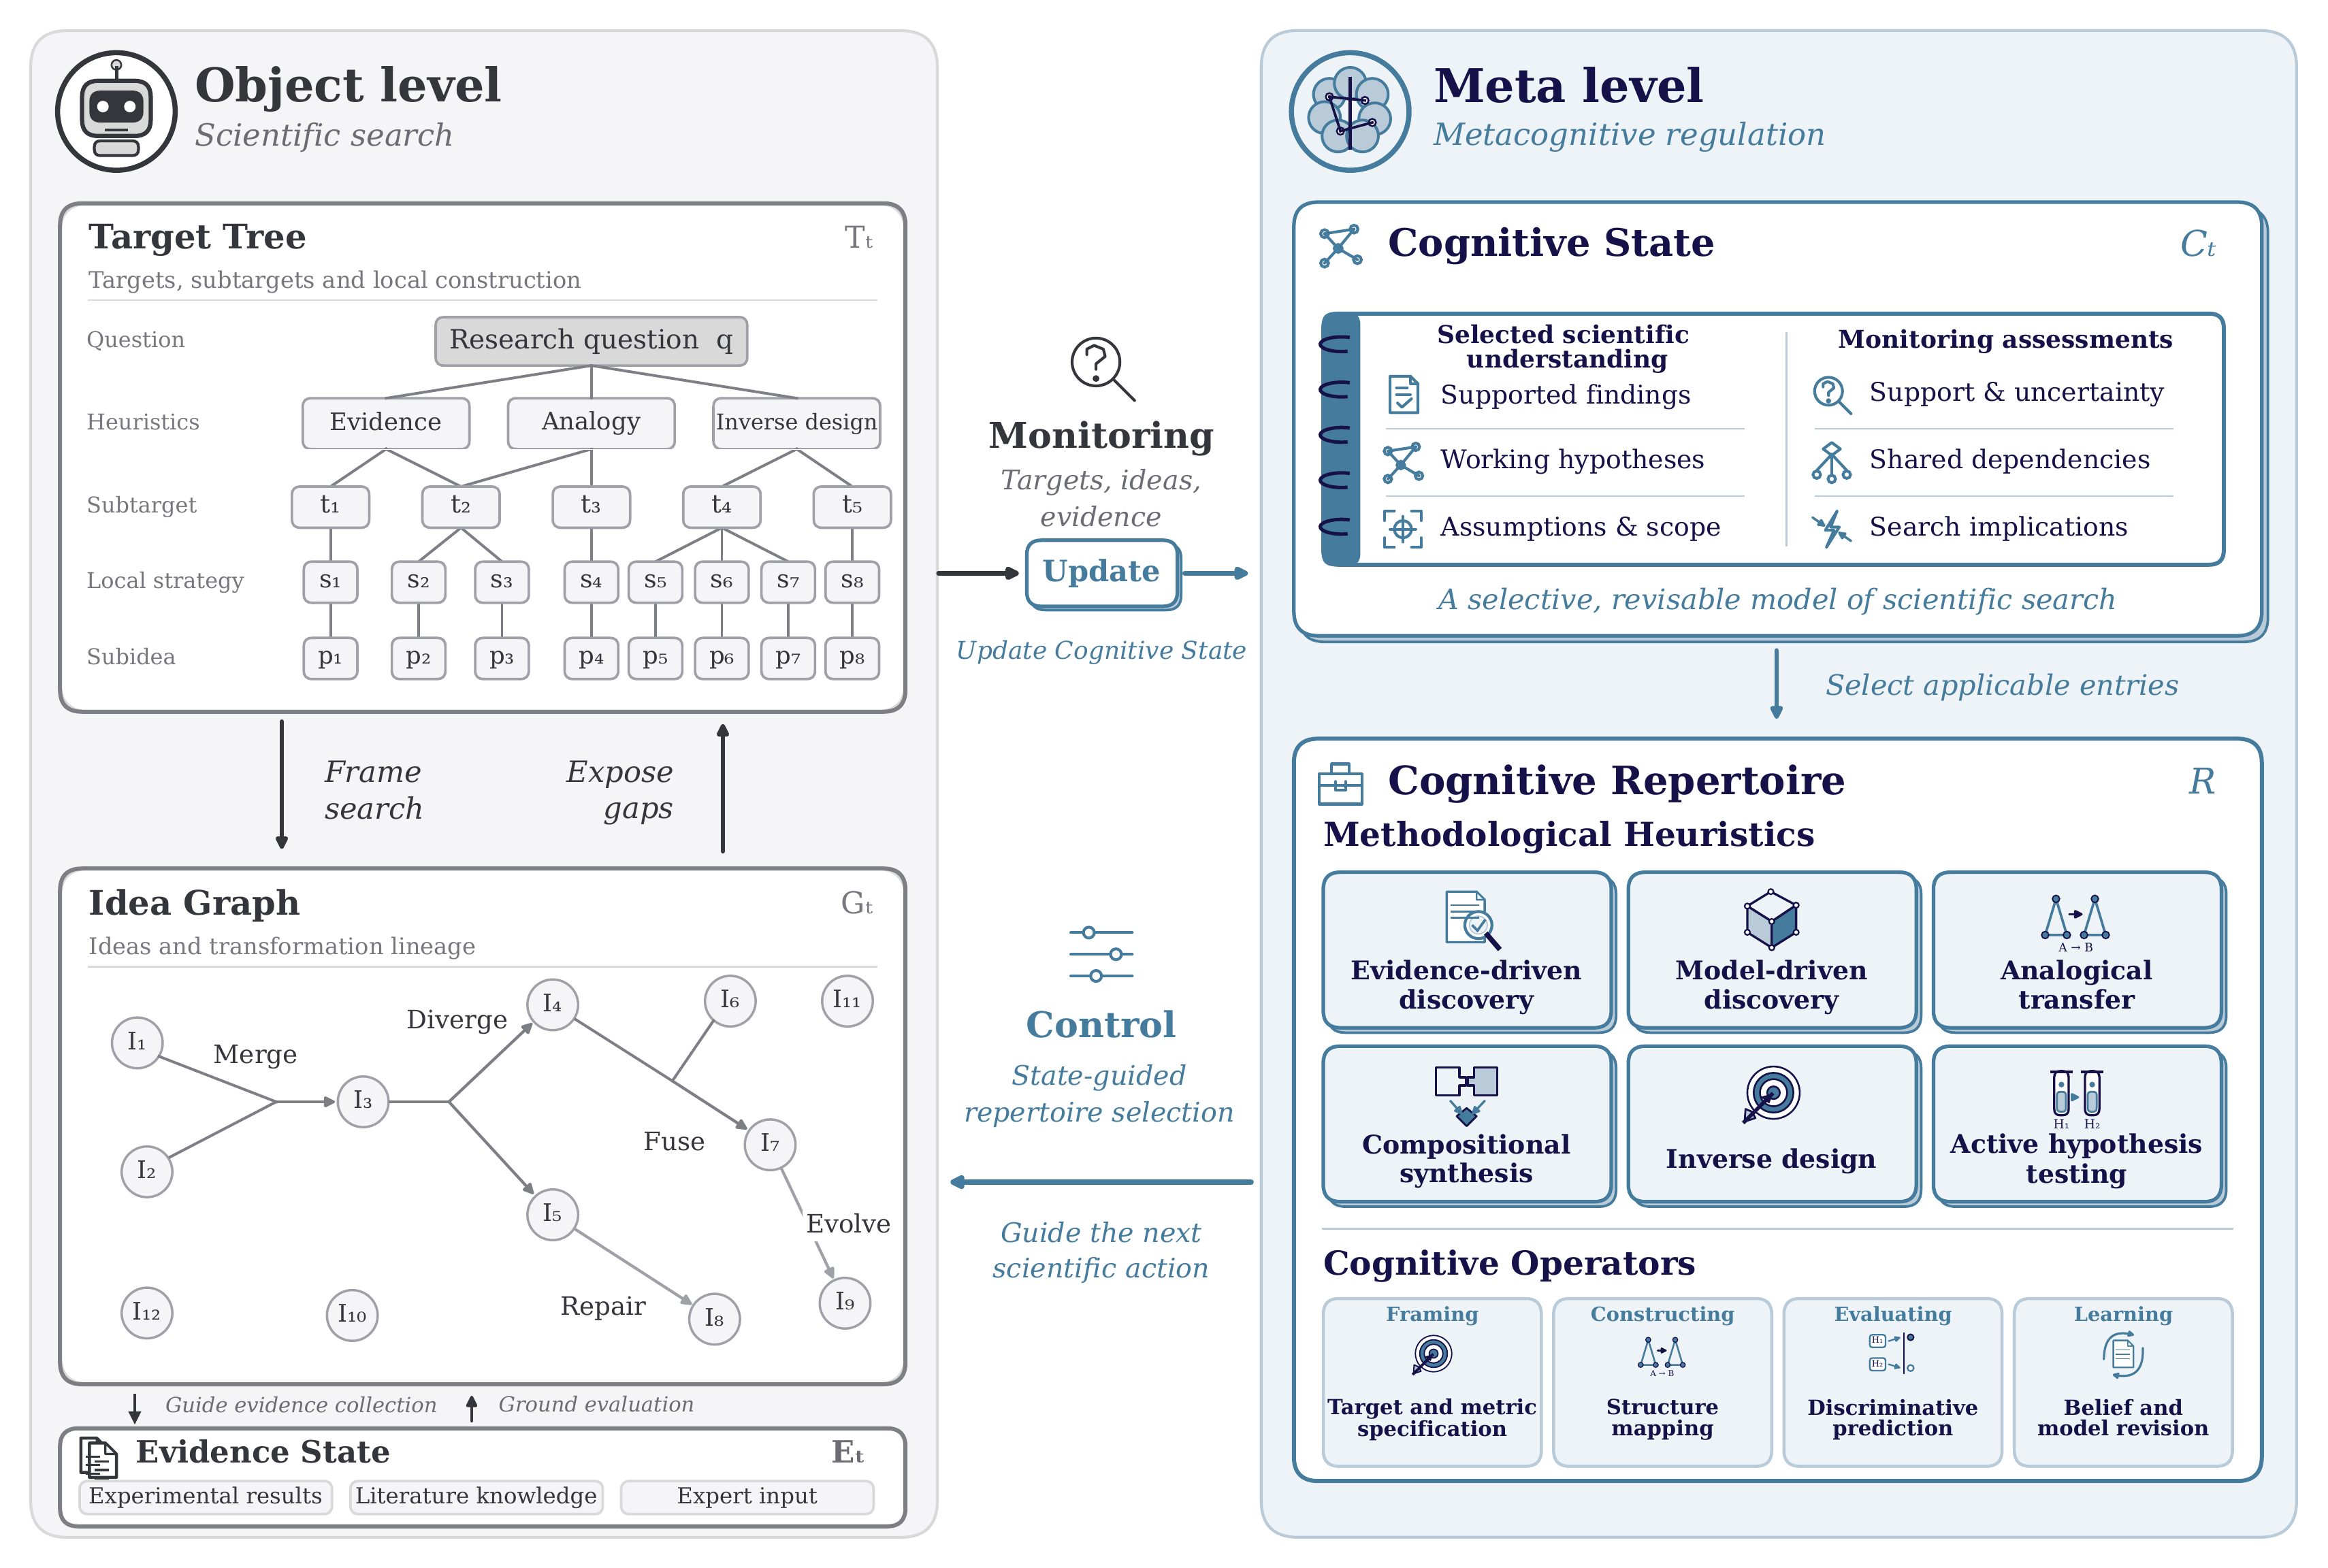
图 2:左侧对象层包含 Target Tree、Idea Graph 和 Evidence State;右侧元层包含 Cognitive State 与 Cognitive Repertoire。监控把目标、想法和证据变成状态更新,控制再根据状态选择方法并指导下一步科学行动。原图来自论文 TeX 源码中的 Figure 2。
对象层在第 \(t\) 个逻辑状态写成:
其中 \(T_t\) 是目标树,\(G_t\) 是想法图,\(E_t\) 是证据状态;元层则维护任务相关的认知状态 \(C_t\) 和可复用认知库 \(\mathcal R\)。注意,\(t\) 表示逻辑状态变化,不是固定时长的轮次。一次文献证据更新、一次想法修复或一次实验返回,都可能推动状态改变。
2.1 对象层:把研究过程变成可追踪的结构
Target Tree:先明确到底要解决哪些子问题。 根节点是研究问题 \(q\),下面挂目标和子目标。每个节点记录科学要求与完成条件,子目标再连接局部策略和子想法。这棵树不是开局写死后就不动了:如果新想法暴露出现有目标没有覆盖的要求,控制机制可以增加或修订子目标,同时保留根问题及其约束。
Idea Graph:保留想法的“家谱”,而非只留最终答案。 每个完整想法要说明机制或设计、支持文献、约束、可检验后果和待查不确定性。节点之间用转换边连接,因此系统能追溯某个方案从哪些父方案演化而来、由哪次评价触发修改。
| 转换 | 它到底做什么 |
|---|---|
| Merge | 合并路线相近的想法,减少重复 |
| Fuse | 检查假设和接口兼容后,组合互补机制 |
| Diverge | 保留原想法,同时打开真正不同的分支 |
| Repair | 修复缺失接口或失效依赖 |
| Evolve | 保留核心机制,改善方案的其他部分 |
这五种操作并不玄乎,和进化搜索、概念组合都有渊源。真正有用的地方在于:不同目标分支的想法可以比较、重组,修改理由也能留下,而不是每轮从零生成一批看起来不同、实则同构的答案。
Evidence State:证据必须带来源和适用条件。 实验结果、计算结果、文献知识和专家意见都进入这里,并链接到相关想法及条件。对象层据此判断哪些机制得到支持、结论在什么条件下成立、哪些解释彼此冲突。新证据到来时,只修订受影响的判断和依赖,不必把整棵搜索树推倒重来。
2.2 元层:不只是记住理解,还要评估搜索是否健康
Cognitive State 装的不是完整日志,而是经过筛选、仍链接来源的科研理解。它包括两类内容:
一类是当前已经知道的事情,例如关键发现、竞争解释、必要假设、适用范围和未解决问题;另一类是监控产生的评价,例如证据是否足够、冲突是否仍未消解、多个想法是否共享同一个潜在失败条件。
说实话,这个“共同依赖”设计比单纯加一个反思 Agent 更打动我。科研搜索里很常见的假进展,就是不同方案反复包装同一假设。系统若只看方案数量,会误以为探索很充分;把共同前提记下来,才知道真正独立的探索有多少。
Cognitive Repertoire 则是方法库。作者整理了十种方法论启发式:证据驱动发现、模型驱动发现、类比迁移、表示驱动重构、组合式综合、逆向设计、约束搜索与规则归纳、主动假设检验、瓶颈驱动重设计、能力驱动的边界扩展。它们不是十条提示词标题那么简单,每条还要说明何时适用、怎样拆目标、怎样协调局部算子,以及如何评价结果。
方法库也接受领域实例化与反馈学习。例如“主动假设检验”进入化学领域后,可以具体化成同位素标记:若两个机制对产物某个原子的来源给出不同预测,就标记反应物并检查产物,而不是泛泛地说“设计实验验证”。
2.3 Cognitive Operators:把大方法拆成可调用的小动作
启发式负责组织整条研究路线,Cognitive Operators 负责局部推理变换。论文把它们归入 Framing、Constructing、Evaluating 和 Learning 四类。
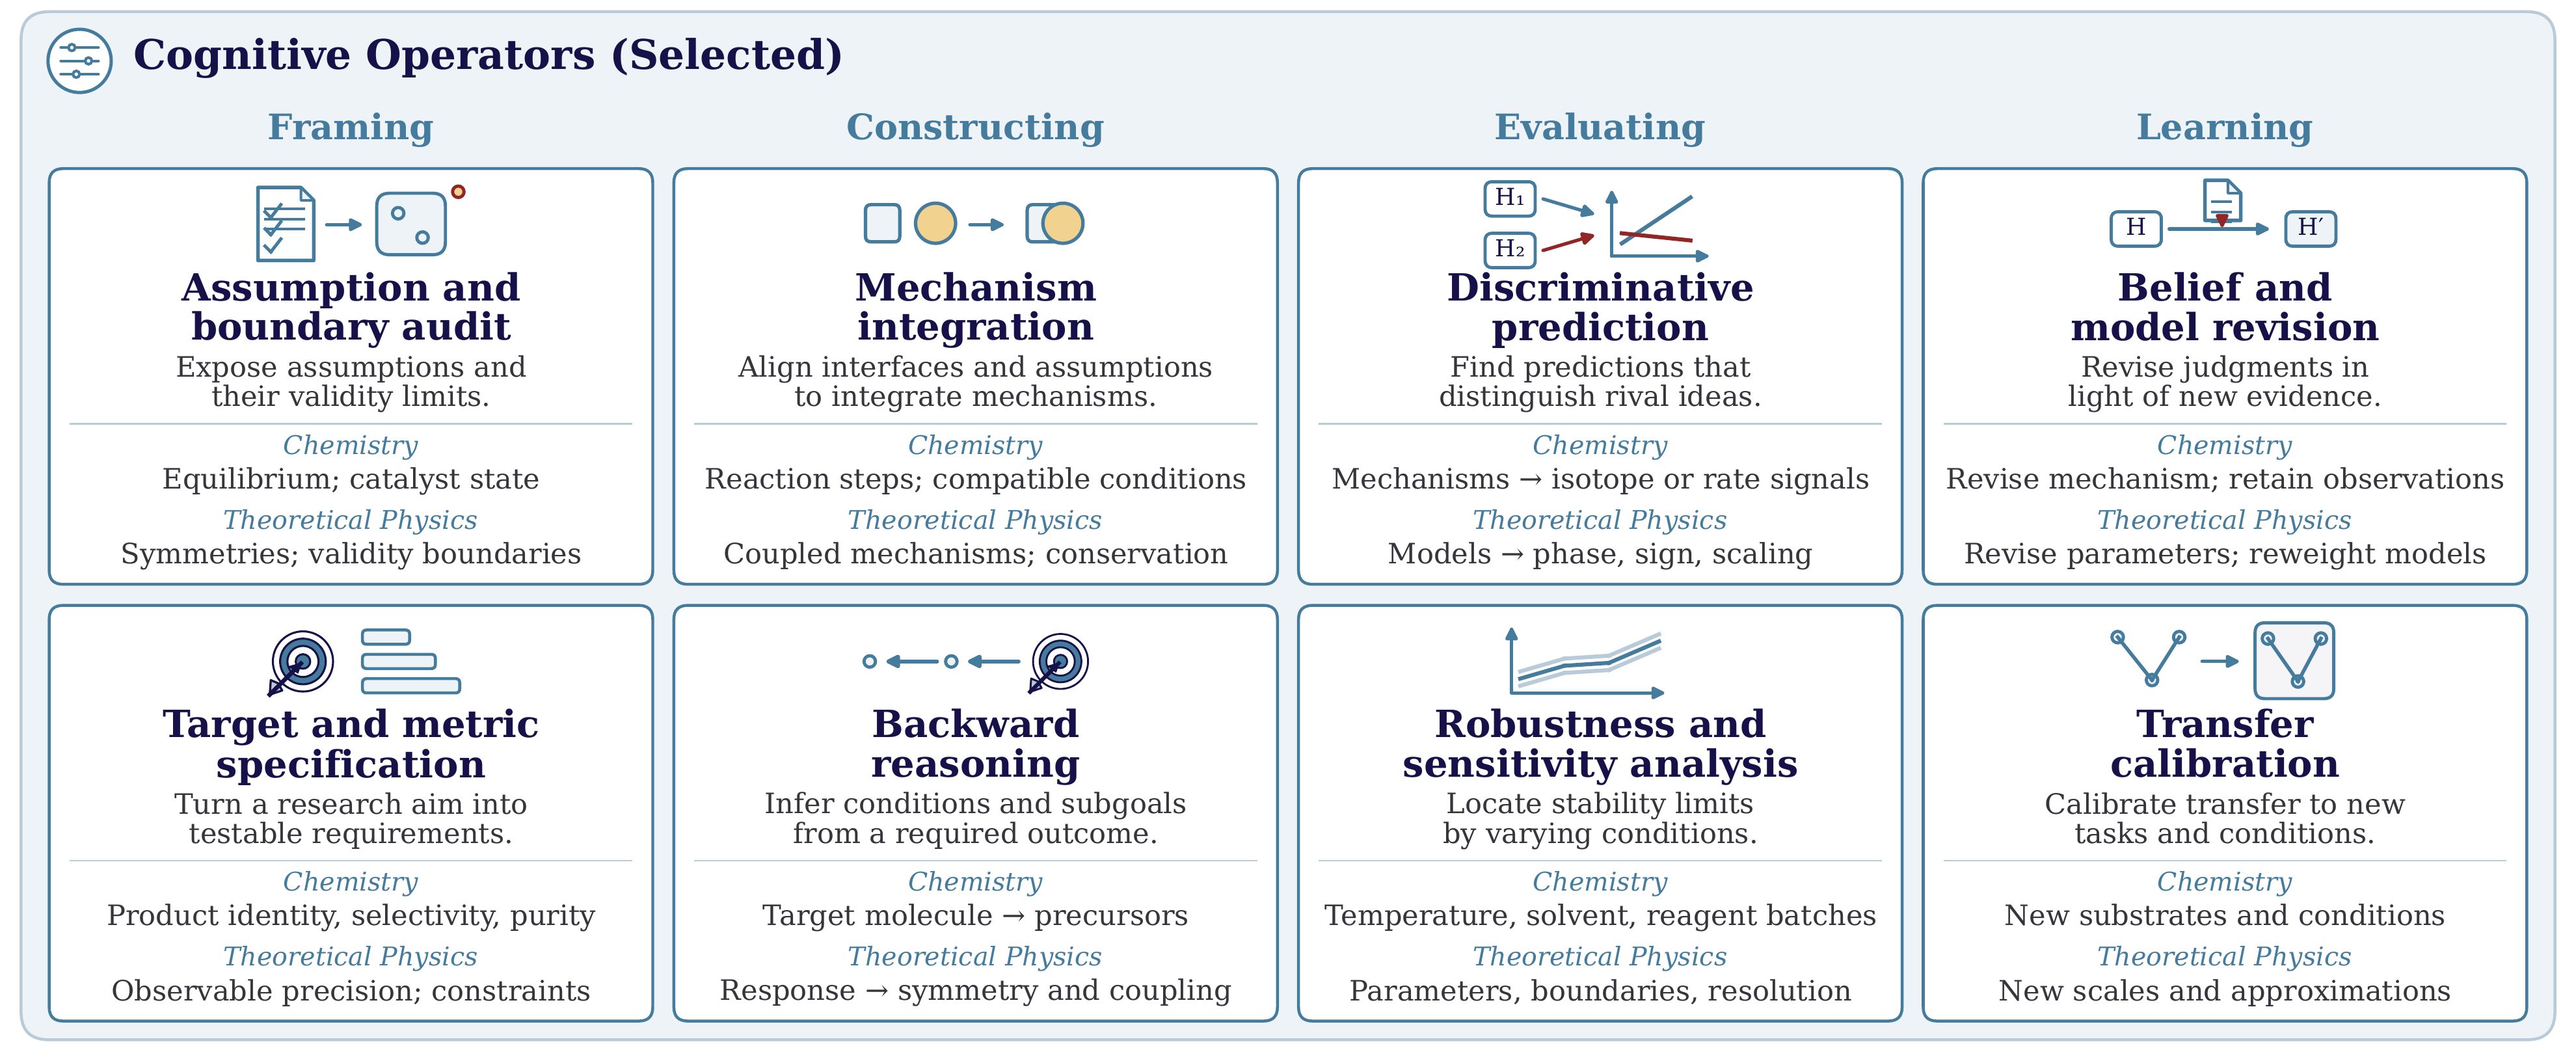
图 4:八个代表性算子分别覆盖假设与边界审计、目标与指标定义、机制整合、反向推理、判别性预测、鲁棒性与敏感性分析、信念与模型修订、迁移校准。每张卡片还给出化学和理论物理中的实例。原图来自论文 Figure 4。
这些算子能作用于目标树、想法图、认知状态,甚至方法库本身。比如“假设与边界审计”在化学里可以检查催化剂状态和反应平衡,在理论物理里则对应检查对称性和有效边界;“迁移校准”要求换到底物、尺度或近似条件后重新确认方法是否适用。
这部分让我有点警惕:分类很整齐,但分类整齐不等于机制真的独立。机制整合与组合式综合、反向推理与逆向设计本来就有重叠。作者也承认类别允许交叠,所以更应把它看成可调用的操作接口,而不是互斥的认知本体。
2.4 Monitoring 与 Control:把“反思”落到搜索决策
监控读取当前认知状态以及相关的目标、想法、评价和证据,更新 \(C_t\);控制再根据更新后的状态,从方法库选择适用条目,并推动对象层搜索:
这三步对应的工程动作很具体:继续当前分支、修订想法、转向另一个目标,或者停止无效分支。如果不需要新构想,研究 harness 可以直接进入执行或验证;如果需要新解释,再调用构思模块,并让子智能体并行探索不同研究路径。
执行结果返回 Evidence State,监控再检查中间结论,形成下一轮控制依据。物理实验和专家参与也走同一条回路。因此 Sage-Taiyi 不是一个训练得到的新模型,而是一套围绕现有大模型搭建的状态表示、方法选择、搜索与执行架构。
3. Taiyi-Bench:不只问“点子好不好”,还问能否重现关键科研决策
论文自建 Taiyi-Bench,把近期已发表研究拆成有向无环图,再围绕关键创新决策构造任务。50 篇论文覆盖地球科学、神经科学、经济学、管理学、物理、生物、化学、环境科学、材料科学和通信工程,共形成 265 个案例级任务。
为降低训练数据污染风险,所选研究首次公开时间不早于 2026 年 3 月 1 日,而主模型 GPT-5.6-Sol 报告的知识截止时间是 2026 年 2 月 16 日。这个设计挺认真,至少比直接挑模型可能背过的经典论文更可靠。
任务从 \(L_0\) 到 \(L_8\) 逐步披露信息。\(L_0\) 只给宽泛背景,要求系统找出根科学问题;后续层级给出问题和已经确立的前置决策,让系统恢复后续关键选择。每个任务要求生成 \(K=10\) 个自包含想法,并附支持理由和判别性测试。Sage-Taiyi 与主要对比 harness 使用 GPT-5.6-Sol high reasoning effort。
| 评价组 | 指标 | 检查什么 |
|---|---|---|
| 历史重发现 | Finding | 能否在 \(L_0\) 识别参考根问题 |
| 历史重发现 | Exact | 单个提案是否完整恢复当前层级的参考决策 |
| 历史重发现 | Coverage | 提案集合累计恢复了多少参考决策 |
| 历史重发现 | Lookahead | 单个提案最多能恢复多少当前及下游决策,且前置条件必须成立 |
| 开放式构想 | Novelty | 是否提供超出已有文献的科学内容 |
| 开放式构想 | Effectiveness | 机制与判别性测试能否回应研究缺口 |
| 开放式构想 | Feasibility | 能力、科学约束和设计是否可行 |
| 开放式构想 | Diversity | 多个提案是否属于真正不同的机制类别 |
文献接地验证器依据决策级 rubric 和机制等价标准打分,分数为 0–100。Rediscovery 与 Open-ended 各取四项均值,Overall 再取两组均值。
3.1 主结果:八项指标全部第一,但绝对分数也暴露了难度
下面保留四种有代表性的配置,数值直接对应论文 Table 3。完整实验比较了 11 种系统配置。
| 系统 | Finding | Exact | Coverage | Lookahead | Rediscovery Avg. |
|---|---|---|---|---|---|
| Sage-Taiyi | 79.70 | 19.53 | 40.69 | 38.55 | 44.62 |
| AI Scientist-v2 | 72.54 | 16.74 | 32.37 | 31.62 | 38.32 |
| Claude Code + GPT-5.6-Sol | 78.30 | 13.95 | 35.87 | 33.04 | 40.29 |
| Codex + GPT-5.6-Sol ultra | 74.68 | 11.63 | 30.18 | 27.22 | 35.93 |
| 系统 | Novelty | Effectiveness | Feasibility | Diversity | Open-ended Avg. | Overall |
|---|---|---|---|---|---|---|
| Sage-Taiyi | 70.54 | 87.81 | 52.45 | 42.33 | 63.28 | 53.95 |
| AI Scientist-v2 | 55.20 | 87.23 | 47.73 | 39.40 | 57.39 | 47.85 |
| Claude Code + GPT-5.6-Sol | 43.10 | 67.56 | 50.21 | 31.07 | 47.98 | 44.14 |
| Codex + GPT-5.6-Sol ultra | 43.74 | 67.88 | 49.99 | 32.11 | 48.43 | 42.18 |
Overall 从最强基线的 47.85 提到 53.95,涨 6.10 个点。最大的相对优势在 Novelty:70.54 对 55.20,论文给出的相对增幅是 27.8%。Effectiveness 则只比 AI Scientist-v2 高 0.58 分,说明基线已经很会把方案写得“对准问题”,真正拉开差距的是新机制和选择覆盖。
不过,别只盯着“八项第一”。Exact 只有 19.53,Feasibility 只有 52.45。完整恢复一条带所有前置条件的科研路线仍然很难,构想的可执行性也远没到可以放心交给实验室的程度。这两个数比总分更能说明任务难度。
成对比较给出了同样的排序。Sage-Taiyi 的 ELO 为 1322.5,AI Scientist-v2 为 1184.2;两者直接比较时,Sage-Taiyi 的胜率为 66.3%。
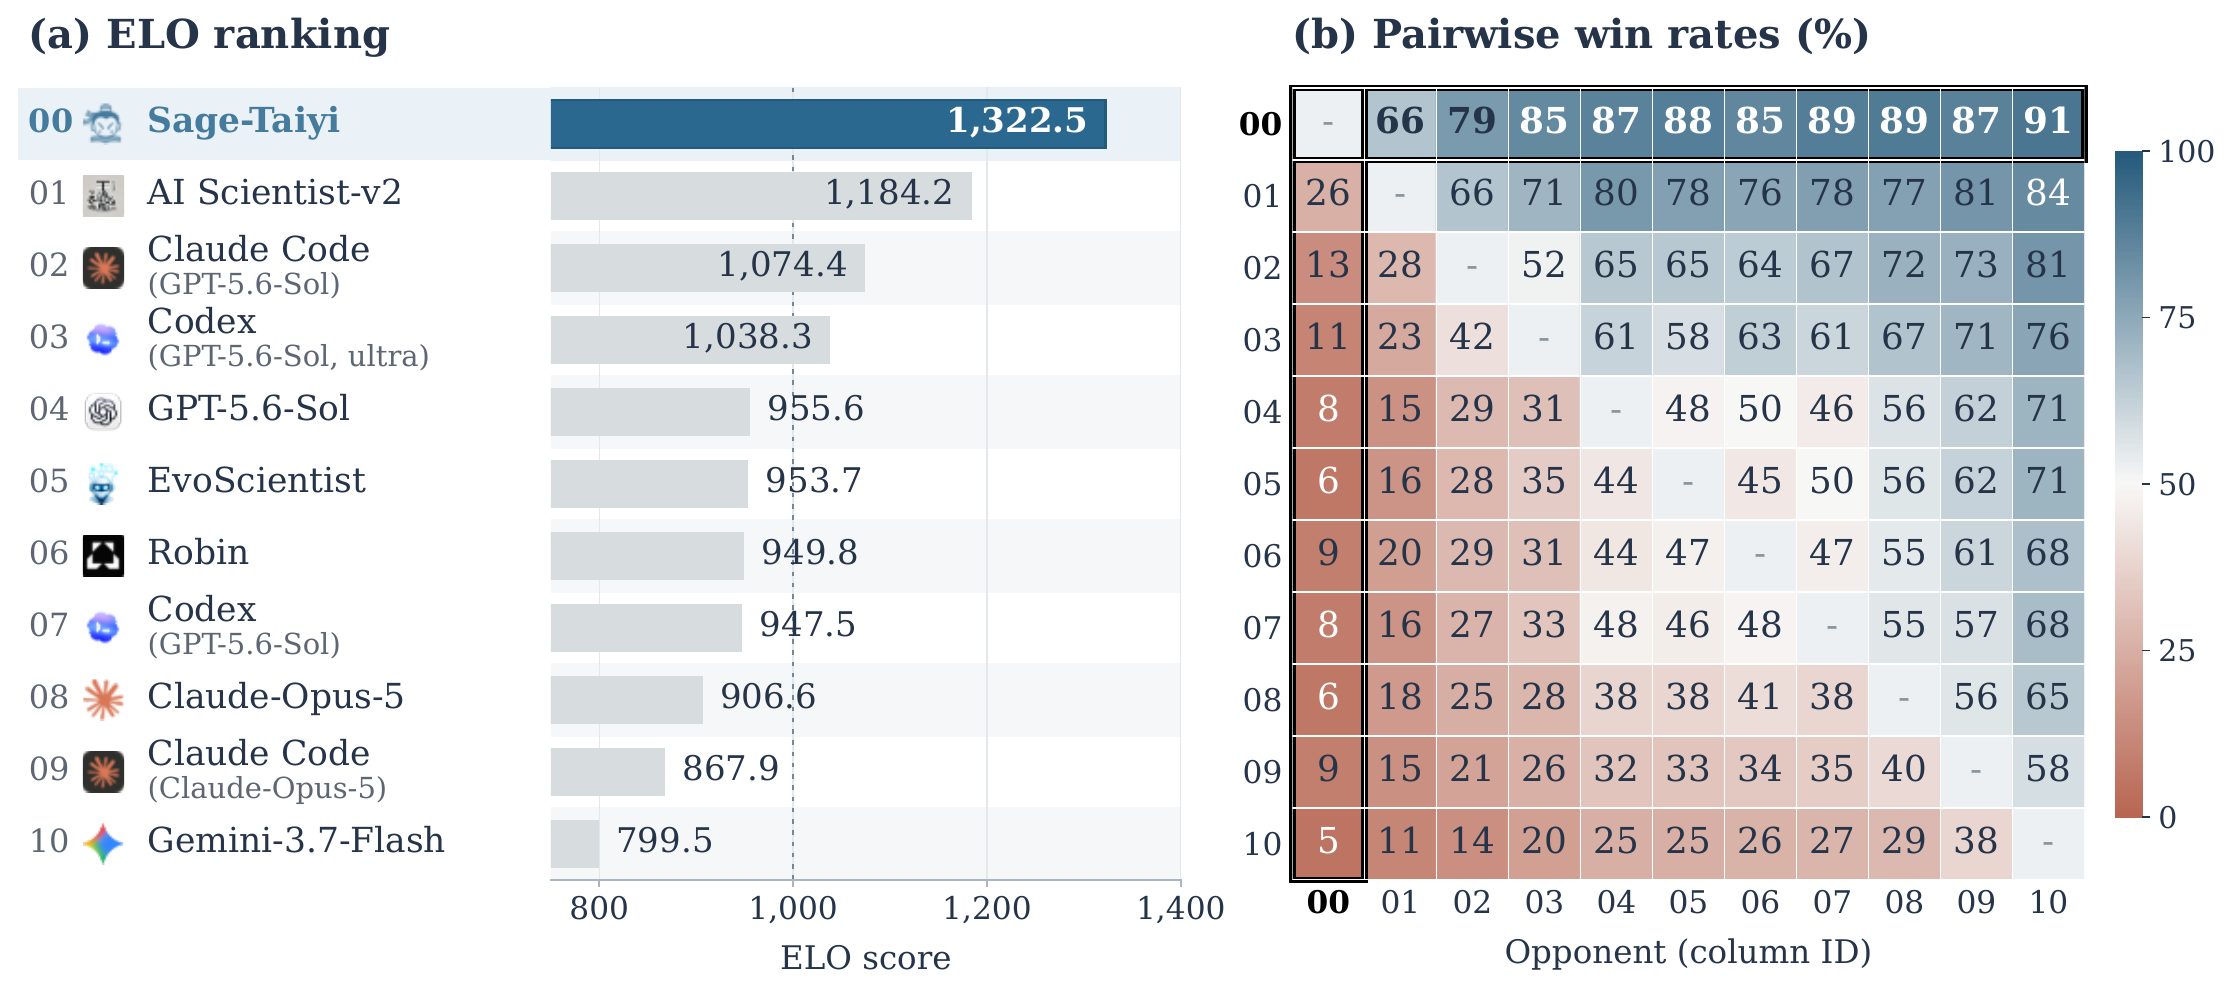
图 7:左图是 11 种配置的 ELO 排名,右图是保留平局分母的成对胜率。Sage-Taiyi 对 AI Scientist-v2 的热图值四舍五入为 66%,正文给出的精确值为 66.3%。原图来自论文 Figure 7。
3.2 更快是墙钟时间更快,不是证明总计算量更低
Sage-Taiyi 的平均生成时间为 29.9 分钟,AI Scientist-v2 为 39.3 分钟,Codex ultra 为 44.8 分钟。独立分支并行探索,确实能缩短墙钟时间。
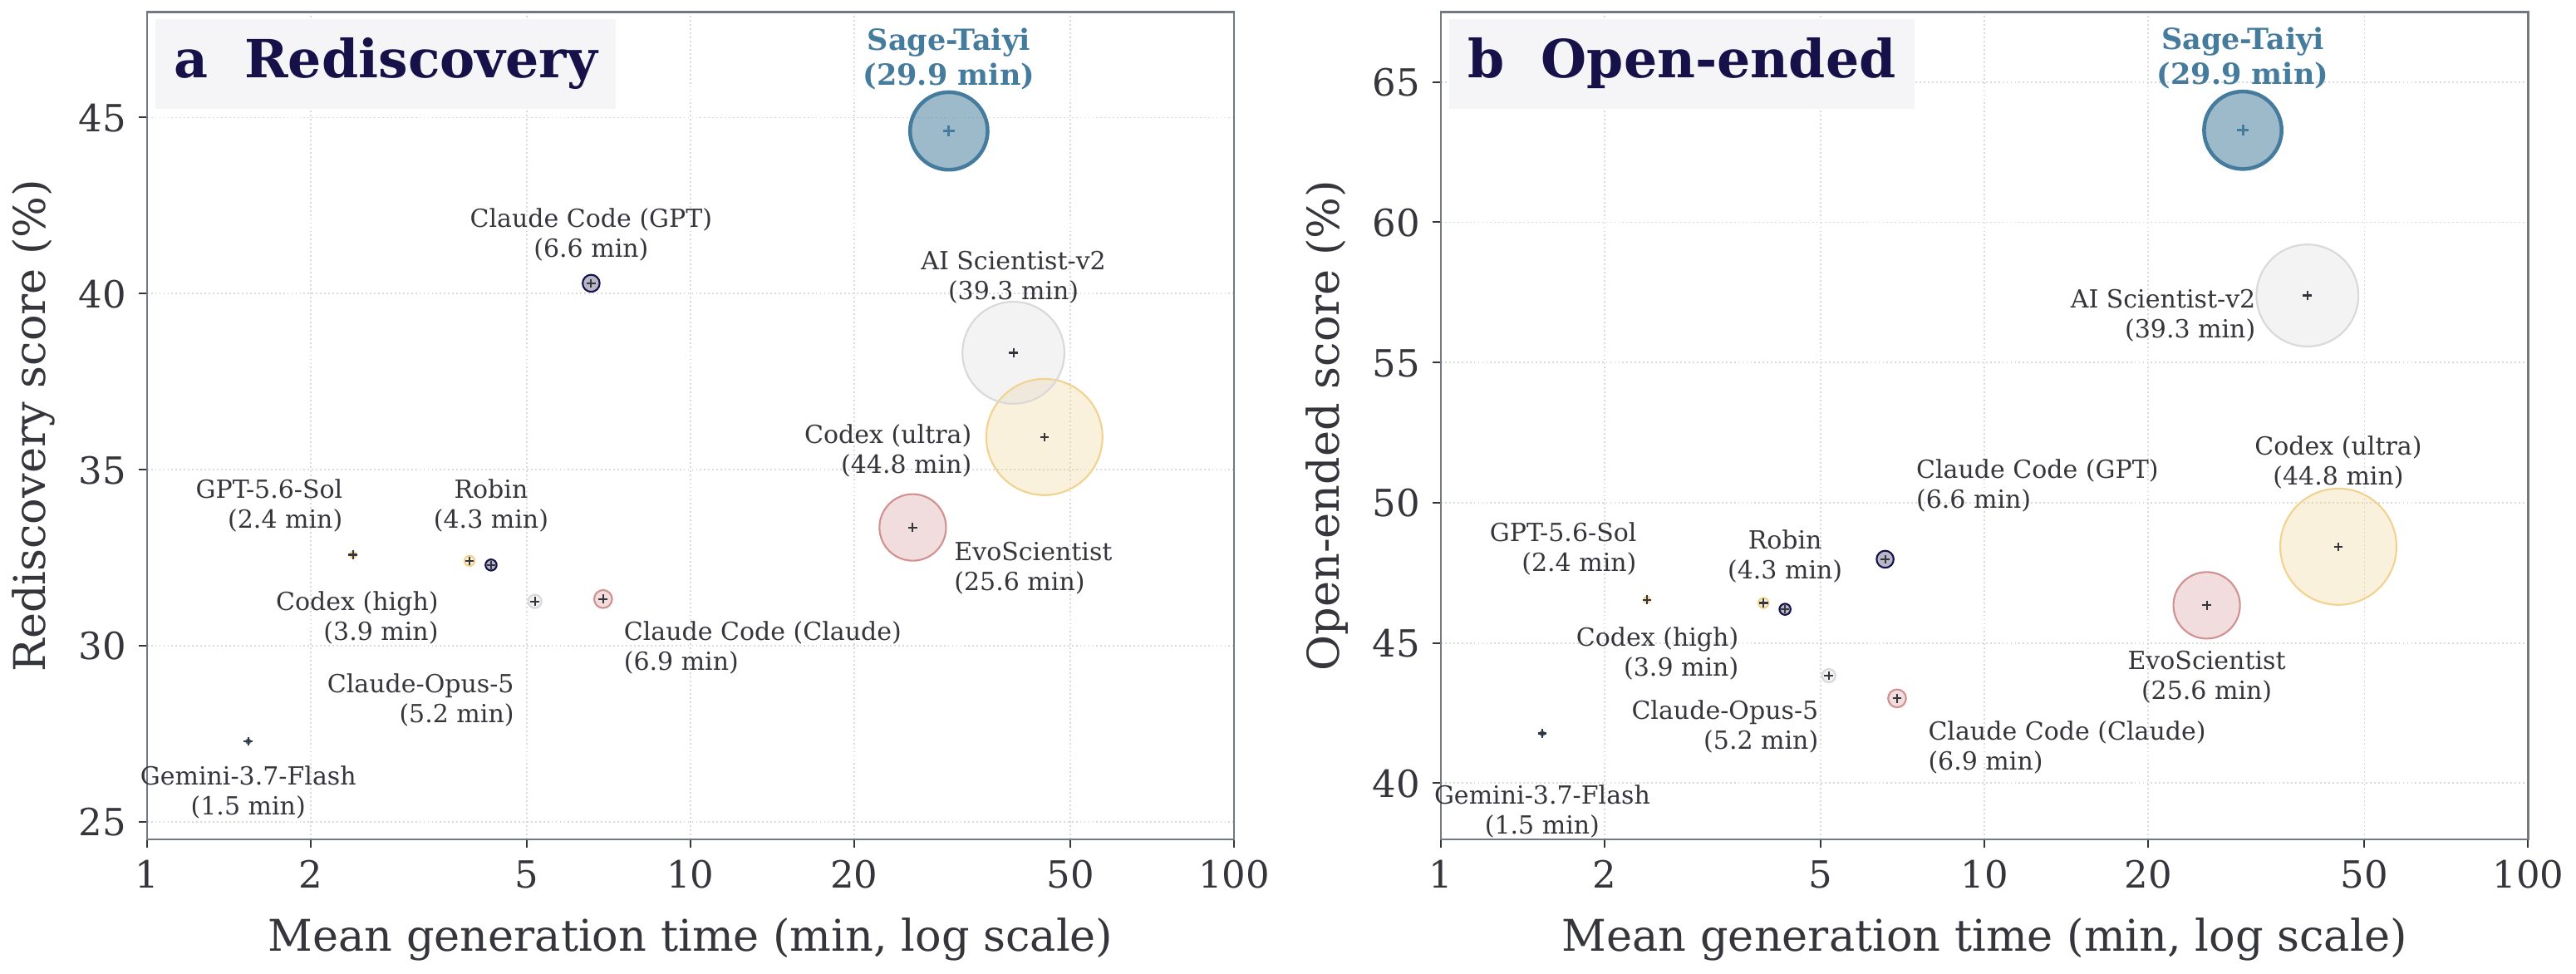
图 8:横轴为对数刻度的平均生成时间,纵轴分别为 Rediscovery 与 Open-ended 得分,圆圈直径也随时间增大。Sage-Taiyi 位于两个面板的高质量区域,同时比 AI Scientist-v2 和 Codex ultra 更快。原图来自论文 Figure 8。
但这里要说句实话:并行分支减少等待时间,不等于减少 token 总量或费用。正文没有给出统一的 token、API 成本或总计算开销,所以“更高质量、更少时间”成立,“更便宜”还不能从这张图推出来。
跨学科结果显示,在图 9 展示的四个 GPT-5.6-Sol 系统中,Sage-Taiyi 于十个学科都取得最高 Overall,对各学科最强基线的领先幅度为 1.9–9.4 分;从 \(L_0\) 到 \(L_8\) 也都排名第一。这个一致性比单一平均分更有说服力,但各学科的任务数和后续层级目标并不相同,不宜把雷达图上的每一分都当作等难度比较。
3.3 两个外部基准:优势延续,规模仍有限
在 AgentIdeaBench 的 40 个子领域上,所有本地比较系统都使用 GPT-5.6-Sol。Sage-Taiyi 的加权均分为 7.195,AI Scientist-v2 为 6.852;前者在原创性、影响力、可行性、清晰度和具体性五项都取得最高均值,其中原创性和可行性分别高 0.400、0.425 分。
在 IG-Arena 的 30 个前沿问题上,Sage-Taiyi 的本地评测平均 PES 为 87.634。这里需要留心,图 11 同时使用本地结果与已发表的 Question-setting 参考分数,而且纵轴经过截断。它支持“外部任务上也有竞争力”,却不适合拿来制造视觉上的巨大差距。
4. 五个真实合作:最有价值的部分,也有最容易被过度解读的部分
构想 benchmark 再高,也可能只是会写研究计划。Sage-Taiyi 进一步做了五项专家引导的合作,覆盖化学、材料和工程。专家参与想法选择与验证,Taiyi-Optimizer 在给定条件或设计空间中搜索,测量或仿真结果再返回系统。
| 领域 | Sage-Taiyi 参与形成的内容 | 最终结果 | 证据类型 |
|---|---|---|---|
| 金属催化 | 钴催化四取代联烯基酮路线与条件空间 | 模型反应从微量提升到 84% 分离产率 | 物理实验 |
| 光化学 | 杂芳胺位点选择性烯丙基胺化路线 | 产率从 13% 提到 68.7%,正文取整为 69% | 物理实验 |
| 超材料 | 多层电磁滤波器拓扑与厚度约束修订 | 阻带平均透射 6.2%,通带 94.5% | 电磁仿真 |
| 镁合金 | 成分与热处理联合设计 | 重复实验平均抗拉强度 342 MPa | 物理实验 |
| 压气机 | 离心压气机构型与几何参数优化 | 压比 4.0 时叶轮效率 91.5% | CFD 仿真 |
这张表最值得保留的是“证据类型”一列。五项结果不是同一种验证:化学和合金有实物实验,超材料和压气机目前是计算结果。把它们都写成“AI 完成五项科学发现”,会遮住很重要的差别。
4.1 钴催化羰基化:从机制路线到 84% 产率
这个任务难在交叉选择性:两个不同碳片段要和同一个羰基碳连接,同时抑制对称酮副产物。Sage-Taiyi 借鉴不对称脲合成中的“同步识别”思路,让两个伙伴走不同激活路径。有机锌亲核试剂进攻配位 CO 的 Co(III) 中心形成酰基钴中间体;另一路通过极性反转产生联烯基自由基,再与中间体偶联,得到不对称联烯基酮。
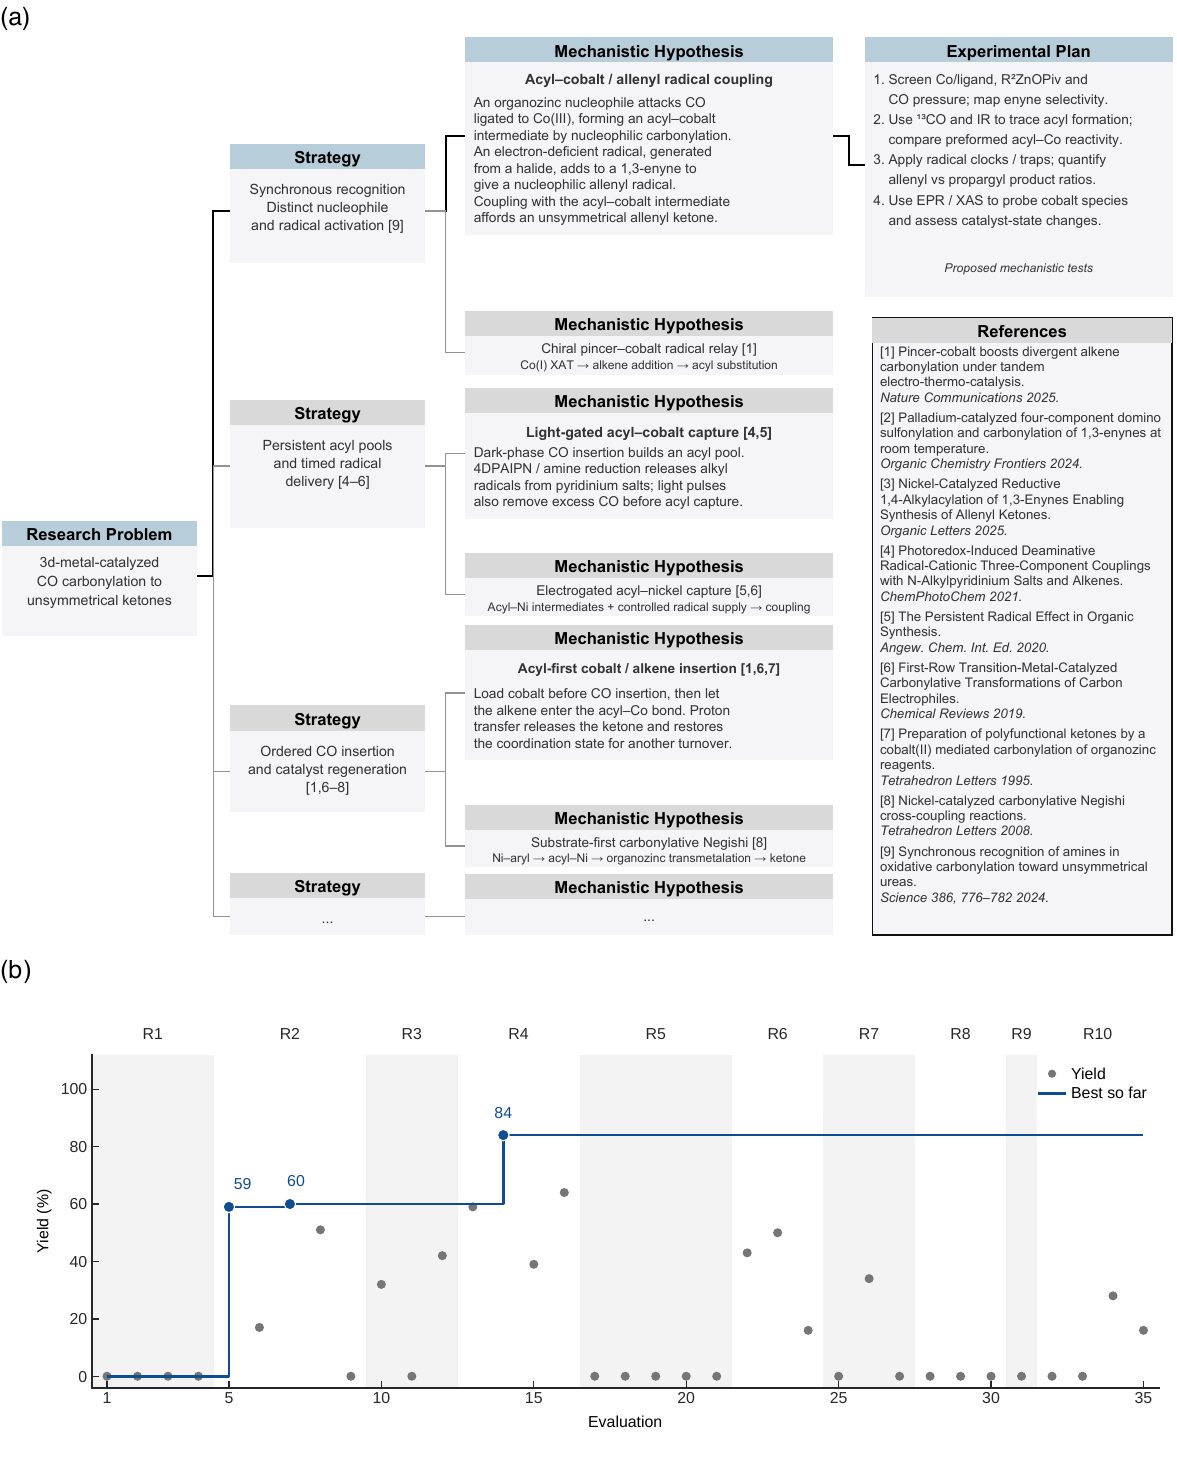
图 13:上半部分保留多条机制分支、候选实验和文献依据,高亮路线把亲核羰基化、极性反转与酰基钴/联烯基自由基偶联组合起来;下半部分展示 10 轮、35 次评价的产率轨迹,累计最佳在第 4 轮达到 84%。原图来自论文 Figure 13。
初始条件只产生微量目标产物。贝叶斯优化最终把钴源改为 Co(acac)\(_2\),双齿 dtbpy 配体改为三齿 L20,并把 EtZnBr 改为 EtZnOPiv;溶剂、温度和时间保持不变,分离产率达到 84%。优化条件还用于氟比洛芬、吡丙醚和水杨苷衍生物,相应产物产率为 40%、74% 和 86%。
这个结果很强,但要分清贡献:Sage-Taiyi 提出路线与搜索空间,Taiyi-Optimizer 做贝叶斯优化,专家选择并实施验证。它证明的是人机协作链路能产出有用结果,不是元认知模块单独把产率推到 84%。
4.2 光催化烯丙基胺化:69% 背后有 61 次评价
第二个化学案例针对杂芳胺与烷基烯烃的位点选择性偶联。系统把芳香胺亲核性低、氧化电位高作为关键障碍,设计胺单电子氧化生成氨基自由基阳离子、加成到烯烃,再由 cobaloxime 介导氢原子转移的路线。
初始产率为 13%。经过 5 轮、61 次评价,溶剂从 DCE 换为 PhCF\(_3\),加入 2 当量 PhCOOH,反应时间从 18 小时延长到 36 小时,最佳定量产率为 68.7%。这个数字很有竞争力,不过也提醒我们:结果来自路线提出和大量条件搜索的合力,不能只摘一个 69% 就宣称自动发现机制已经解决。
4.3 超材料:真正关键的是改掉一个过紧的约束
电磁滤波器要在 8–12 GHz 阻带抑制透射,同时在 14.5–15.5 GHz 通带保持高透射。系统提出五种结构,专家选择 B:Jerusalem-cross 掩膜、Drude 线栅与 I 形掩膜、镜像 I 形掩膜,中间夹三层石英陶瓷。
初次优化固定了基底厚度,通带表现不理想。系统从反馈中把“固定厚度”识别为瓶颈,随后放开厚度重新搜索。这个案例很贴合论文的主张:不是继续在原空间里更努力,而是修改空间本身。
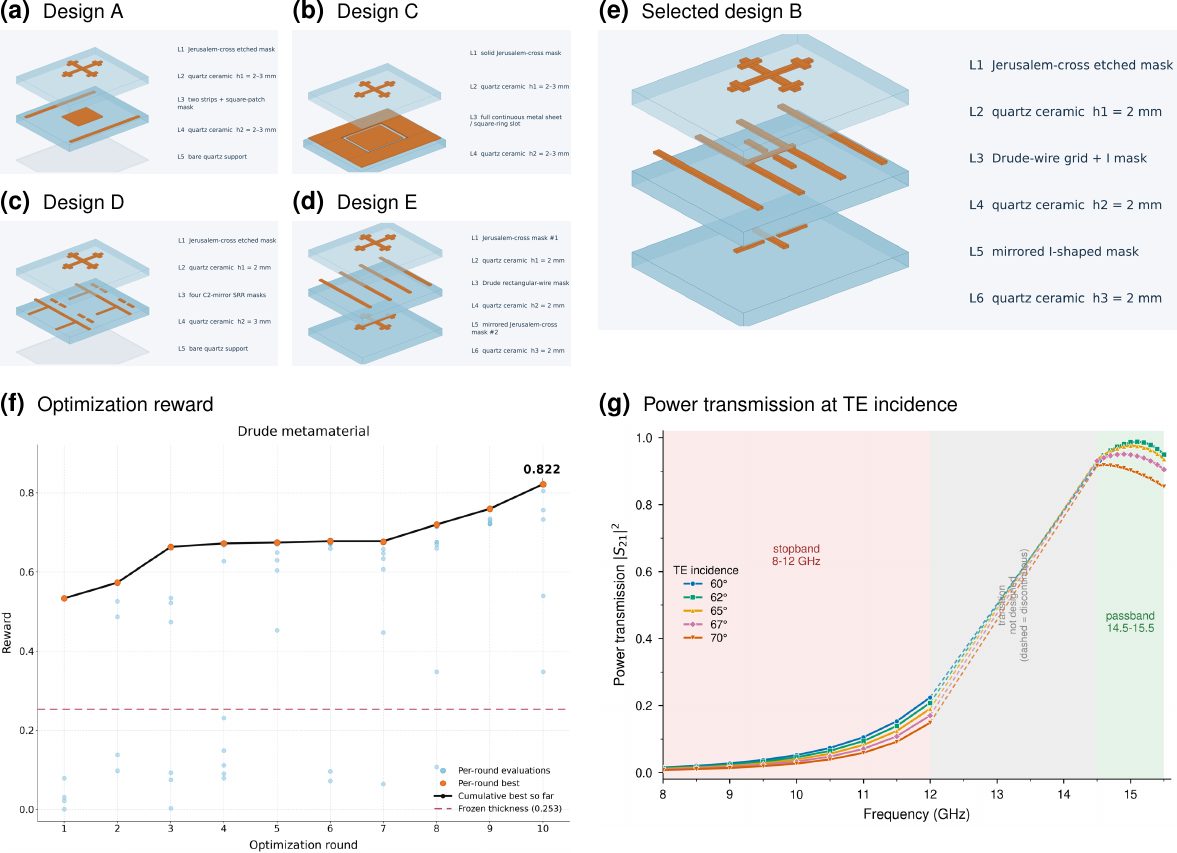
图 16:面板 a–e 展示候选结构与最终 B 设计;面板 f 中固定厚度参考奖励为 0.253,十轮后最佳奖励为 0.822;面板 g 给出 60° 至 70° TE 入射下的透射频谱。原图来自论文 Figure 16。
最终仿真阻带和通带平均透射分别为 6.2% 和 94.5%;专家设计的简单鱼骨结构对应 9.5% 和 87.4%。这里至少有一个同任务专家参照,比只展示优化曲线更有分量。但它仍是仿真验证,制造误差、材料参数漂移和实测角稳定性还没有在这项结果中回答。
5. 我的判断:架构很有启发,因果归因还没做完
这篇论文让我兴奋的地方,不是把“元认知”三个字贴到 Agent 上,而是把几个容易被忽略的研究对象变成了显式状态:证据支持什么、假设在哪里失效、不同方案共享哪些依赖、什么时候该改变目标或方法。对于长程科研 Agent,这些东西比再增加一个“批评者”角色更接近真正的瓶颈。
但问题也摆在明面上。
没有组件消融,无法定量回答元认知贡献了多少。 正文没有分别移除 Cognitive State、Cognitive Repertoire、Monitoring、Control 或 Idea Graph 的对照,也没有“相同并行分支数、相同工具调用预算,只关闭元层调控”的实验。于是 6.10 分的 Overall 提升可能同时来自更充分的搜索、方法先验、并行编排和状态管理。论文证明了整套系统有效,却没有把标题里的核心机制单独隔离出来。
Taiyi-Bench 与系统来自同一团队,评价链条需要更强独立复核。 论文说明文献接地验证器与专家判断有良好一致性,这是加分项;但正文没有给出人机一致性的具体数值,也缺少外部团队在冻结 rubric 下的复评。历史重发现提供较硬的参照,开放式 Novelty 和 Effectiveness 仍更依赖评价器设计。
基线比较聚焦构想,不等于完整科研系统对决。 为统一任务,AI Scientist-v2、EvoScientist 和 Robin 只保留构想阶段,后续实验执行和报告生成被省略。这对 Taiyi-Bench 是合理的控制,却也改变了这些系统原本的产品边界。因此结论应限定为“科学构想能力更强”,不能外推成“端到端自动科研全面更强”。
五项合作证明可落地,不证明高自主性。 专家负责选择与验证,优化器负责条件搜索,化学实验和材料测试由人完成。最准确的定位是专家引导的 AI co-scientist,而非无人值守科学家。若要证明元认知调控本身带来实验收益,还需要“同一优化器、同一实验预算、人工路线或禁用元层”的对照。
反馈学习目前更像架构承诺,而不是已验证的学习曲线。 论文描述跨案例、跨学科经验可以修订通用认知库,但没有展示随着任务积累,迁移成功率或样本效率怎样变化。坦白讲,我也还不确定这种由大模型维护的认知状态在几十轮后会不会积累错误摘要;保留来源能缓解问题,却不能自动保证修订永远正确。
所以我会把它归为有真实验证支撑的系统架构与工程整合,而不是新的基础模型训练突破。这个定位并不低。能把 265 个构想任务、两个外部基准和五项真实合作连起来,本身就是很大的工程量。
6. 如果你在做科研 Agent,可以先借这三件事
不一定需要复刻整套 Sage-Taiyi,有三个设计可以单独拿出来试。
给共同前提建台账。 不要只存想法列表;为每条想法记录依赖假设、证据来源和适用边界。当多个活跃分支共享未验证前提时,优先安排能区分该前提的实验,而不是继续扩写方案。
把分支控制写成显式动作。 每次监控后只允许几类可审计决策:继续、修复、融合、转向、停止、请求验证。这样评估系统时,可以统计错误分支存活多久、转向是否发生得太晚,而不是只看最后一份报告。
把“改搜索空间”纳入优化。 超材料案例里,放开固定厚度比继续调几何参数更关键。工程上可让优化器定期报告约束敏感度,再由人或控制模块判断哪些约束是真要求、哪些只是历史惯性。不过这一步必须保留专家审批,否则系统也可能通过放宽必要约束来“优化”出无意义答案。
如果后续工作补上严格的元层开关消融、token 成本、独立专家复评,以及固定实验预算下的真实对照,这套主张会扎实很多。现在这篇论文已经足够说明一件事:科研 Agent 的下一轮竞争,可能不只是谁生成得更多,而是谁更清楚自己为什么继续、为什么转向、为什么停下来验证。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我