2.75 倍加速背后:InfraRSI 如何让训练系统边试错、边进化
把一个训练仓库交给 Agent,只说一句“让它跑得更快”,会发生什么?
它可能真的写出更快的 CUDA kernel,也可能偷偷缩小 batch、少做一步 optimizer update,或者把一段计算挪到计时器之外。更棘手的是,有些优化单看很好,组合起来却直接 OOM;同一个开关在 H20 上是灵药,换到 H100 反而拖慢训练。
InfraRSI 盯上的不是“让模型再生成几个代码补丁”,而是这个更难、也更贴近生产的问题:怎样让 Agent 的每次提速都可信、可复现,还能把经验带到下一块 GPU 上。
核心摘要
InfraRSI 是一个面向分布式 LLM 训练的智能体优化框架。它用五阶段流程锁死任务边界,联合搜索启动参数与源码补丁,再用全局耗时模型和包含 OOM 失败样本的内存模型指导搜索。四个 dense 与 MoE 工作负载上,最高加速 2.75 倍,四任务几何平均加速 1.83 倍,平均 MFU 从 17.4% 升至 30.0% 的水平。我觉得它最值钱的不是“RSI”这个大招牌,而是把验证、失败归因、资源计费和跨硬件经验放回同一个闭环;它更像一套严谨的训练基础设施实验系统,而不是会自主重写下一代模型的科幻机器。
论文信息
- 标题:InfraRSI: Harnessing Recursive Self-Improvement for Training Infrastructure
- 作者:InfraRSI Team, Yuchuan Tian, Haocheng Mei, Ye Yuan, Chao Xu, Boxun Li, Guohao Dai, Kai Han, Allen Chen, Yunhe Wang, Yu Wang
- 机构:TokenRhythm Technologies、Peking University、Infinigence AI、Shanghai Jiao Tong University、Tsinghua University
- 时间:2026 年 11 月 8 日提交,v1
- 论文:https://arxiv.org/abs/2611.11558
- 代码:https://github.com/TokenRhythm/InfraRSI
- 项目页:https://infrarsi.github.io
为什么单个 kernel 很快,训练任务却未必更快
FunSearch、AlphaEvolve 这类系统已经展示了“模型提候选、程序评估、结果反哺搜索”的威力。到了训练基础设施,问题突然变得不那么听话。
单个算子的输入形状、输出容差和运行时间通常都能快速测清;完整训练任务却同时牵着数据、并行策略、通信、显存和数值路径。你打开 torch.compile,可能减少 kernel launch,也可能撞上某个 fused kernel;你关闭 activation recomputation,计算少了,显存却先爆了;你增加 tensor parallel,GEMM 可能变快,AllReduce 又把收益吃回去。
论文给出的对照很直观。
| 维度 | 算法或代码进化 | 单 kernel 合成 | InfraRSI 面对的训练系统 |
|---|---|---|---|
| 优化粒度 | 单个启发式函数或脚本 | 独立 CUDA/Triton kernel | 启动参数与多栈源码补丁 |
| 试验规模 | 约 \(10^3\) 到 \(10^4\) 次 | 约 \(10^2\) 到 \(10^3\) 次 | 多 GPU 上通常只有 10 到 20 次 |
| 噪声 | 较低 | 较低 | 约 0.04% 到 6% 以上 |
| 正确性 | 测试集或验证分数 | 张量误差 | 固定任务契约、16 项不变量与源码路径审计 |
| 可复用资产 | 任务代码池 | 算子库 | 跨硬件先验与已审计补丁位置 |
这里有个很现实的预算差异:kernel 搜索可以失败上千次,多 GPU 训练搜索失败十几次就已经开始心疼账单了。失败样本不能只是日志里的红字,它们必须成为下一次决策的信息。
五阶段生命周期:先把“什么算快”说清楚
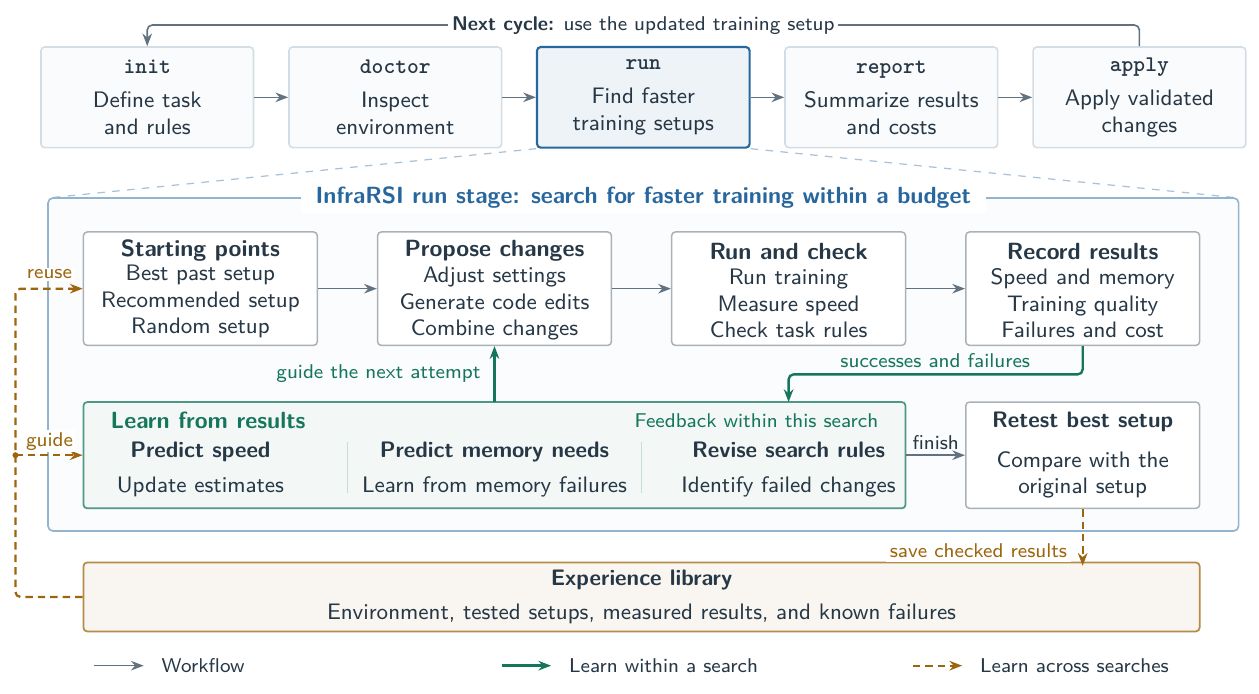
图 1:上方是 init、doctor、run、report、apply 五阶段;下方展开 run 内部的多起点搜索、执行检查、速度与内存学习、最佳候选复测。绿色实线表示一次搜索内的反馈,金色虚线表示经验库跨搜索反馈,顶部回路把已更新的训练配置带入下一轮。
图中最重要的结构不是五个方框,而是两条时间尺度不同的反馈线。一次 run 内,实测速度和显存修正当前搜索;多次 run 之间,只有通过检查的结果才进入经验库,影响后续起点和预测先验。
五个阶段各自管一件事:
| 阶段 | 具体动作 | 防住的坑 |
|---|---|---|
init | 解析仓库 AST,限定 editable_files,冻结数据加载、评估、loss 和计时文件的 SHA-256 | 搜索途中偷换任务或计时口径 |
doctor | 跑参考基线、裁掉 warmup、估计集群噪声、拆分前向/反向/优化器/通信耗时 | 把抖动当收益,或优化一个本就不占时间的阶段 |
run | 联合搜索配置与补丁,保存全部执行回执和成本,对最佳候选重新背靠背复测 | 单次跑分、幸存者偏差、局部最优 |
report | 汇总不变量判定、候选源码路径、失败试验和 GPU/API 成本 | 只展示赢家,不展示代价 |
apply | 检查工作树冲突,写入通过验证的配置和 diff,可放到新分支 | 把搜索结果未经检查直接落进仓库 |
这套流程支持 Megatron-Core、FSDP2/TorchTitan、DeepSpeed、HF Trainer/TRL 和原生 PyTorch DDP。适配层通过统一执行与回执接口接入各框架,论文称每类栈的 hook 不超过 15 行。这个设计挺务实:模型负责提假设, harness 负责执行、验收和记账,二者不混在一起。
16 项不变量:不许用“少干活”换加速
InfraRSI 把目标写成带约束的优化问题:
\(T_0\) 是原始配置耗时,\(T(a)\) 是候选耗时。取对数后,不同环节的乘性加速可以转成适合建模和叠加的量;真正的门槛在 16 个 \(\mathcal{I}_k\) 必须全部通过。
它们分成五层。L1 看任务是否完整执行、有无 NaN/OOM/NCCL 错误、显存是否越界;L2 对齐每次 update 的 token、序列长度、数据摘要、模型摘要与冻结文件哈希;L3 检查真实 optimizer step 数;L4 检查精度菜单、loss 和梯度范数;L5 对齐脚本内计时与 harness 墙钟时间,并要求优势在独立复测中超过校准后的噪声。
说实话,这一层比“让哪个 LLM 来生成补丁”更关键。论文的离线审计里,1,212 次历史执行有 400 次被拒绝,占比为 33.0%。其中 39 次能通过非数值检查,最终被 L4 的 loss/gradient 验证拦下。如果没有这层,它们很可能就会成为报告里的“提速成果”。
还有个细节我很喜欢:没有候选通过全部门槛时,交付加速比就是 1.00 倍,保留原始配置。失败和审计排除的候选仍计入 GPU 与 API 成本。听着朴素,但很多自动优化报告恰恰输在不记这些账。
搜索核心:从单一 incumbent 转向全局状态
常见 Agent 调参循环是“拿当前最好配置,让模型改一点,再跑一次”。这种方法在平滑空间里够用,遇到显存悬崖和编译冲突就容易卡死。当前最好解附近可能没有可行邻居,真正有用的组合需要同时跨几个开关。
InfraRSI 的答案是维护全局搜索状态,而不是只盯着现任冠军。
三个起点,而不是一次押注
前三个完整 trial 各有分工:一个从经验库中最相似的硬件与模型环境热启动;一个采用先验模型评分高、且至少有一个高影响开关不同的完整配置;再跑一个经过冲突规则过滤的随机合法配置,用来锚定全局速度与内存方差。
在 Qwen3.5-9B、8 张 H100 的任务中,经验热启动第一次试验就达到 1.55 倍,后续搜索推进到 1.73 倍。这里的价值不是省一个随机种子,而是让搜索一开始就站在几个不同的“盆地”里。
OOM 不是垃圾数据:Tobit 内存账本
耗时侧使用 Cholesky 更新的贝叶斯线性代理模型,特征包括非参考开关、已验证代码补丁和开关组合。内存侧更有意思:作者用右删失 Tobit 模型拟合每张卡的峰值显存。
成功运行提供精确峰值;OOM 没给出真实需求,却能提供下界:
接近卡容量、发生 allocator thrashing 的运行则提供区间删失信息。模型用阻尼 Newton 迭代和 Laplace 协方差拟合后,可以估计某个设置大约多花或省下多少 GiB,并给出候选满足显存约束的概率。
这就把“这个方向会 OOM,别碰”改成了“这个方向还差多少显存,应该配哪个省显存开关”。失败从终止条件变成了组合搜索的路标。
失败归因与 bundle completion
一个候选崩了,InfraRSI 不会把整锅配置都拉黑。OOM 会记录缺口,并要求匹配足够大的 memory saver;非内存崩溃、hang 或数值发散则尽量定位最小冲突二元组或三元组,单个设置在别的组合里仍然可用。代码探索失败时,责任归补丁,而不是顺手怪到底层启动配置。
Gemma-4-26B-A4B MoE 是论文最有说服力的案例。单独关闭 activation recomputation 会多要 18 GiB,直接 OOM;默认 Liger fused kernel 与编译路径又有冲突。系统把关闭 recomputation、关闭 Liger 和启用 torch.compile 放进同一组合,再加上缓存 block-sparse mask 的 FlexAttention 补丁,最终达到 2.75 倍。
你想想看,如果每次只从当前最好解改一个开关,这个解几乎天然不可达。论文所谓 compositional search,真正的含金量就在这里。
LLM 的直觉不准,就让它接受实测纠偏
论文测到零样本 LLM 的速度收益预测与硬件实测之间,Spearman 相关系数为 -0.49 到 -0.06。这个数让我皱了一下眉:不是“相关性不够高”,而是部分情况下方向都可能反了。
两个例子很典型。Gemma MoE 上,先验给图编译的预测只有 2.0% 收益,实测却释放 55%;双节点 Qwen MoE 上,先验认为增加 NCCL channel 会略慢,实测反而快了 10.2%。
InfraRSI 因而加入 contrarian probing:高影响开关即使被先验低评或否决,只要不确定性的上沿足够高,就值得实测。观测回来后,再通过经验贝叶斯收缩和先验修订更新耗时与内存模型。它还从 doctor 的阶段拆解引入 Amdahl 上限,避免某个只影响小阶段的开关被吹成全程翻倍。
这套机制不是否定 LLM。模型仍擅长读仓库、找机制、生成补丁;只是它不再有“凭直觉永久封杀一个硬件开关”的权力。
只在大开关上跳出局部最优
系统每次观测后都会划分 Big-Knob 集合。一个开关只要先验、代理后验或实测中的任一单开关对数收益幅度越过 \(\max(0.02,2\sigma_{\mathrm{pair}})\),就进入这个集合;阈值约为 2%,同时随集群噪声变化。
连续两次完整试验没有越过噪声门槛,搜索就进入 escape mode,把与 incumbent 的最小 trust-region 距离从一个高影响开关逐步扩到三个,并配合 warm restart 与 tabu 去重。小补丁则可以等组合后的对数收益超过噪声再一起测。
这设计挺像一个有经验的平台工程师:别在 worker 线程数上反复雕花,先找能改变 roofline、通信结构或显存可行性的杠杆。
跨硬件经验:迁移机制,不机械复制答案
训练优化经验很难直接搬家。论文种子库覆盖 H20、H100、H200,包含 11 个经验包、191 个环境、698 条观测和 543 个效应。不同框架的开关被归一到 71 种 canonical mechanisms,例如 fused AdamW、混合精度和通信融合。
硬件差异不只是收益大小变化,还可能变号。
| 机制 | H20 | H100/H200 | 原因 |
|---|---|---|---|
| Qwen3-8B 使用 FP8 | 提升 58% | H200 提升 30%;TP2 下仅 3% | 计算瓶颈缓解后,cast 与通信成本占比改变 |
| Qwen3-8B 使用 TP2 | 提升 24% | H100 下降 4% | AllReduce 开销超过 GEMM 收益 |
| Transformer Engine FP8 attention | 提升 6% | H200 下降 8% | H200 上 BF16 FlashAttention-3 已很强 |
| MoE all-to-all 与 grouped GEMM | 提升 92% | H200 提升 85% 到 110% | 匹配高带宽 NVLink 时迁移较稳定 |
经验记录被拆成 Environment、Observation、Effect 三类实体,分别保存硬件与拓扑、完整配置与执行结果、配对收益及机制标签。检索时按框架、模型族、序列长度、GPU SKU、节点数、互联和并行布局过滤排序;真正更新后验时,仍以目标环境的实测为准。
这一点必须强调:相似度只决定哪些旧证据值得看,不直接替新硬件下结论。否则经验库很容易变成高级版的配置复制器。
主实验:1.83 倍几何平均加速,MoE 拉开差距
实验覆盖四个 dense 与 MoE 工作负载,对比 knob-only 的 OptiCo、开放代码的 Auto-Research 和 RE-Bench。所有方法使用相同任务契约,保留各自原生搜索规则,并记录失败与审计排除试验的成本。
MFU 按非稀疏 Hopper BF16 峰值 989.5 TFLOP/s 计算:
计时采用 warmup 后第 11 到 30 次 update 的平均步时;\(F_{\mathrm{update}}\) 使用 dense-equivalent active FLOPs,不把重计算、通信和未路由 expert 算进去。
| 工作负载与硬件 | 基线 MFU | OptiCo | Auto-Research | RE-Bench | InfraRSI |
|---|---|---|---|---|---|
| Qwen3.5-9B,8×H100 | 25.3% | 1.24× / 31.5% | 1.53× / 38.6% | 1.62× / 40.9% | 1.73 倍,MFU 达 43.8% 的水平 |
| Gemma-4-26B-A4B MoE,8×H200 | 6.4% | 1.32× / 8.4% | 1.29× / 8.3% | 1.33× / 8.5% | 2.75 倍,MFU 达 17.6% 的水平 |
| Qwen3.8-27B,8×H200 | 29.3% | 1.19× / 35.0% | 1.39× / 40.8% | 1.38× / 40.6% | 1.55 倍,MFU 达 45.4% 的水平 |
| Qwen3.5-35B-A3B MoE,16×H100 | 8.7% | 1.17× / 10.3% | 1.17× / 10.2% | 1.17× / 10.3% | 1.51 倍,MFU 达 13.2% 的水平 |
| 四任务汇总 | 平均 17.4% | 几何均值 1.23× / 平均 21.3% | 1.34× / 24.5% | 1.37× / 25.1% | 几何均值 1.83 倍,平均 MFU 达 30.0% 的水平 |
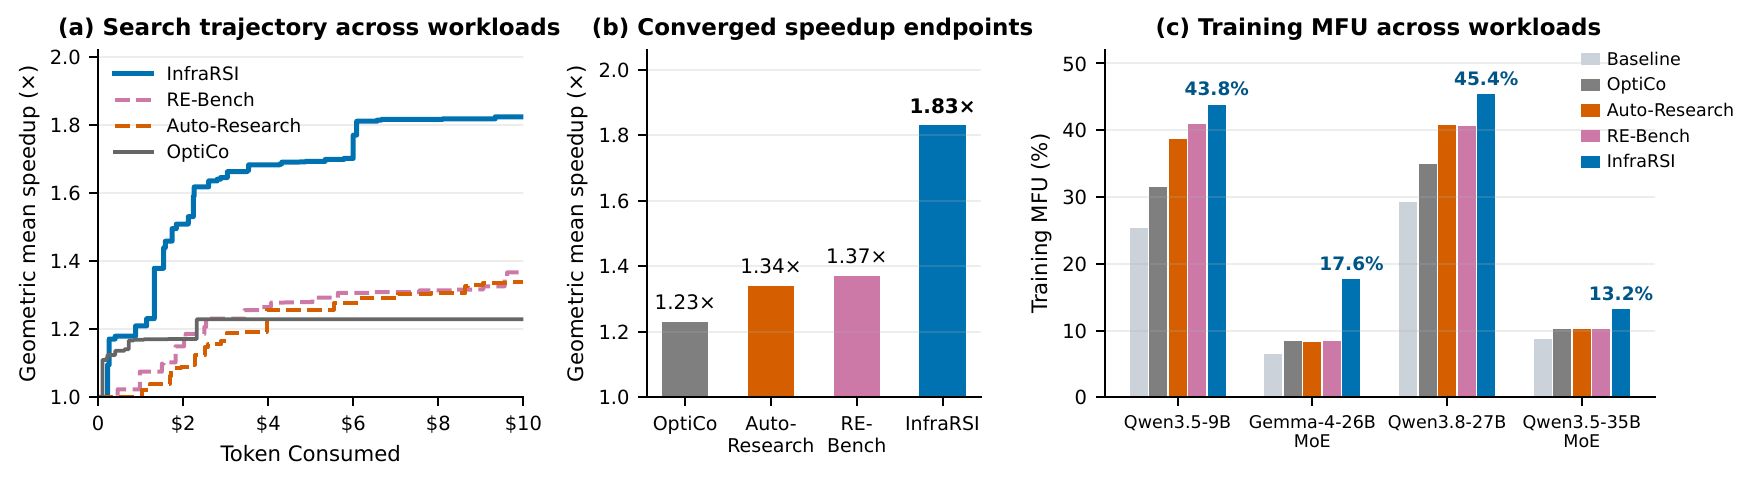
图 2:左图横轴为论文记录的 token consumption,纵轴为四任务几何平均加速比;中图给出 1.23、1.34、1.37 与 1.83 倍的最终端点;右图显示 InfraRSI 在四个任务上的 MFU 分别为 43.8%、17.6%、45.4% 和 13.2%。
Gemma MoE 的 2.75 倍很抓眼,但别只盯着这个最大值。更扎实的信号是 InfraRSI 在四个任务上都超过对应基线,dense 模型 MFU 超过 43%,两个 MoE 也分别从 6.4% 和 8.7% 提到 17.6% 和 13.2%。
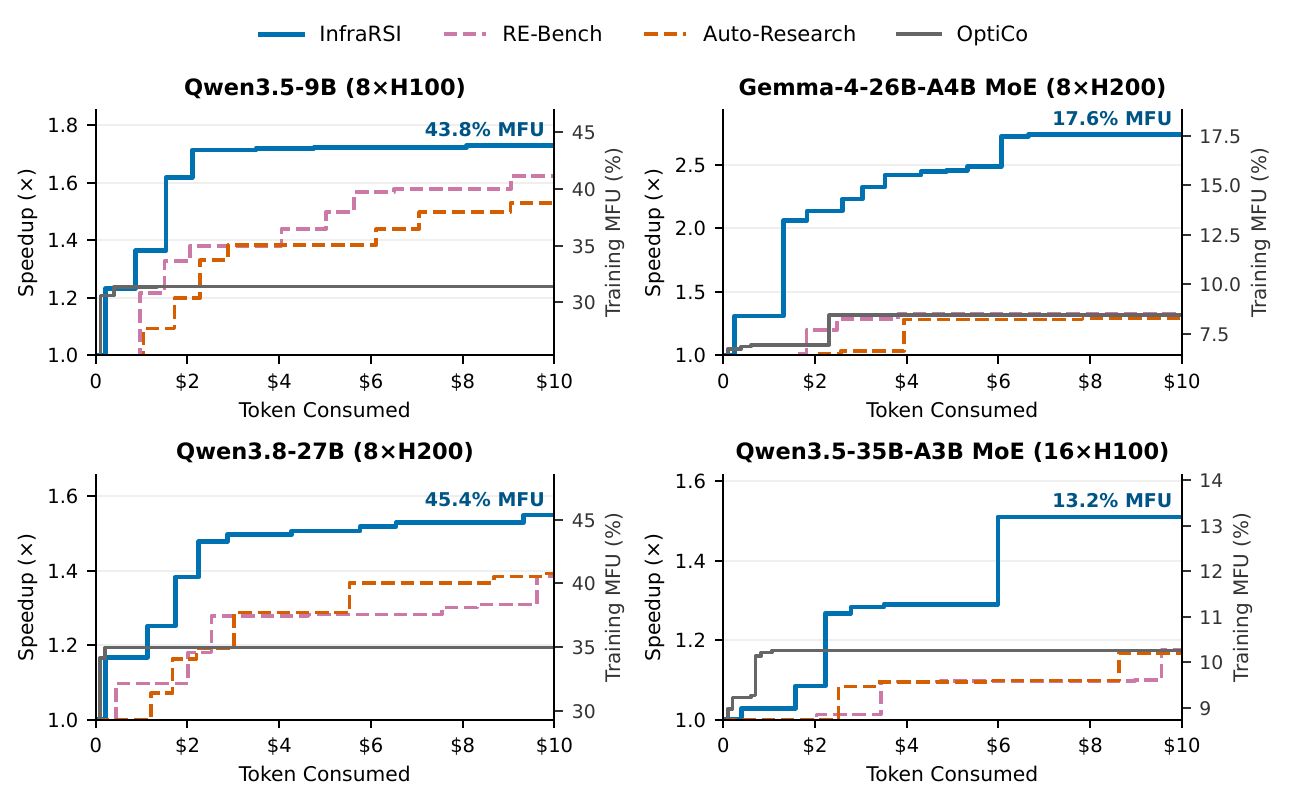
图 3:四个子图分别展示 Qwen3.5-9B、Gemma-4-26B-A4B MoE、Qwen3.8-27B 和 Qwen3.5-35B-A3B MoE。InfraRSI 的蓝线在 Gemma 上经过多轮台阶式提升后达到 2.75 倍,在双节点 Qwen MoE 后段也出现明显跃升。
不过,这些曲线横轴是 token consumption,不是统一的 GPU-hour。它能比较模型提案预算下的搜索过程,却不能单独证明每种方法的总经济成本完全相同。论文把 GPU/API 失败成本纳入账本是对的;做生产采购判断时,我会再要求一张“净节省 GPU-hour 对搜索 GPU-hour”的回收周期表。
跨硬件迁移:过滤经验,比“全都塞进去”更重要
迁移实验固定在 Qwen3.5-9B、8×H100 上,比较冷启动、全部合格经验包和只使用其他 GPU SKU 证据的 Cross-SKU transfer。收敛门槛定义为达到峰值对数加速的 90%。
| 经验条件 | 首次试验 | 最终加速 | 到达 90% 峰值 | 搜索成本 |
|---|---|---|---|---|
| 冷启动 | 第 2 次达到 1.22× | 1.70× | 超过 15 次仍未达到 | 未给出 |
| 全部合格经验包 | 第 1 次达到 1.24× | 1.70× | 超过 17 次仍未达到 | 未给出 |
| Cross-SKU transfer | 第 1 次达到 1.23× | 1.82 倍 | 第 9 次 | 2.97 GPU-hour |
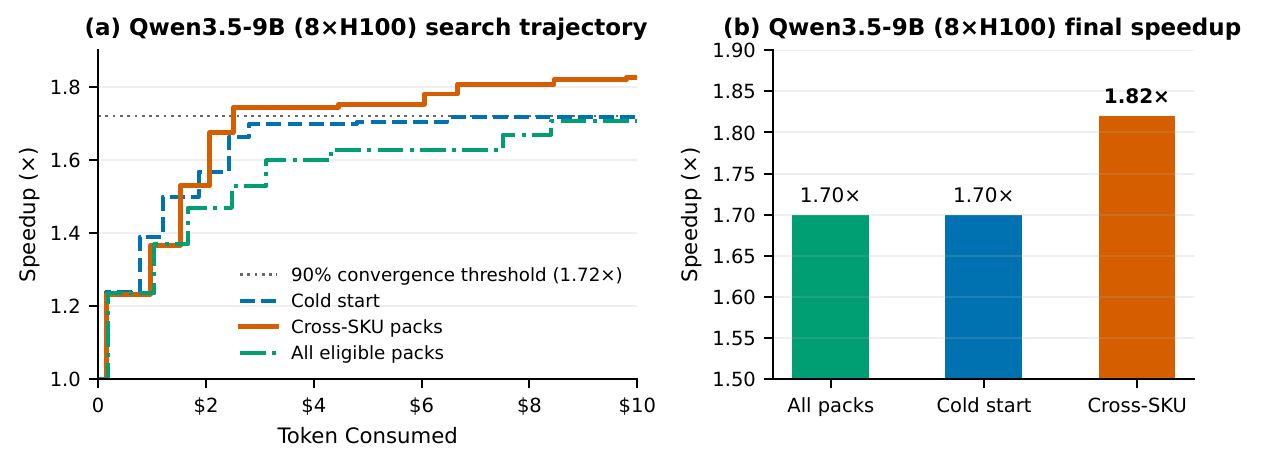
图 4:Cross-SKU 橙色曲线在第 9 次试验附近越过 1.72 倍的收敛参考线,最终达到 1.82 倍;冷启动和全部经验包均停在 1.70 倍。右图给出三组最终端点。
这个结果有点反直觉:全部合格经验包没有比冷启动更好,反而是更严格排除同任务、同 SKU 历史的 Cross-SKU 条件胜出。它至少说明“记忆越多越强”并不成立,检索口径和证据来源会改变搜索轨迹。
但我也得泼点冷水:这里只有一个目标任务,而且不同条件的搜索路径具有随机性。单次实验不足以证明跨 SKU 经验普遍优于其他检索策略。它展示了可行性,还不是迁移规律的终局答案。
验证器与容差消融:严格一点,损失并不大
验证器测试包含 28 个单扰动回执和 12 个正常变体,40 个判定全部符合预期;未签名、签名后篡改或 schema 不匹配的 HMAC-SHA256 回执也都会被拒绝。
在线消融考察 0.10%、3.00% 和 50.00% 三种窗口平均 loss 相对容差,以及固定 2% 噪声门槛。
| 设置 | 有效/完成 | 最终加速 | 到达 90% 峰值 | 搜索成本 |
|---|---|---|---|---|
| 严格容差 0.10% | 13/16 | 1.70× | 第 11 次 | 6.48 GPU-hour |
| 默认容差 3.00% | 14/17 | 1.74× | 第 10 次 | 7.05 GPU-hour |
| 宽松容差 50.00% | 13/17 | 1.75× | 第 10 次 | 6.90 GPU-hour |
| 固定 2% 噪声,容差 3.00% | 11/15 | 1.72× | 第 11 次 | 6.02 GPU-hour |
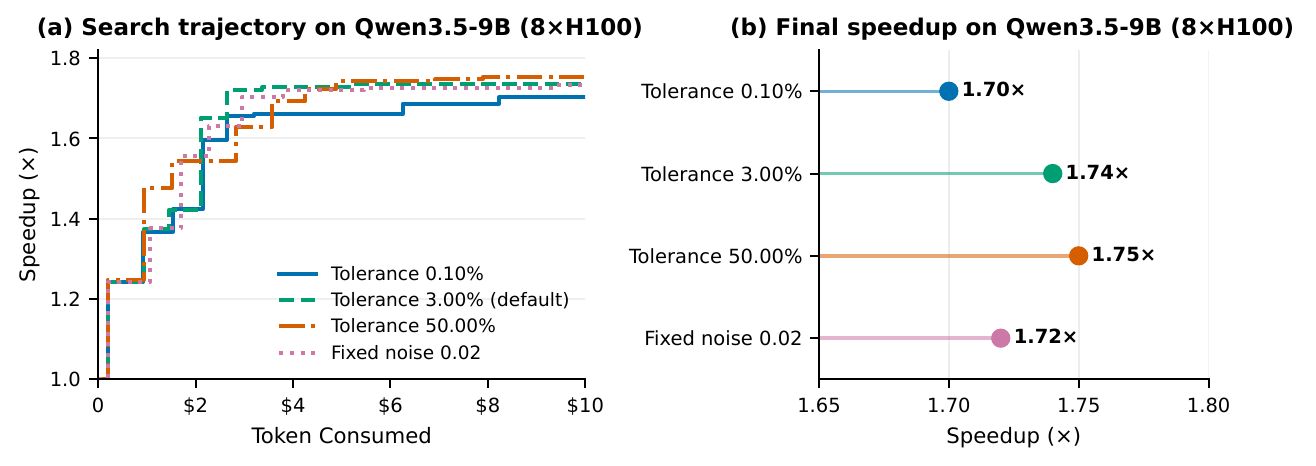
图 5:四种设置都在 10 到 11 次试验内越过共同的 90% 峰值门槛,最终加速集中在 1.70 到 1.75 倍;默认 3% 容差为 1.74 倍,固定 2% 噪声设置为 1.72 倍。
表面上,50% 容差只比严格设置多 0.05 倍,好像可以大胆放宽。我反而觉得这里要非常谨慎:短窗口 loss 没越界,不等于完整预训练的最终质量没变化。 50% 的窗口平均偏差在真实训练里已经是很大的自由度,论文只证明这组短程搜索指标稳定,没有证明长程训练等价。生产环境没理由拿这个消融当放宽数值约束的许可证。
放到已有工作里看,InfraRSI 到底新在哪
FunSearch 和 AlphaEvolve 的核心是程序生成与自动评估的进化回路;OptiCo 根据 ACL 2026 论文,使用多智能体协作和全局消息池优化分布式训练配置,但更偏启动参数;RE-Bench 与 Auto-Research 代表更自由的代码研究 Agent。InfraRSI 没有发明“LLM 生成补丁”,也没有发明贝叶斯优化或 Tobit 回归。
它把这些零件装到了一个此前容易被忽略的位置:多 GPU 训练任务的可验证组合搜索。
| 方法 | 主要搜索对象 | 全局内存建模 | 数值/任务契约 | 跨硬件经验 |
|---|---|---|---|---|
| FunSearch / AlphaEvolve | 程序与启发式函数 | 非核心 | 依赖任务评估器 | 非核心 |
| OptiCo | 分布式训练启动配置 | 无论文所述 Tobit 账本 | 非同一套 16 项契约 | 非核心 |
| Auto-Research / RE-Bench | 自由代码与研究动作 | 不以全局删失模型为核心 | 依赖具体任务 scaffold | 不以结构化硬件经验为核心 |
| InfraRSI | 启动配置与源码补丁组合 | OOM/近容量样本进入 Tobit 模型 | 16 项不变量、源码路径审计与复测 | 机制归一、环境过滤与验证后写回 |
所以我的定位是:这是很强的系统工程整合,也包含针对内存悬崖的扎实建模,不是通用 RSI 理论的跃迁。它优化的是训练基础设施,并更新搜索先验与经验库;它没有让基础模型自主训练出更强后继,也没有让 harness 的核心算法自行重写自己。
我愿意借鉴什么,又会保留什么疑问
如果我在维护训练平台,会优先借三件事:把任务等价检查写成机器可执行契约;把 OOM 和编译冲突结构化记录,而非只保存文本日志;把经验按硬件、拓扑和机制归一,不让 Agent 无差别 replay 旧配置。
落地时,我会把 apply 留在受控分支和人工 review 之后,先在 staging 集群跑可信基线。数据摘要、模型摘要、optimizer step、墙钟计时和 loss 窗口必须能稳定产出;缺这些可观测性,再聪明的搜索控制器也只能围着不完整的回旋转。
疑问也很明确。四个工作负载还不足以覆盖训练框架、互联和模型形状的长尾;短程数值容差不能替代完整训练质量;迁移实验目前只围绕一个目标任务;基线虽共享契约,但保留原生搜索规则,token 预算与 GPU 成本也不完全等价。还有,2.75 倍来自基线 MFU 仅 6.4% 的 MoE 任务,既说明优化能力强,也说明这个任务的可优化空间本来就大。评价整套系统时,1.83 倍几何均值比单个峰值更有参考价值。
说实话,这篇论文最打动我的地方恰恰是它不够“科幻”。没有自主智能爆炸的宏大叙事,只有一堆麻烦但必要的工程纪律:别改任务、别信单次计时、别丢掉失败、别把旧硬件经验当真理。
如果这些纪律能成为训练 Agent 的默认配置,RSI 才会从一个漂亮名词,变成每天都能省 GPU-hour 的工具。
参考链接
- InfraRSI 论文与源码:https://arxiv.org/abs/2611.11558 ,https://github.com/TokenRhythm/InfraRSI
- OptiCo,ACL 2026:https://aclanthology.org/2026.acl-long.1283
- FunSearch:https://www.nature.com/articles/s41586-023-06924-6
- AlphaEvolve:https://deepmind.google/discover/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我