Flide:把决策请求摊平执行,还能保住每个分支的原始概率
你有没有遇到过这种推理负载:一段几千 token 的 Agent 轨迹不动,接下来却要连续问它二十个问题——当前步骤是否成功、该调用哪个工具、是否需要重试、风险有没有越界?
这些问题共享同一段历史,答案却必须彼此独立。把每个问题单独发给模型,长历史要被反复处理;把所有问题拼进一条序列,倒是省了事,可前一个问题的分隔符、甚至问题本身,都可能改变后一个问题的概率。
速度和安全阀,似乎只能选一个。Flide 这篇论文让我觉得有意思的地方,就是它拒绝接受这个二选一。
🎯 核心摘要
Flide 是面向决策模型的专用推理引擎。它把“共享状态加多个问题”的请求看成一棵树,却在 GPU 上摊成一条 token 流执行:共享主干只算一次,每个问题通过 ForkAttention 继承主干状态,又看不到兄弟分支。在单张 H200 上,它相对 vLLM 和 SGLang 取得最高 9.5 倍的延迟改善和 8.5 倍的吞吐提升,同时比会插入分隔符的 multi-item scoring 更贴近 float32 参考输出。这不是新模型,也不是近似压缩,而是一套很扎实的推理系统重构;真正值钱的是,它把混合架构里的循环状态也精确分叉了。
📖 论文信息
- 标题:Flide: Accelerating Decision Inference with Exact State Forking
- 作者:Bobo Li、Jiajia Song、Hao Fei、Wynne Hsu、Mong Li Lee
- 机构:National University of Singapore;University of Oxford
- 版本:v1,2026 年 10 月 30 日
- 论文:https://arxiv.org/abs/2610.42148
- 项目主页:https://flide.org
- 源代码:https://github.com/OmniJev/flide
- arXiv ID:2610.42148
Flide 展开为 Flat-Graph Inference for Decision Models。这里的 decision model 不是让模型写一大段分析,再从中抽取答案,而是直接输出若干离散选项的概率。路由、结果评判、Agent 下一步选择,都很适合这种只读一个答案 token 的工作方式。
这也解释了作者为什么如此在意概率:如果下游拿 0.5 当阈值,概率漂移就不只是数值美学问题,而可能直接改变系统行为。
🧠 生成式引擎为什么会卡在决策请求上
假设请求是 \(r=(s,q_1,\ldots,q_n)\),其中 \(s\) 是长度为 \(P\) 的共享状态,\(q_i\) 是第 \(i\) 个问题。每个问题都应该等价于独立输入 \(s\oplus q_i\),与其他问题无关。
传统做法有三条路:
| 方案 | 物理执行方式 | 省下了什么 | 付出的代价 |
|---|---|---|---|
| 独立序列 | 每个问题各自处理 \(s\oplus q_i\) | 语义最直观 | 共享状态被重复计算或重复恢复 |
| Prefix Cache | 先缓存主干,再从缓存启动各问题 | 全注意力层可复用部分 KV | 每个问题仍是独立序列;混合模型的循环状态常受块边界限制 |
| Multi-item scoring | 主干后拼接所有问题,并插入分隔符 | 主干只处理一次,分支可一起跑 | 输入被改动,概率可能偏移;还关闭 CUDA Graph |
| Flide | 一条扁平 token 流,树关系存在 GPU 元数据里 | 主干与分支同轮执行,保留图重放 | 需要专用 kernel、状态索引和图容量管理 |
独立序列的计算量约为:
右边是 Flide 的目标:主干只算一次,每个问题也只算一次。
你可能会说,前缀缓存不早就解决这件事了吗?vLLM 的 PagedAttention、SGLang 的 RadixAttention 确实已经很成熟,前缀复用并不是 Flide 发明的。问题在于,缓存复用不等于同轮精确分叉。
全注意力模型里,缓存至少还能留下 KV。到了 Qwen3.5 这类混合架构,很多层换成 Gated DeltaNet,历史被压进一个矩阵循环状态。现有引擎往往只能在较粗的块边界恢复它,块尾那部分仍要重算。更麻烦的是,一旦问题分支在同一条序列里先后更新这个状态,后一个分支就会继承前一个分支的信息。
所以真正的难点不是“怎样少算一点”,而是:怎样一起算,还让每个分支像单独算过一样。
🏗️ Flide 的总图:树留在逻辑里,流交给 GPU
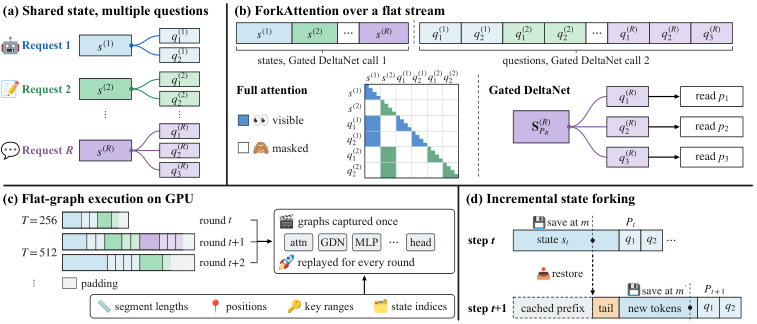
图1:Flide 总览。左上把每个请求表示为共享状态 \(s\) 与多个问题分支;右上展示扁平流上的注意力可见区域,以及 Gated DeltaNet 先处理所有主干、再从各自主干状态处理问题的两次调用;左下用 segment lengths、positions、key ranges、state indices 等 GPU 元数据驱动预录制执行图;右下则把 Agent 历史拆成可缓存前缀、可变尾部和新增 token,并在每一步保存下一次可恢复的 checkpoint。
这张图的信息量很大,我建议抓住一条主线:物理布局可以随便压缩,逻辑依赖不能被压缩掉。
Flide 把一整轮请求无 padding 地排成连续流,先放各请求的主干,再放问题分支。每个 token 带着三个索引:属于哪个请求、属于主干还是哪条分支、在原序列里的位置是多少。问题的位置编码从主干末端继续,因此 RoPE 也和独立输入一致。
pointwise 操作——线性投影、归一化、MLP——本来就不关心其他 token,直接跑即可。需要动刀的是两类会混合 token 的层:全注意力和 Gated DeltaNet。
🔧 ForkAttention:两种状态,两套隔离办法
全注意力:能看见主干和自己,看不见兄弟
对全注意力层,Flide 给 query token 设定很严格的可见范围:
- key 必须属于同一个请求;
- key 只能在共享主干,或当前问题分支里;
- key 的位置不能晚于 query,保留因果性。
完全可见的 key block 不再额外施加 mask,只有部分可见的 block 才做掩码。滑动窗口注意力也沿用相同位置关系,所以分支看到的 key 集合与独立序列一致。
这个思路和推测解码里的 tree attention 有亲缘关系,但使用场景不同。推测解码是在一棵候选 token 树上做验证,Flide 处理的是多个独立决策问题,而且还要解决循环层和图执行。
Gated DeltaNet:不能 mask,就从正确状态重新出发
Gated DeltaNet 的难点更硬。它把历史折进固定大小的矩阵状态 \(\mathbf{S}_t\):
\(\alpha_t\) 控制旧状态保留多少,\(\eta_t\) 控制新信息写入强度。到了第 \(t\) 步,\(\mathbf{S}_t\) 已经混合了此前所有 token,根本没有一张注意力矩阵可以拿来遮住兄弟分支。
Flide 的做法是把每层 Gated DeltaNet 拆成两次调用:
- 先处理所有请求的主干,得到各自主干末尾的 \(\mathbf{S}_P\) 和短因果卷积窗口;
- 再一起处理所有问题,每个问题通过 state index 指向自己请求的 \(\mathbf{S}_P\),无需复制整份状态。
问题开头的卷积也通过索引读取主干末尾的前驱 token。这样,分支既接得上主干,又碰不到其他问题。
这是我觉得全篇最关键的一步。只做注意力 mask,在混合模型上根本走不通;把 recurrent state 和 convolution window 一起接对,才算真正覆盖了模型结构。
“精确”到底精确到哪一层
论文的 Proposition 3.1 说得很明确:对因果模型,在精确算术下,任意问题 token 的 hidden state 都等于它独立处理 \(s\oplus q_i\) 时的结果,不受同轮其他请求影响。证明按层归纳,依据就是输入 token、位置、可见 KV、循环初始状态全部一致。
但这里别把三个概念混成一句“bitwise 一样”:
| 层次 | Flide 的保证 |
|---|---|
| 数学语义 | 精确算术下,与单问题独立 forward 相同 |
| 默认浮点执行 | 仍可能有舍入级差异,实验显示比基线更贴近 float32 参考 |
| 可选 batch-invariant 模式 | 在同一硬件和软件栈上,不同负载下答案 bit-identical |
这个区分很重要。Flide 没有让 bfloat16 变成 float32,它保证的是分支隔离;更强的跨负载位级确定性,需要专门固定归约顺序。
⚙️ Flat-Graph:动态请求树,也能复用静态 CUDA Graph
短决策请求可能只有几毫秒。若每轮顺序启动几千个 kernel,CPU 发射开销会直接把理论收益吃掉。CUDA Graph 能把 kernel 启动录下来重放,可它喜欢固定形状,决策请求的树干长度、分支数量却一直在变。
Flide 的拆解方式挺漂亮:图固定,图里的数据不固定。
服务启动时,它按扁平流容量 \(T\) 预录一小组图,同时预留请求数、问题段数、Gated DeltaNet chunk 数和 readout 行数的容量。每轮只更新 GPU buffer 里的段长、位置、key range、状态索引等元数据,kernel 的 launch configuration 不变。
实际 token 在请求之间紧密排列,只有流末尾补齐到图容量。超出最大图的一轮按请求边界拆开;单个巨型请求则退回不带 CUDA Graph 的扁平流执行。
还有两个设计很对工程胃口:
- Selective Readout:输出头只读每个问题的末尾 token。末层仍为所有 token 算必要的 key/value,但 MLP 等其余计算只跑 readout 行,少做一大批最终不会被读取的投影。
- Incremental State Forking:Agent 每一步只新增一小段历史时,从 checkpoint 恢复。checkpoint 保存各 Gated DeltaNet 层的 float32 循环状态、卷积窗口,以及全注意力层的 KV;位置故意放在状态末尾稍前,把容易变化的对话尾部留在外面重算。
至于 batch-invariant 模式,它固定矩阵乘法的归约顺序,并让每个问题拥有自己的 attention tile 和 Gated DeltaNet chunk,使归约在 fork 处开始。这与 Thinking Machines Lab 之前讨论的 batch invariance 一脉相承:负载变化不该成为输入的隐藏变量。
🧪 实验怎么测:问题数才是核心变量
实验使用一张 NVIDIA H200,模型均为 bfloat16。对比对象包括 vLLM、SGLang、SGLang multi-item scoring,以及专用决策模型上的 vllm-jev 和 RadixFlow。除 multi-item scoring 外,其余相关配置开启 CUDA Graph。每个并发等级前清空 prefix cache,每行负载重复发送多份,并给每份状态加独立标签,避免跨副本偷用缓存。
六组负载把“共享程度”拉得很开:
| 负载 | 请求数 | 问题数 | 每请求平均问题数 | 平均主干 token | 独立序列总 token | Flide 流总 token |
|---|---|---|---|---|---|---|
| RACE,单问题 | 256 | 256 | 1.0 | 250 | 325 | 325 |
| QuALITY,单问题 | 256 | 256 | 1.0 | 3,355 | 3,443 | 3,443 |
| Decision Index | 679 | 3,635 | 5.4 | 323 | 3,387 | 1,349 |
| RACE,全部问题 | 256 | 1,019 | 4.0 | 255 | 1,283 | 546 |
| QuALITY,全部问题 | 115 | 2,086 | 18.1 | 5,835 | 107,085 | 7,454 |
| MultiRC | 83 | 3,948 | 47.6 | 327 | 17,808 | 2,663 |
QuALITY 那行很夸张:独立序列要处理约 10.7 万 token,扁平流只需约 7454 token。这个负载当然最有利于 Flide,但它也准确命中了论文想服务的场景——长文章读一次,很多问题一起问。
📊 主结果:分支越多,优势越大
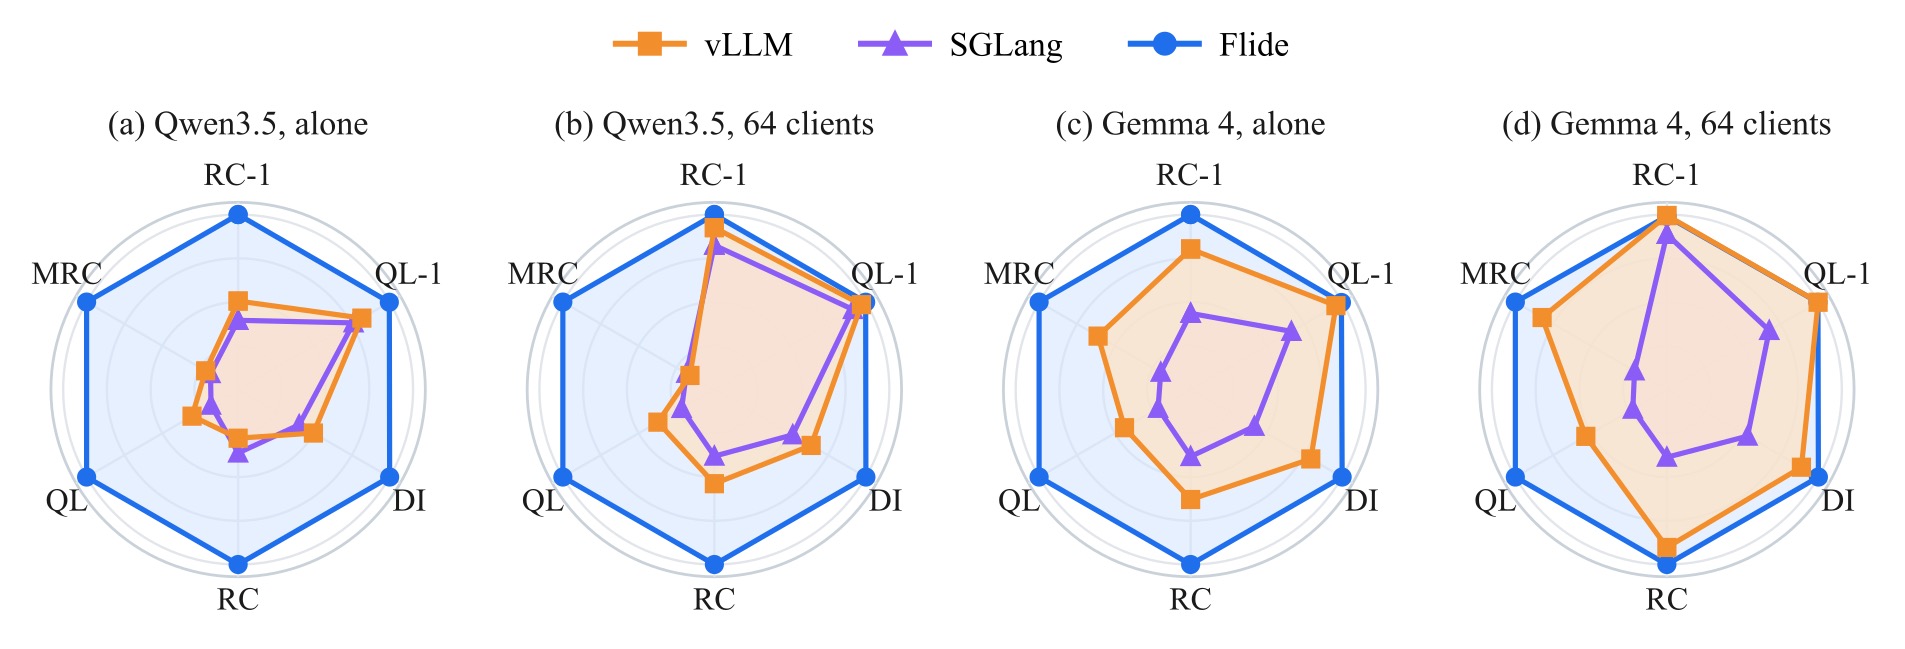
图2:四种设置下的相对速度,数值按四种模型规模取几何平均,越靠外越快。RC-1、QL-1 是单问题 RACE 和截断 QuALITY;RC、QL、DI、MRC 分别对应多问题 RACE、完整 QuALITY、Decision Index 和 MultiRC。Flide 在多问题轴上稳定领先;单问题、高并发时,它与最强基线接近。
下面摘出 Qwen3.5 四种规模的平均结果。Lat. 是单客户端请求中位延迟,C64 是 64 个闭环客户端下的 requests/s。
| 负载 | 引擎 | Lat.,ms,越低越好 | C64,req/s,越高越好 |
|---|---|---|---|
| RACE,单问题 | vLLM / SGLang / Flide | 29.4 / 36.8 / 18.0 | 219 / 184 / 257 |
| Decision Index | vLLM / SGLang / Flide | 31.4 / 38.4 / 18.6 | 42.7 / 36.8 / 81.1 |
| QuALITY,全部问题 | vLLM / SGLang / Flide | 639 / 1.4k / 298 | 3.2 / 2.1 / 13.6 |
| MultiRC | vLLM / SGLang / Flide | 350 / 491 / 105 | 5.8 / 6.1 / 42.4 |
几个判断比“最高 9.5 倍”本身更有用。
单问题场景里,Flide 的独请求延迟依然更低,最小模型上最高可降到基线的约 1/3.2,主要收益来自一轮一次 flat-graph replay,前端和调度更轻。但到了高并发、模型计算占主导时,它大体只是追平最强基线。没有共享分支可省,专用引擎也不能凭空变出 FLOPs。
多问题场景才是主战场。论文报告最高 9.5 倍延迟改善、最高 8.5 倍吞吐提升;QuALITY 和 MultiRC 的问题密度最高,收益也最猛。更专门的缩放实验把同一篇约 2000 token 的文章扩展到 64 个问题,Flide 比 vLLM 快 12.7 倍。这个数不该当成所有负载的通用加速比,它只是把方法最擅长的轴推到了极致。
Gemma 4 的结果也值得看。它是全注意力模型,vLLM 已能借 prefix cache 让共享状态只算一次,Flide 仍把多问题请求延迟降低 1.1 到 2.9 倍。所以收益不只来自少算主干,也来自同轮执行、较少的调度与 kernel 启动。
🔬 概率保真:共享状态不该偷偷改答案
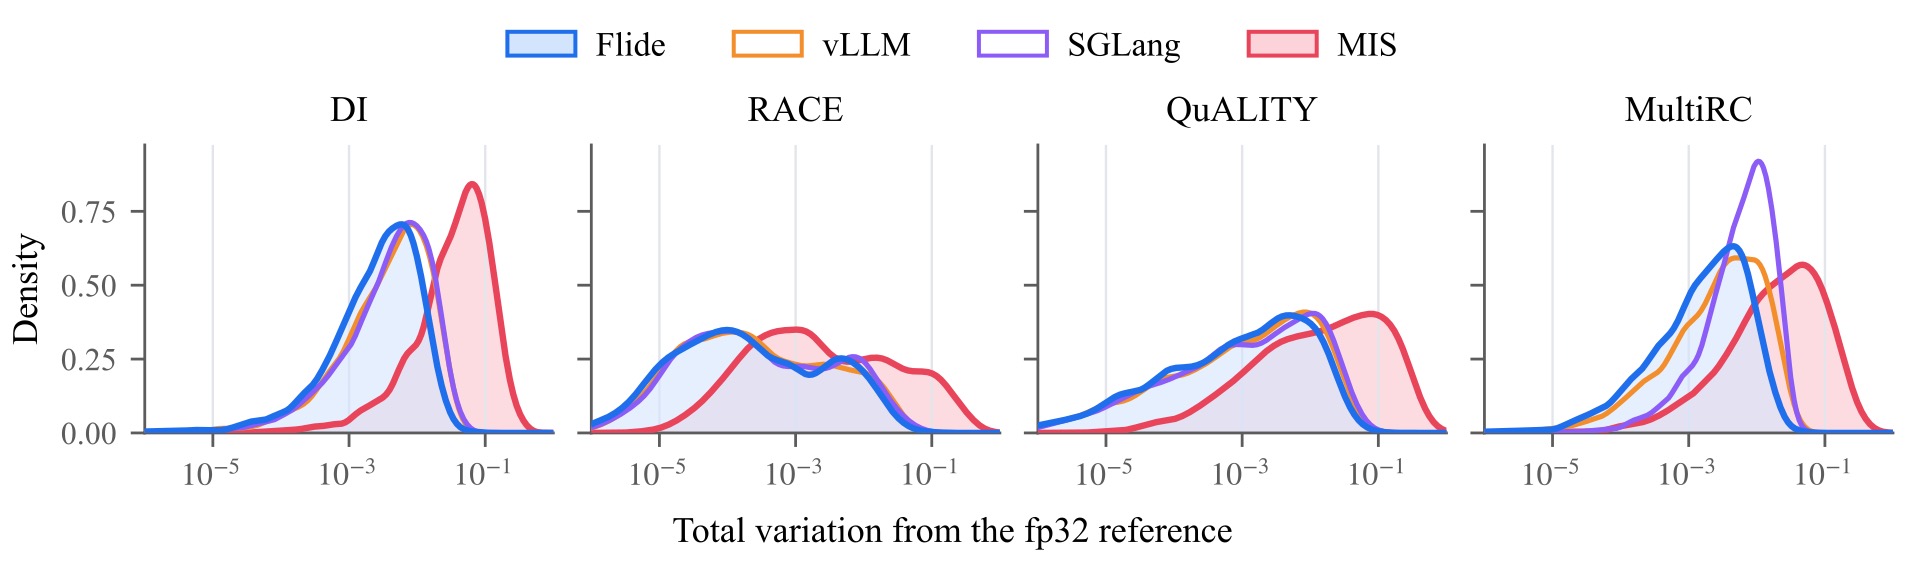
图3:Qwen3.5-4B 上,每个问题输出分布与 float32 参考的 total variation,横轴为对数刻度,纵轴为密度。MIS 的红色分布整体向右移动,说明偏差更大;Flide、vLLM、SGLang 的曲线大体重叠,Flide 在 DI 等负载上更靠左。
跨四种 Qwen3.5 规模取平均,附录 Table 11 给出:
| 负载 | vLLM TV | SGLang TV | MIS TV | Flide TV |
|---|---|---|---|---|
| Decision Index | 0.64 | 0.66 | 4.84 | 0.44 |
| RACE,全部问题 | 0.44 | 0.45 | 3.64 | 0.36 |
| QuALITY,全部问题 | 0.69 | 0.73 | 6.69 | 0.55 |
| MultiRC | 0.50 | 0.65 | 3.77 | 0.30 |
TV 越低,越接近 float32 参考。MIS 的问题不是“浮点噪声稍微大一点”,而是分布整体搬走了。作者还统计 0.5 阈值下的决策翻转:MIS 最高达到 28.9 个点,Flide 最高为 2.3 个点。
看到这里我其实有点皱眉:一个为了提速而加入的分隔符,居然能让近三成阈值决策翻转。对于只看 top-1 是否大致正确的应用,这或许还能忍;对于拿概率做路由、安全拦截和自动重试的系统,就完全不是小事了。
主文 Table 4 还显示,Flide 在六项负载上的平均 top-answer agreement 都最接近 float32;准确率与 vLLM 每个单元格的差距不超过 1.2 个点。默认模式下,单客户端到 64 客户端的 top answer 稳定性也达到表中的 100%。
不过,准确率相近不代表概率可以随意漂移。这个实验真正支持的是后者:共享计算不必以篡改输入为代价。
🧩 消融:每项优化分别在省什么
Qwen3.5-4B 的引擎内部计时如下,不包含 HTTP server:
| 变体 | DI Lat.,ms | DI Req/s | QuALITY Lat.,ms | QuALITY Req/s | RACE Req/s |
|---|---|---|---|---|---|
| 完整 Flide | 8.8 | 48.9 | 135.6 | 8.6 | 210.3 |
| 去掉 state forks | 8.7 | 20.7 | 1868.5 | 0.6 | 211.1 |
| 去掉 flat graphs | 8.5 | 43.5 | 135.7 | 8.5 | 134.9 |
| 去掉 CUDA graphs | 76.1 | 48.9 | 137.2 | 8.5 | 191.6 |
| 去掉 selective readout | 8.9 | 47.8 | 140.1 | 8.3 | 205.2 |
去掉 fork 后,QuALITY 延迟从 135.6 ms 飙到 1868.5 ms,这是最直观的主干重复计算代价。RACE 单问题几乎不受影响,也再次说明 fork 的价值取决于共享程度。
去掉 CUDA Graph,DI 独请求延迟从 8.8 ms 变成 76.1 ms,但 DI 吞吐不变。短请求被 kernel launch 支配,并发计算则不是同一个瓶颈。去掉 flat graph 后,RACE 吞吐从 210.3 降到 134.9 req/s,因为每种请求组合都要单独 replay。这样的消融挺干净,四项组件各自对应一种系统开销,不是只拿一个总开关讲故事。
🤖 Agent 历史增长:checkpoint 把边际成本压下来
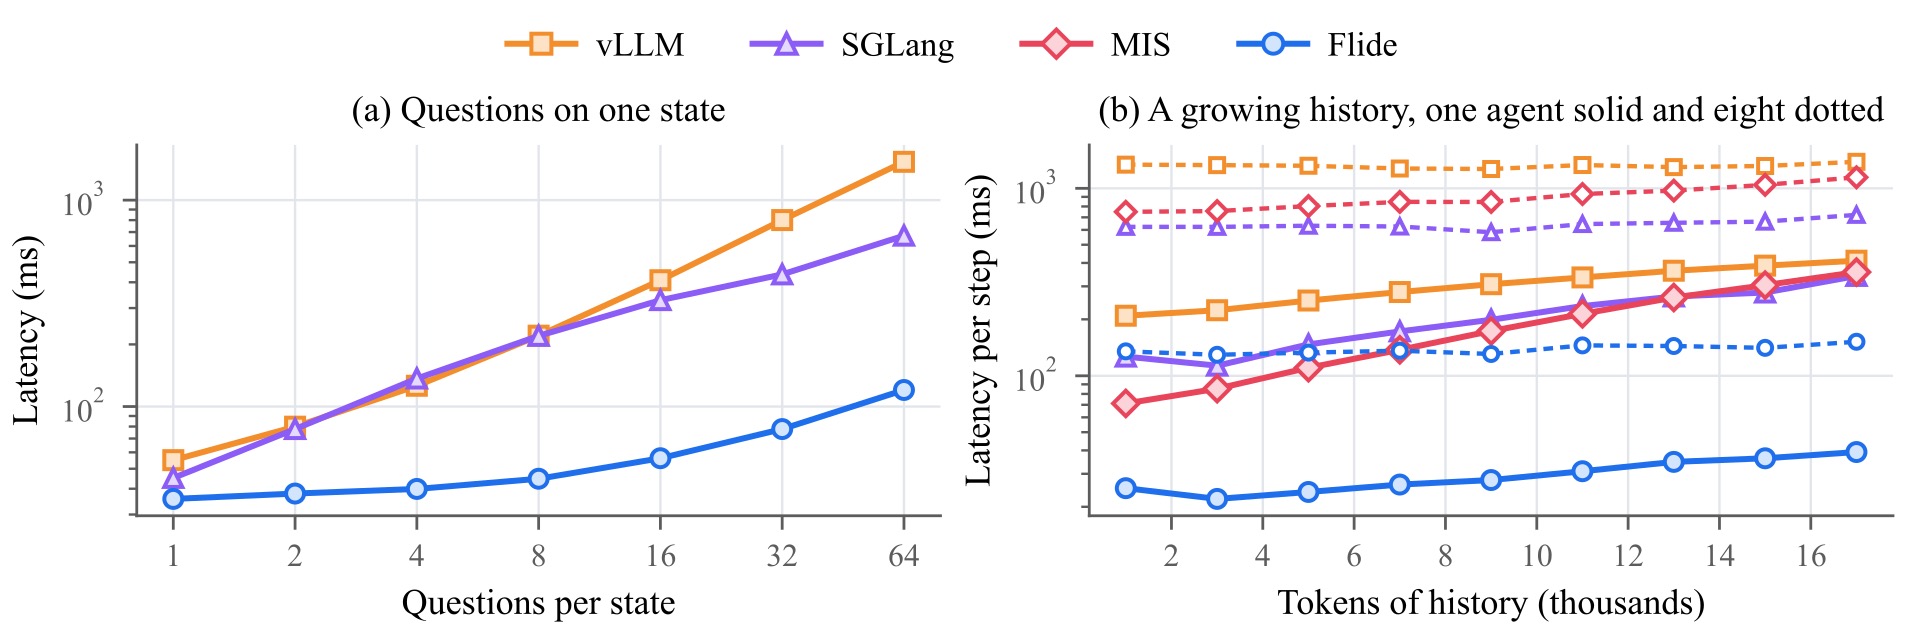
图4:左图中,同一状态从 1 个问题扩展到 64 个,vLLM/SGLang 的延迟快速上升,Flide 曲线平缓得多;右图展示 Agent 历史从约 1000 增长到 17000 token,实线为单 Agent、虚线为八 Agent,Flide 的每步延迟始终较低。两图纵轴均为对数刻度。
作者回放公开的 SWE-agent 轨迹,构造一千多个逐步增长的状态,每个回合针对完整历史问多个问题。以 Qwen3.5-4B 为例:
| 引擎 | 历史小于 4k,ms | 历史大于 12k,ms | 每千 token 增长,ms | 单 Agent steps/s | 32 Agent steps/s |
|---|---|---|---|---|---|
| vLLM | 218.7 | 384.6 | 13.8 | 3.8 | 6.0 |
| SGLang | 116.2 | 279.8 | 13.2 | 6.0 | 12.4 |
| MIS | 81.8 | 294.9 | 17.2 | 7.5 | 8.9 |
| Flide | 22.4 | 36.1 | 0.9 | 38.5 | 57.9 |
Flide 每增加一千 token 历史,延迟只多约 0.9 ms;最终每秒完成步数是最强基线的 4.4 到 7.2 倍。这部分很贴近真实 Agent:历史一直在长,但每轮新增内容并不长,没必要把整段人生重新读一遍。
专用决策模型上,Flide 也没有只赢通用模型。Open-Jev-2B 和 9B 的平均结果里,RACE 独请求延迟为 13.0 ms,vllm-jev 和 RadixFlow 分别为 49.8、40.9 ms;QuALITY 上则是 72.8、101.8、113.3 ms。长输入下优势缩到最高约 1.7 倍,因为 forward 计算开始占主导,这个趋势反而让结果更可信。
💡 我的判断:亮点很硬,但别把它当通用生成引擎
这篇论文最值钱的地方,是把三件通常分开优化的事放进了一个执行模型里:分支语义、循环状态、CUDA Graph。很多系统论文能做到其中两项,第三项一上来就不得不牺牲语义或性能。Flide 用 GPU-resident metadata 把动态树从静态图里剥离出来,这个设计我会记住。
它也没有把 prefix cache 包装成新发明。真正的增量是同轮共享主干、隔离所有分支,并覆盖 recurrent state。如果你做混合模型 serving,这部分比“最高 9.5 倍”更值得细读。
但限制同样清楚。
实验全部在单张 H200 上,暂时没有多卡、跨机、量化模型和不同 GPU 架构的结果。基线里 vLLM 使用两个 release candidate 版本并取较快值,SGLang 与 vllm-jev 又使用各自模板;作者已经尽量把设置写清楚,但这些数字仍依赖具体软件栈,不能直接外推成生产环境 SLA。
它优化的是单 token、分类式决策,不是长文本生成。对每段状态只有一个问题、且 GPU 已被大 batch 喂饱的服务,收益可能很小。数学上的独立分支等价,也不保证模型答案更聪明;float32 只是数值参照,不是事实正确性的裁判。
还有个我自己会继续追问的点:checkpoint 放在“末尾稍前”很符合对话历史,但面对任意 Agent 状态编辑器、工具结果回写或历史重写,怎样自动选稳定 checkpoint,论文没有给出通用策略。说实话,这块我也还没有看到特别省心的答案。
我这次核对了论文正文、附录数据和代码入口,没有独立在 H200 上复现。因而我更愿意把 9.5 倍读成适配负载上的上界,而不是一句对所有请求都成立的宣传数字。
📝 工程上怎么借鉴
如果你的服务是路由器、判别器或 Agent 决策器,而且经常围绕同一状态问多个问题,Flide 很值得实测。接入时别只盯吞吐,至少同时做三组检查:每个分支与独立 prompt 的输出差、不同并发下的 top answer 和阈值翻转、历史增长后的边际延迟。
状态边界也要治理。共享主干应当是所有独立 prompt 的真正公共前缀,分支不能偷偷携带前一个问题留下的文本或分隔符。对使用概率阈值的业务,默认模式与 batch-invariant 模式要分开压测;后者不是免费开关。以 Qwen3.5-4B 的单问题 RACE 为例,位级一致率从默认的 26.7% 提到 100% 时,独请求延迟从 10.8 ms 增到 14.5 ms,C64 吞吐则从 204 降到 184 req/s。
如果你正在自研引擎,即使不直接用 Flide,也可以借走它的观察:请求的逻辑拓扑应该成为执行元数据,而不是被迫写进 token 序列。这句话放到很多树形、分支型推理负载上,都很有杀伤力。
📚 参考资料
- Flide 论文:https://arxiv.org/abs/2610.42148
- Flide 代码:https://github.com/OmniJev/flide
- Gated Delta Networks:https://arxiv.org/abs/2412.06464
- vLLM / PagedAttention:https://arxiv.org/abs/2309.06180
- SGLang / RadixAttention:https://arxiv.org/abs/2312.07104
- Defeating Nondeterminism in LLM Inference:https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我