从 27 题到 7 题:OpenFrontiers 把科学再发现和答案检索分开了
一个 AI 智能体在三小时内交出 27 份可通过 Lean 检查的研究级数学证明,听起来已经很像“自动数学家”了。把网络关掉,同一套系统只解出 7 题;再剔除与模型自身谱系和知识截止日冲突的题目,干净成绩是 4/15。
这个落差很刺眼,也很有价值。它逼着我们追问:模型是在重新发现一个数学结果,还是找到了别人已经公开的证明?
OpenFrontiers 没有靠更难的题把这个问题糊过去,而是把开放问题库、时间锚定的再发现基准、形式化判题和联网对照实验装进同一套评测。说实话,我觉得它最值钱的地方不是 12,151 条问题记录,而是给“AI 会做科研”这句宽泛判断装上了一套可审计的刻度。
核心摘要
OpenFrontiers 针对研究级 AI 评测中答案泄漏、开放题难判分和成功演示缺少统一预算的问题,构建了含 12,151 条记录的开放问题语料库,以及 200 道带 Lean 4 命题的 OpenFrontiers-Bench。七个智能体在 HQ-50 上接受闭卷、冻结检索和实时联网测试:闭卷续跑最高仅解出 7/40,联网最高达到 27/40,而 181 次联网成功中有 167 次抓取过已定位的答案来源。它不是新的证明器,而是一把区分科学再发现与答案检索的尺子;评测设计比榜单排名更耐读。
论文信息
- 英文标题:OpenFrontiers: A Collection of Open Research Problems and a Benchmark for Scientific Rediscovery
- 作者:Jiarui Yao、Ruida Wang、Tong Zhang
- 机构:University of Illinois Urbana-Champaign(论文 HTML 署名)
- 提交时间:2026 年 10 月 27 日,v1
- arXiv:2610.37739
- 论文链接:https://arxiv.org/abs/2610.37739
- 数据集与基准:https://huggingface.co/collections/FlippyDora/openfrontiers
研究级问题为什么比普通难题更难评测
竞赛题再难,也有一个现成答案。研究问题恰恰没有。
这个区别会带来一连串麻烦。GPQA、FrontierMath、Humanity’s Last Exam 等基准可以用专家预留的答案判分,但它们测的是“解决已知可解问题”的能力;miniF2F、ProofNet、PutnamBench 把证明交给 Lean 等形式系统检查,却主要处理已经被人类证明的命题。至于真正开放的问题,连“什么算解决”都需要先定义:自然语言证明是否接受?一个有限反例够不够?模型证明的命题是否忠实于原问题?
还有污染。静态竞赛集容易进入训练语料,新题也只能缓解一部分问题。一个模型可能在公开解答出现前完成训练,却由同一模型谱系生成了那份解答;这时“知识截止日早于答案发布日期”仍然不能保证它是在独立再发现。
我的第一反应是,这比普通的 benchmark 污染更难缠:污染不只藏在训练集里,还可能藏在模型自己的研究产出里。OpenFrontiers 因此把“谱系排除”和“截止日期排除”拆开处理,而不是只给每道题贴一个发布日期。
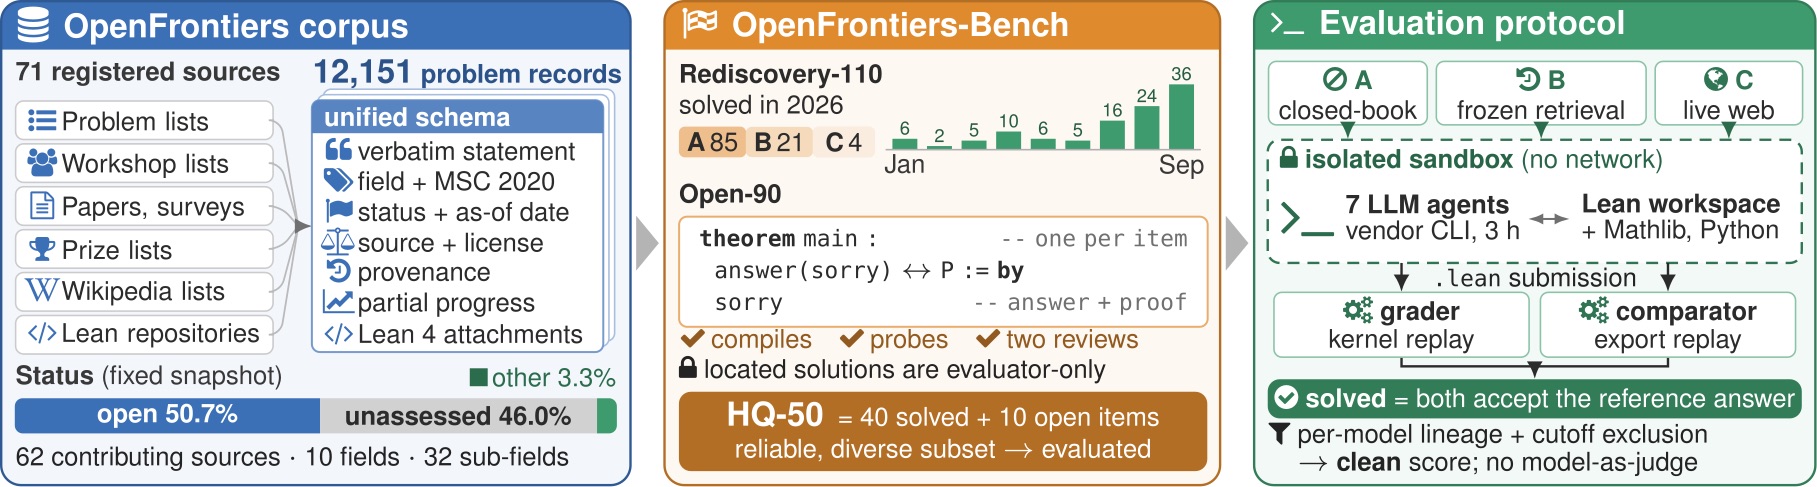
图 1:OpenFrontiers 的三段式结构。左侧把 71 个注册来源规范化为 12,151 条问题记录;中间形成 Rediscovery-110、Open-90 和 HQ-50,解答仅供评测方使用;右侧在隔离沙箱中运行七个智能体,分别测试闭卷、冻结检索和实时联网,只有 grader 与 comparator 同时接受且答案一致才记为 solved。图片下方还标出了按模型谱系和截止日排除后的 clean 分数。
三层资源:先画地图,再选考场,再统一判卷
OpenFrontiers 不是单一数据集。它把语料库、可判分子集和评测协议耦合起来,每一层承担不同职责。
| 层级 | 规模与内容 | 解决的问题 |
|---|---|---|
| OpenFrontiers Corpus | 12,151 条问题记录,另有 4,751 条目录项 | 开放问题散落各处,来源、状态和许可不统一 |
| OpenFrontiers-Bench | 110 道 2026 年已有解答的问题,加 90 道仍开放的问题 | 提供时间锚定、可形式化判分的研究任务 |
| HQ-50 与评测协议 | 40 道已解决题、10 道开放题,三种检索条件 | 在统一预算下区分独立求解、旧资料辅助和在线找答案 |
语料库保留出处,也保留“不确定”
快照日期是 2026 年 10 月 10 日。71 个注册来源中有 62 个真正贡献问题记录,覆盖 10 个一级领域、32 个子领域。来源包括问题清单、研讨会报告、综述中的开放问题章节、奖项页面、博客、Wikipedia 列表和 Lean 仓库。抓取器是确定性的,原始文件带校验和;统一 schema 保存原始题面、领域、MSC 2020 分类、状态及状态日期、来源与许可、参考文献、溯源信息、Lean 附件和阶段性进展。
这里有个很克制的设计:来源没有明确说明当前状态,就标成 unassessed,而不是顺手当成 open。状态标签表达的是“来源在某个日期这样声称”,不是作者重新验证了数学史。
所以,6,162 条 open 和 5,591 条 unassessed 不能混成一句“库里有一万多个未解问题”。未评估记录占 46.0%,其中 AIMPL、TheoremDB 和 Formal Conjectures 贡献了 5,167 条。这个标签多少有些保守,却比虚报开放性可靠。
| 语料指标 | 原始数值 |
|---|---|
| 问题记录 / 目录项 | 12,151 / 4,751 |
| 注册来源 / 实际贡献来源 | 71 / 62 |
| 数学记录 | 11,349,占 93.4% |
| open / unassessed | 6,162 / 5,591 |
| partially-solved | 354 |
| solved / disputed / withdrawn | 41 / 2 / 1 |
| 至少一个 MSC 2020 分类 | 8,011,占 65.9% |
| 带 Lean 4 命题的记录 | 1,946,占 16.0% |
| Lean 附件 / 含 placeholder 标记 | 1,961 / 1,562 |
| 已知提出年份的记录 | 3,389,占 27.9% |
覆盖度也有明显偏科。数学占 93.4%,其余 802 条主要是物理 339 条、计算机科学 285 条和机器学习 70 条。叫它跨学科资源没有问题,把它理解成各学科均衡的科研地图就会误判。
形式化覆盖更不能高估。1,961 份 Lean 附件中有 1,562 份带 sorry 或 admit 等占位符,语料导出时也不执行 Lean 检查。它们适合定位和展示问题,不是现成的可判分证明题。真正的质量门槛放在了 200 题基准里。
200 题基准用“回头看”制造可控答案
Rediscovery-110 收录曾经公开开放、进入 2026 年后才找到解答的问题。因为答案现在已经公开,评测方可以形式化判分;因为模型看到的是解决前的题面,它又能模拟研究时的信息条件。Open-90 则保留 90 道仍开放的问题,用来观察模型能否越过已知边界。
候选筛选并不只是爬状态标签。九轮搜索得到 291 个不同的已解决候选,257 个通过核验,230 个通过初筛;开放题方向筛过 1,061 个 Formal Conjectures 声明,留下 152 个已核验候选中的 136 个。另一位独立复核者尝试推翻新项目,又拒绝 5 个。旧版复审还删除了“答案早已存在”和“解答声明被驳倒”的题,并把 4 道在 2026 年解决的开放题移入 Rediscovery-110。
证据可靠性分三档:
| 证据等级 | 数量 | 接受标准 |
|---|---|---|
| Tier A | 85 | 独立重算精确有限证书,或本地编译完整 Lean 证明 |
| Tier B | 21 | 来源列表、出版物或独立证明相互印证,但作者未重新验证 |
| Tier C | 4 | 已有解决声明,仍等待核验 |
85 个 Tier A 中,75 个依赖完整 Lean 证明,另外 10 个依赖精确证书。所有已定位解答证据都晚于 2026 年 1 月 5 日,且 76 道题的证据日期晚于 2026 年 6 月 30 日,给冻结模型留下了一批真正的新材料。
每道题都被写成固定环境中的 theorem main。环境锁定 Lean 4.33.1、Mathlib 0df444a 和 Formal Conjectures 89294ea;93 份命题原样采用上游版本,47 份做适配,60 份新写。是非题采用 answer(sorry) ↔ P 的形式,模型既要填 True 或 False,也得证明整个命题,猜中答案不算分。
质量检查包含两层。自动探针确认 110 道已解决题的参考答案可以编译,答案、上游标识和实时状态链接没有泄漏,decide、simp、omega、aesop 无法直接解决或反驳任何一道题。两路独立复核分别检查原题忠实度和 Lean 语义,最多修复两轮,得到 139 个 ok+ok、38 个 minor+ok、23 个 minor+minor,没有遗留 must-fix。
有一点必须说清楚:论文附录明确写明,这些复核由 AI agents 执行。这里的“两次独立评审”不能直接理解成两位人类数学家逐题背书。形式内核能验证证明,却不能自动证明“形式命题就是原始研究问题”;命题忠实度仍然是信任链中较软的一环。
HQ-50 的高分不等于整个数学前沿
HQ-50 从 200 题中可复现地筛出 40 道已解决题和 10 道开放题。硬过滤要求高形式化置信度、干净复核结果、Tier A 已解决证据,以及足够的重要性与清晰度;贪心选择再限制同一论文、问题家族、公开发布批次、来源和领域的占比。
40 道已解决题里,34 道有 Lean 证明参考,6 道有精确证书;32 道位于模型截止日之后。按关键数学产出的归属,21 道来自 OpenAI 模型,2 道来自 Anthropic,2 道来自 Google,2 道来自其他 AI,13 道来自人类。
这个组成很新,却也决定了分数的含义。它不是对所有数学领域的均匀抽样,而是一份强调近期、高质量、可形式化证据的切片。后文看到少数短构造题贡献大多数成功时,这个限制尤其重要。
三种联网条件,把“会做”与“会找”拆开
评测最漂亮的一步,是只改变检索权限,其余环境尽量保持一致。
| 条件 | 检索范围 | 它主要测量什么 |
|---|---|---|
| A:closed-book | 不检索 | 模型在沙箱内独立构造并形式化证明的能力 |
| B:frozen retrieval | arXiv、Wikipedia、OpenAlex、MathOverflow 等,只开放 2026-01-06 前的历史内容 | 旧文献能否辅助再发现 |
| C:live web | 实时网络,记录全部 URL | 已公开解答的可检索性,以及智能体找答案的能力 |
冻结检索的日期比最早解答证据提前一周。搜索引擎即使返回今天的索引文本,系统也会重新核对命中内容对应的历史版本。实时联网则不是独立的科研能力分数,而是泄漏参照系:40 道已解决题中有 34 道已经公开 Lean 证明,能找到并适配答案本来就是任务的一部分。
每次尝试拿到一个全新沙箱,只有当前题目的 Lean workspace、预构建 Mathlib,以及带 numpy、sympy、mpmath 的 Python。答案包、评测材料和判分工作区不可见;命令以非特权用户运行,网络命名空间、seccomp 和 cgroup 都有限制。每次预算为 3 小时、5 个 CPU 核、24 GB 内存,每题每条件只跑一次。
七个系统并不只是七个裸模型。Claude Sonnet 5.5、Kimi-K3、GLM-5.3、DeepSeek-V4.1-Flash 和 Qwen3.8-27B 通过 Claude Code 运行,GPT-6.1-sol 和 GPT-6-luna 通过 Codex 运行。厂商 CLI 自带系统提示、工具、上下文管理和默认推理设置,所以结果测的是“模型加智能体框架”,不是严格受控的纯模型对比。
运行协议又分两档。native 让智能体自己决定何时结束;continuation 会在它提前停下时恢复同一会话,告知剩余预算,直到提交通过预检查或耗尽时间。这个设计来自一个实际现象:有些前沿智能体面对难题几分钟就宣布做不了,三小时预算几乎没用。
双检查器不接受“看起来像个证明”
主指标只认 Lean 文件,自然语言证明和证书可以附带,但单独报告。静态规则禁止 sorry、自定义公理、native_decide、元编程和语法扩展,只允许 Mathlib imports。
设提交为 \(s\),内部 grader 为 \(G\),独立 comparator 为 \(C\),提交答案为 \(a(s)\),判定逻辑可以压缩成:
grader 在独立 jail 中编译参考命题和提交,重放 kernel,对比 elaborated definitions 与 main 的命题,只允许 propext、Classical.choice 和 Quot.sound 三类标准公理。第二个检查器 leanprover/comparator 则比较命题涉及的每个常量,并在不加载提交方额外文件的情况下重放完整导出环境。两者意见不一致就记为未解决,没有 model-as-judge。
你想想看,这套判分挡住的并不只是自然语言里的含糊步骤,还包括偷偷改命题、引入额外公理、利用编译期写文件影响判分等攻击。作者还跑了接受/拒绝自测,以及 comparator 的 16 个官方回归攻击用例。
实验结果:联网成绩很高,独立再发现很少
闭卷最高 7 题,干净口径只剩 4/15
下面保留 continuation 协议的完整主表。all 的分母统一为 40;clean 按模型删除其谱系产生关键数学的题,以及解答证据不晚于模型截止日的题,因此每行分母不同。
| 模型 | A 闭卷 all | A 闭卷 clean | B 冻结检索 all | B 冻结检索 clean | C 实时联网 all | C 实时联网 clean |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 4 | 3/30 | 3 | 3/30 | 24 | 18/30 |
| GPT-6.1-sol | 7 | 4/15 | 5 | 3/15 | 27 | 12/15 |
| GPT-6-luna | 2 | 2/15 | 0 | 0/15 | 16 | 6/15 |
| Kimi-K3 | 3 | 3/33 | 2 | 2/33 | 15 | 13/33 |
| GLM-5.3 | 0 | 0/16 | 2 | 2/16 | 13 | 5/16 |
| DeepSeek-V4.1-Flash | 3 | 1/5 | 3 | 1/5 | 15 | 2/5 |
| Qwen3.8-27B | 0 | 0/19 | 0 | 0/19 | 2 | 0/19 |
最抢眼的当然是 GPT-6.1-sol:闭卷 7/40,联网 27/40。可一旦看 clean,闭卷是 4/15,联网是 12/15。两个数字都真实,却回答不同问题。前者说明系统在完整近期集合上的产出,后者更接近“排除自身谱系和已知旧答案后还能做什么”。
这里我不会把 7/40 直接写成 17.5% 的“科研成功率”,再拿去和 4/15 横向排名。分母变了,任务难度也随排除项改变。尤其 DeepSeek-V4.1-Flash 发布较晚,clean 只剩 5 道,1/5 与 GPT-6.1-sol 的 4/15 不是同等统计精度的比较。论文坚持同时给分子和分母,这个处理很必要。
native 协议下,闭卷只有 0–3 题;continuation 把上限推到 7 题。Claude Sonnet 5.5 从 0 到 4,GPT-6.1-sol 从 2 到 7,GPT-6-luna 从 0 到 2。提升并不全是模型突然想出了新数学,也反映 harness 是否允许它持续尝试、编译、修复和提交。
冻结检索没有带来稳定收益。14 次 A/B 对照中,B 只在两次运行里超过 A,分别多 1 题和 2 题;另有三次反而更低。这与快照早于全部解答的设定一致:旧资料可能提供工具,却不会直接吐出 2026 年的答案。
成功高度集中在少数短构造题
把 7 个模型、2 种运行协议合起来,A 和 B 一共出现 53 次成功,只落在 8 道题上。R01、R04、R29 三道 importance-3 题都由人类用短构造解决,它们贡献了 44 次成功,约占 83.0%。21 道 importance-5 题里,只有 N28 被解出一次,而且靠有限证书完成。
这个结果比总分更能校准预期。模型确实能独立重新发现少量研究级构造,不能据此推出它已经能稳定攻克长期开放问题。少数可搜索、可验证、证明较短的题,很容易在重复模型与协议统计中放大成功次数。
联网成功中,92.3% 抓到了答案来源
实时联网下,各系统解出 1–27 题,总计 181 次成功。其中 167 次的尝试抓取过作者已定位的答案来源,包括预印本、代码仓库或问题页面,占 92.3%。这些来源经常直接带公开 Lean 证明,智能体要做的是找到、适配并通过检查。
Erdős Problem #152,也就是 E03,是一个很干净的例子。DeepMind 的证明智能体在 2026 年 4 月 3 日公开了 Lean 证明。28 次闭卷或冻结检索尝试无一成功,14 次实时联网运行却有 11 次解出,而且每次都先抓了问题页或其论坛讨论,再顺着链接拿到证明。
这绝不是“联网没用”。恰恰相反,检索把成绩从个位数推到最高 27 题,说明智能体作为研究助手已经很会利用公开材料。但把 C–A 的差值称作数学创造能力,就会把信息检索算成科学发现。
即便实时联网,也没有任何系统解满 40 道已解决题。检索、来源选择、证明适配和形式化修复仍然会形成瓶颈。开放题这边,附录记录了 continuation 联网条件下 3 次“双检查器暂时接受”的事件,分别来自 GPT-6.1-sol、GLM-5.3 和 DeepSeek-V4.1-Flash;表格明确标注这些发生在 review 之前,不能直接记为确认的新数学。正文报告的结论仍是:没有开放题在不依赖已公开解答的情况下被解决。
智能体过早放弃,是会改变榜单的变量
native 模式下,Claude Sonnet 5.5 和两个 GPT 系统的多数尝试在 0.3–4.1 分钟的中位时长就结束,而预算是 180 分钟。Claude 在闭卷 native 下甚至 50 次中有 49 次由智能体主动停止,只留下 3 次 .lean 提交。
continuation 后,GPT-6.1-sol 闭卷中位时长达到 180 分钟,50 次都留下正式提交;Claude 闭卷中位时长只有 5.1 分钟,41 次因持续无工具操作而被判 stalled。同样的模型,在“自己决定停下”和“被反复要求继续”两种协议下表现不同。
坦白讲,这个发现对智能体评测的启发不输给主结果。研究能力不只是一次采样的证明能力,还包含是否愿意维护假设、尝试反例、调用计算工具和修复编译错误。一个过早退出的 CLI,可能把模型能力低估成“不愿工作”。
和相邻基准相比,它到底多做了什么
| 基准 | 题目状态 | 判分方式 | 与 OpenFrontiers 的关键差别 |
|---|---|---|---|
| miniF2F | 已有形式化答案的竞赛题 | 定理证明器 | 适合证明能力评测,不提供近期科研再发现的时间锚 |
| FrontierMath | 专家新写、答案预留的研究级问题 | 精确答案自动验证 | 难度高,但多数不是曾经公开开放的问题 |
| FrontierMath Erdős | 68 道截至 2026 年 8 月仍开放的 Erdős 问题 | Lean 证明或否证 | 直接测开放题,不提供 110 道近期已解决题的检索对照 |
| OpenFrontiers | 110 道近期已解决题,加 90 道开放题 | 双 Lean 检查器,加谱系与截止日排除 | 同时提供大规模语料、时间锚定、三种检索条件和 clean 口径 |
FrontierMath Erdős 是很接近的前置工作。它在 68 道开放 Erdős 问题上统一评测五个 AI,每题预算 300 美元,最好成绩为 3%,其余为 0%。OpenFrontiers 的补位不是“题更多”这么简单,而是引入近期已解决题作为可判分的回溯赛道,再用实时联网量化答案可检索性。前者更像真正的前沿考试,后者多了一台分离求解与检索的实验仪器。
我的判断:评测设计很扎实,分数边界也要看清楚
这套工作有三处让我愿意反复引用。
它把来源声称和已验证事实分开了。unassessed 不被包装成 open,Tier A/B/C 不混成同一个“已解决”,混合许可也不被抹成统一开放许可。对数据集工作来说,这些不那么炫目的字段决定了后续研究能不能复核。
它把模型谱系纳入污染控制。55 道 Rediscovery-110 的解答材料把关键数学归功于 AI,其中 OpenAI 模型涉及 46 道、Anthropic 5 道、Google 4 道、Harmonic 3 道,部分题目有多个归属。仅用发布日期做时间切分,会漏掉“同一谱系已经生成答案”这条通路。
它没有把 Lean 通过当成全部真相。开放题被接受后仍触发命题审查,checker 分歧记未解决,clean 结果保留分母。这些规则让分数不那么好看,却让结论更耐用。
局限同样明显。跨学科语料有 93.4% 是数学;形式化评测又进一步偏向容易写成 Lean 的离散数学、有限构造和证书问题。HQ-50 只有 40 道已解决题,成功还集中在三道短构造上,小样本波动很大。不同厂商 CLI 的系统提示和上下文策略没有统一,continuation 也改变了人与 harness 的交互方式,因此模型间排名不够纯净。两路命题复核由 AI agent 完成,忠实度仍需要更多人工作业抽查。
还有一个成本问题:论文报告了墙钟时间和计算资源,却没有在主结果中给出 API 费用。每题每条件一次、三小时、两种协议、七个系统,实际研究成本可能相差很远。若要把“自动科研”用于真实项目,仅看 pass@1 还不够,还需要每次接受证明的美元成本与人工复核成本。
所以,我不把 OpenFrontiers 读成“AI 科研能力只有个位数”的判决书。它证明的是更窄也更有用的事:在这套近期形式化数学任务、三小时预算和当前智能体框架下,独立再发现很少,实时检索很强,持续运行策略会改变结果。超出这个边界去谈通用科学智能,证据还不够。
对工程实践的启发
做研究型智能体评测时,可以把闭卷、历史检索和实时联网作为三个独立产品指标。闭卷衡量内部推理,冻结检索衡量文献增强,实时联网衡量研究助手的工作流价值。三者都重要,但不能混成一张总分榜。
如果题库包含 AI 参与解决的近期问题,过滤规则要按模型谱系定制,并保留每项的分母。只报一个百分比,会把可比较性弄丢。对开放题,kernel 接受应当是“进入人工审查”的触发器,而不是自动发新闻的按钮。
在智能体框架上,native 和 continuation 也值得同时保留。前者反映自主任务管理,后者逼近固定预算下的能力上限。二者差异本身就是研究对象:它暴露的是持久性、停滞检测、工具调用策略和提交机制的问题。
若要把这套资源用于训练或二次发布,还要逐条检查许可。附录明确说明 OpenFrontiers 不为第三方材料授予新的统一许可,条款从 CC0、Apache-2.0 到 CC BY-SA、CC BY-NC-SA 不等。它适合找研究问题和做评测,不是一份可以直接当成宽松许可训练语料的大礼包。
OpenFrontiers 最终留下的,不是一个“AI 能否取代数学家”的答案,而是一套更诚实的提问方式:它独立解出了什么,找到了什么,用了多久,在哪一组干净题目上成立?把这几件事分开,科研智能体的进步才会从精彩演示变成可追踪的曲线。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我