不再寻找万能 Harness:让兄弟框架把失败任务救回来
调过 Agent 的人大概都遇到过这种尴尬:给系统加了一条“记得翻页”的规则,信息收集任务确实变好了;换成软件修复任务,这条规则却可能挤占上下文、扰乱原有流程。再补一条“及时提交答案”,另一批任务又开始出现新的回归。
模型权重明明没变,为什么改几段提示、几个 hook,行为差异会这么大?
Harness-S 抓住的正是这个矛盾。它没有继续追求一个集所有修补于一身的“万能执行框架”,而是保留一组各有偏科的兄弟 Harness:训练时,只有基础 Harness 的所有尝试都失败,才请这些兄弟来救场;救援产生的轨迹再用来更新同一个策略。真正让我感兴趣的是,测试时可以把辅助 Harness 全部撤掉,模型依然保留了一部分学到的行为。
核心摘要:Harness-S 面向长程 Agent 训练中“全失败采样组没有相对奖励信号”的问题,用方向化演化建立固定的兄弟 Harness 池,再由自适应路由器挑选 Top-8 框架,对基础框架全失败的任务重新采样并做 GRPO 更新。Qwen3.5-4B 回到原始 Harness 后,AppWorld、SWE-Gym、DBBench 的 Pass@3 分别比 GRPO 高 7.25、14.37、6.66 个点。这不是单纯“部署时换更好框架”的技巧,核心看点在于辅助执行经验能否内化进策略;论文用原框架评测、行为统计和留出案例给出了相当有分量的证据。
论文信息
- 标题:Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training
- arXiv ID:2611.04277
- 版本与日期:v1,2026 年 11 月 3 日提交
- 作者:Kangning Zhang、Wenxiang Jiao、Bowen Fang、Shuai Shao、Jiachen Zhu、Rong Shan、Shijian Wang、Hao Wang、Yuan Lu、Weiwen Liu、Weinan Zhang
- 机构:Shanghai Jiao Tong University、Xiaohongshu Inc.、Zhongguancun Institute of Artificial Intelligence、Southeast University、Carnegie Mellon University
- 论文链接:https://arxiv.org/abs/2611.04277
- 代码:https://github.com/DeepExperience/Harness-S
Harness 不是外包装,它就在策略的输入里
这里的 Harness 指模型外面的整套执行系统:提示词、工具接口、上下文与记忆机制、执行规则、hook 等。策略 \(\pi_\theta\) 并不直接面对环境,它看到的是 Harness 组织后的上下文,输出的动作也要经过 Harness 才能落地。
对任务 \(x\),策略在 Harness \(H\) 下生成轨迹 \(\tau\),验证器给出二元结果 \(R_x(\tau)\in\{0,1\}\)。这套组合的任务效用写成:
这个定义很简单,却把论文的出发点说清楚了:任务成功率属于策略与 Harness 的组合,不属于模型权重本身。只优化其中一边,都可能把另一边的贡献误算进去。
作者从同一个基础 Harness \(H_0\) 派生变体,并总结了三条性质。
| 性质 | 观察到的现象 | 对训练的麻烦 |
|---|---|---|
| Locality,局部性 | 一次编辑修复一批失败,也会让原本成功的任务回归 | 把所有修补堆进一个框架,可能相互干扰 |
| Complementarity,互补性 | 不同变体能救回彼此失败的任务 | 只保留平均分最高的一个,会丢掉覆盖能力 |
| Nonstationarity,非平稳性 | 策略更新后,同一变体可能从有帮助变成有拖累 | 训练前排好的 Harness 名次,训练中会失效 |
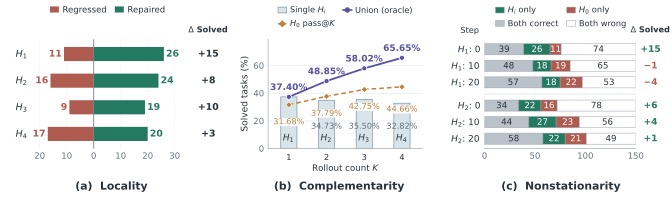
图 1:在 Qwen3.5-4B、AppWorld 上,\(H_1\) 到 \(H_4\) 都同时带来修复与回归,净修复数分别为 15、8、10、3。中图的 oracle 联合覆盖随变体数增加,从 37.40% 升到 65.65%,高于相同 rollout 数下重复使用 \(H_0\) 的 44.66%。右图更直接:\(H_2\) 在 step 1 的净修复为 15,到 step 20 变成 -4;固定排名确实靠不住。
说实话,这三条观察比后面的框架名字更值钱。很多 Agent 优化工作默认“找到一个更好的 scaffold,再把它部署出去”,而这里把 scaffold 看成一组互补的探索装置。问题随即从“哪个最好”变成“什么时候该用哪一个”。
Harness-S:训练时借路,部署时还能走老路
整个系统可以拆成三块:方向化 Harness 演化负责建池,互补救援训练负责产生可学习的轨迹,自适应路由器负责把任务分给合适的兄弟变体。
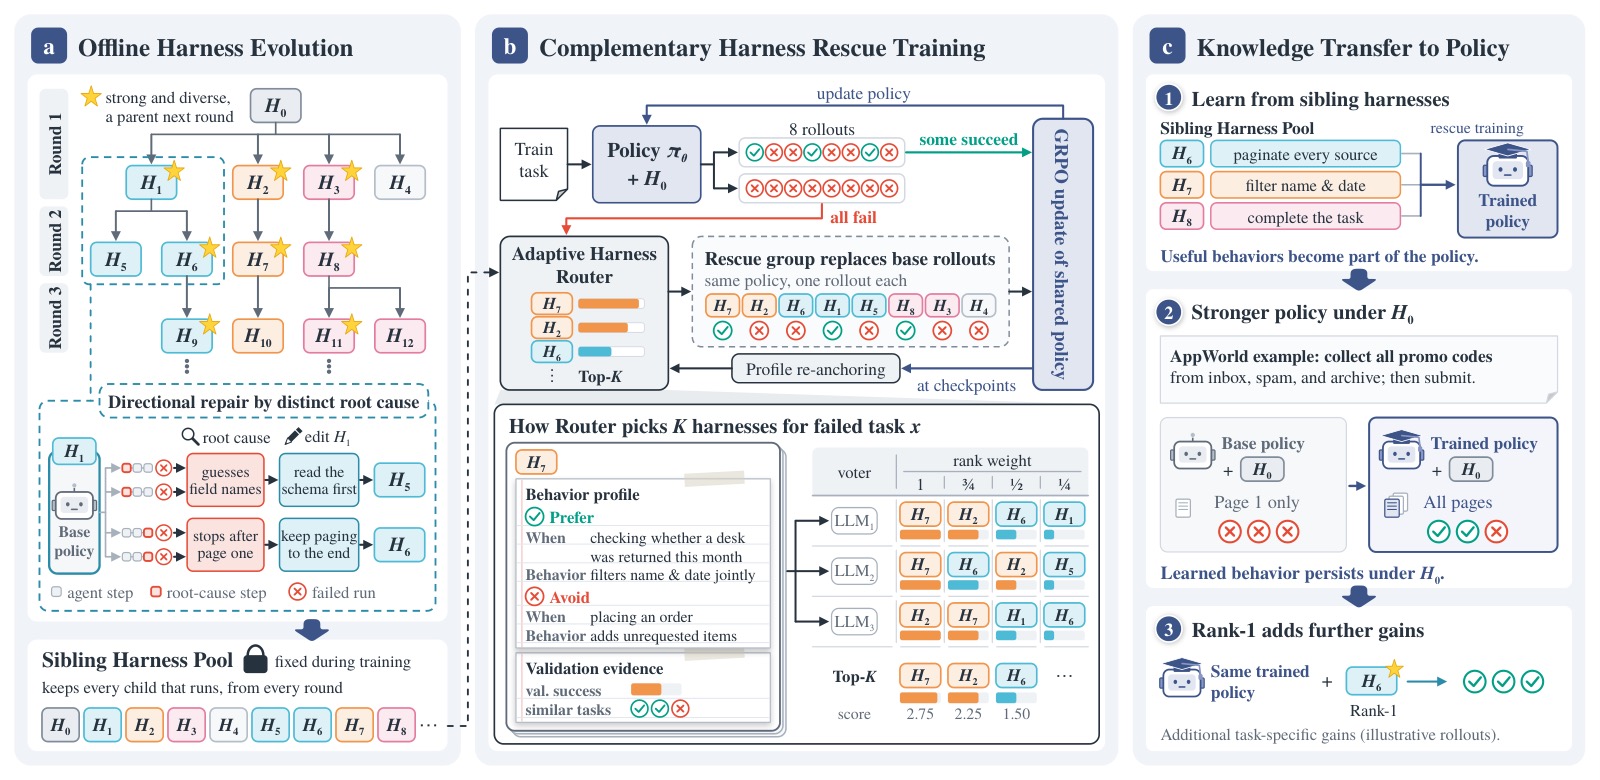
图 2:左侧从 \(H_0\) 开始按不同根因分支编辑,保留所有可运行、符合协议的子代,训练期间锁定 Harness 实现。中间先让当前策略在 \(H_0\) 下采样 8 条轨迹;全失败时,路由器选出 8 个辅助 Harness,每个生成 1 条新轨迹,用救援组替换原采样组做 GRPO。右侧强调两件事:辅助 Harness 诱导出的行为要回到 \(H_0\) 保留下来;若推理时继续使用 Rank-1 路由,还能再拿一部分任务级选择收益。
1. 不把修补揉在一起,而是沿失败根因分支
第 \(g\) 轮从父代集合 \(\mathcal{P}_g\) 出发。系统在新训练任务上执行父代,归因失败轨迹,把多个任务中相关的局部根因归成一个修复方向 \(d\),再让编辑器生成子代:
关键不在“让 LLM 改配置”,而在下一轮父代怎么选。设 \(\mathcal{V}(H)\) 是变体在冻结策略下解决的验证任务,至多选择 \(B\) 个父代,目标是最大化联合覆盖:
同一个任务被多个变体解决,只计一次。这会偏好“你补上我的盲区”,而不是几个高分但能力重叠的候选继续近亲繁殖。没被选为父代的有效子代也不会丢弃,全部进入兄弟池:
AppWorld 的具体搜索跑了 3 轮,提案预算为 7/8/8,每轮最多 4 个父代。编辑可触及 Prompt、Skill、Context、Memory、Hooks、Tool View 六类组件。最终池中有 \(H_0\) 加 19 个辅助变体;策略训练时这些实现不再改变。
这个设计挺务实:搜索阶段允许大刀阔斧,训练阶段却冻结代码,避免“策略在变、执行系统也在变”带来的联合非平稳性。仍然变化的只有路由证据。
2. 只有八次全失败,才触发救援
每个任务先在 \(H_0\) 下生成 \(K=8\) 条轨迹,形成 \(\mathcal{G}_0(x)\)。只要有一条成功,就保留原始组;八条全失败,才从辅助池选择 8 个不同 Harness,各做 1 次从初始状态出发的新尝试:
为什么非要有成功也有失败?GRPO 用组内奖励的均值和标准差构造优势:
全失败时 \(\bar r_x=0\)、\(\sigma_x=0\),所有轨迹的优势都为 0。多采八次若还是全失败,计算花了,学习信号仍是零。救援组若能救回一条成功轨迹,同时保留其他失败轨迹,就立刻出现正负对比。
这和 DAPO 的 Dynamic Sampling 有个值得对照的差别。DAPO 会过滤全对或全错的采样组,继续采样直到凑够有效组;Harness-S 则改变执行支持,试图在同一个难题上主动制造奖励差异。一个侧重筛选,一个侧重救回。对长程 Agent 来说,后者更有针对性,因为失败常来自缺少某个具体操作行为,而不只是答案采样噪声。
更新只作用于策略 token,Harness 注入的指令和工具观察不进入损失。辅助轨迹计算概率比率时仍保留其生成上下文 \(c_H\),因此训练并没有假装这些 token 是在 \(H_0\) 下产生的。策略比率的 clipping 参数为 \(\eta_-=0.20\)、\(\eta_+=0.28\),不使用参考模型 KL 项;rollout 与训练后端的概率差异还用截断到 0 至 2 的权重校正。
3. 路由器不背固定答案,而是持续重估兄弟变体
每个辅助 Harness 都有一份 Harness Behavior Profile,包含 prefer 与 avoid 两类条目。每条记录可以概括成:
也就是“什么任务条件下,它相对 \(H_0\) 表现出了什么帮助或伤害”。附录里的例子很具体:有的变体要求遍历所有分页来源,有的要求先分别取条件再求交集,有的在执行预算只剩 3 步时提醒保留一步提交答案。这些不是抽象标签,而是从成对验证轨迹归纳出的行为差异。
路由时,多个 LLM 独立给出候选排名。每张选票列 4 个候选,名次权重依次为 1、3/4、1/2、1/4,未列入者得 0 分;加权求和后取 Top-8。推理阶段则在包含 \(H_0\) 的全部 20 个 Harness 中选 Rank-1,选择发生在执行前,三个评测 rollout 共用同一选择。
更关键的是 re-anchoring。AppWorld 4B 实验中,训练前建立画像,每 10 次更新重新校准一次,结束后再用最终策略校准。每次校准都冻结当前策略,在相同验证任务、初始状态和执行限制下对比各变体与 \(H_0\),不使用测试结果。
所以,固定的是 Harness 代码,刷新的是“它对当前策略还有什么用”的证据。这个拆分正好对应前面的非平稳性观察。
池子的互补性也有量化检查。作者在 149 个共同验证任务上比较 9 个兄弟变体,每个变体单独修复 11–15 个 \(H_0\) 失败任务,联合覆盖达到 29 个;不同有序变体对的修复集合重叠率平均为 62.47%。重叠不低,但远未完全重合。
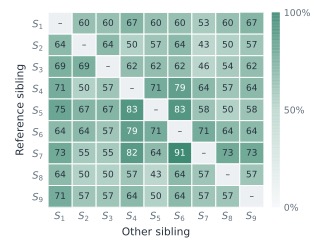
图 5:每个单元格表示“行变体修复的任务中,有多少也被列变体修复”,因此矩阵有方向性。非对角数值从 43% 到 91% 不等,高重叠说明部分修复可替代,低重叠则保留额外覆盖。这里的 29 个联合修复是逐个执行后的 oracle 覆盖,实际路由必须在看到任务结果前做选择,不能直接拿到同样的上限。
实验:撤掉辅助 Harness,提升还在不在?
实验覆盖 AppWorld、SWE-Gym、DBBench,分别对应应用 API、软件工程和数据库任务;模型为 Qwen3.5-4B 与 Qwen3.5-9B,所有实验使用 8 张 NVIDIA H800。训练、验证、测试严格分开,主结果是 3 次独立随机运行的均值,每个任务每次运行执行 3 个 rollout。
- Pass@3:三次中至少成功一次的任务比例,更能体现覆盖能力。
- Avg@3:三次成功率的平均,更能体现执行稳定性。
- \(H_0\) 测试:撤掉辅助支持,检验策略自身留下了多少能力。
- \(H_{\mathrm{rank1}}\) 测试:同一训练 checkpoint,再允许任务级路由,观察额外执行支持的价值。
主结果:不是只有路由后的分数好看
下表保留最关键的对照。所有 Harness-S 与 GRPO 数字都在原始 \(H_0\) 下评测,单位是百分比。
| 模型 | 方法 | AppWorld Pass@3 / Avg@3 | SWE-Gym Pass@3 / Avg@3 | DBBench Pass@3 / Avg@3 |
|---|---|---|---|---|
| 4B | Base | 42.62 / 31.93 | 19.38 / 17.50 | 59.00 / 56.89 |
| 4B | GRPO | 60.31 / 48.98 | 24.38 / 22.50 | 66.67 / 64.00 |
| 4B | GRPO,\(H_0\) 重采样救援 | 61.83 / 51.91 | 25.63 / 23.33 | 67.33 / 64.67 |
| 4B | Harness-S | 67.56 / 56.87 | 38.75 / 28.75 | 73.33 / 71.00 |
| 9B | Base | 50.00 / 39.69 | 23.13 / 20.63 | 63.00 / 60.22 |
| 9B | GRPO | 64.89 / 53.31 | 28.13 / 25.63 | 69.67 / 67.00 |
| 9B | GRPO,\(H_0\) 重采样救援 | 65.65 / 54.83 | 29.38 / 26.88 | 70.67 / 67.78 |
| 9B | Harness-S | 72.52 / 62.34 | 40.00 / 32.50 | 76.33 / 73.44 |
我最看重的是 \(H_0\) 重采样救援这一行。它同样只在全失败时追加采样,和 Harness-S 的差别主要是“继续在老框架里试”还是“换兄弟框架试”。4B AppWorld 上,Harness-S 的 Avg@3 比它高 4.96 个点;SWE-Gym 的 Pass@3 则高 13.12 个点。收益不能只用多花了采样预算解释。
联合优化基线也没占便宜。4B 的 WHALE 使用其选出的固定最优 Harness,AppWorld Pass@3/Avg@3 为 63.36/52.93,Harness-S 回到 \(H_0\) 仍有 67.56/56.87;9B 对应数字为 68.70/58.02 对 72.52/62.34。这个对照比“超过基础模型”更能支撑策略内化,因为 WHALE 测试时还保留着共同演化出的执行支持。
路由当然还能加分。9B Harness-S 在 AppWorld 上从 \(H_0\) 的 72.52/62.34 提升到 Rank-1 的 75.19/67.05,执行 rollout 数不变。可论文没有把这些提升全算到策略头上,而是将两种测试条件并列报告。这个实验边界划得干净。
学习信号:有效组和有效 token 都更多
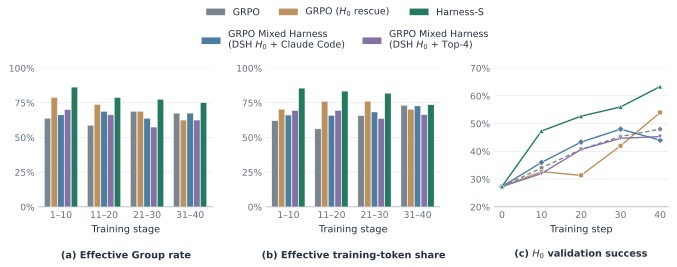
图 3:Harness-S 在四个训练阶段都保持更高的有效组比例和有效训练 token 比例;右图中,它在 \(H_0\) 验证集上的成功率从共同的约 27% 起点持续提升,第 40 步达到 63.33%。灰色普通 GRPO 最终为 48.00%,橙色 \(H_0\) 重采样救援为 54.00%。
这里的 Effective Group 指组内同时有成功和失败的采样组。完整训练过程中,Harness-S 的有效组比例为 79.38%,\(H_0\) 重采样救援为 70.94%,普通 GRPO 为 64.69%。考虑到成功和失败轨迹长度不同,作者还统计了有效组贡献的策略 token 占比:Harness-S 为 80.88%,\(H_0\) 重采样救援为 72.68%。
这两个指标比单看 reward 曲线更有说服力。救援不是只让某批训练样本的回报变高,而是让原本零梯度的组真正参与更新。固定混合 Harness 的两组对照则接近普通 GRPO,说明“整个训练期间到处混用框架”不如“只在基础组失败时定向救援”。
路由消融:刷新画像比堆固定规则更有用
AppWorld 4B 上,所有救援组都固定为 8 条新轨迹。Top-8 Adaptive 就是完整 Harness-S。
| 方法 | Steps 1–10 | Steps 11–20 | Steps 21–30 | Steps 31–40 | 最终 Pass@3 | 最终 Avg@3 |
|---|---|---|---|---|---|---|
| Random Harness | 25.00 | 18.18 | 20.00 | 25.00 | 62.98 | 50.76 |
| Rule Router,无画像 | 40.00 | 26.67 | 27.78 | 44.44 | 66.41 | 52.93 |
| LLM Router,4×2 | 43.48 | 43.75 | 38.89 | 33.33 | 65.65 | 55.60 |
| Top-8 Fixed | 35.71 | 24.24 | 26.67 | 38.89 | 64.50 | 52.16 |
| Top-8 Adaptive | 52.38 | 66.67 | 45.71 | 50.00 | 67.56 | 56.87 |
表中阶段数值是“触发救援的任务里,至少一条新轨迹成功”的比例。Adaptive 在四个阶段都高于 Fixed,最终 Avg@3 高 4.71 个点,直接支持画像重锚定。Top-8 也总体优于 4×2,说明在相同 8 次预算下,广泛尝试 8 种修复方向,比对 4 种方向各试两次更容易碰到可学习行为。
不过我也不会因为这一张表就把 LLM 投票说成必需品。Rule Router 的 Pass@3 达到 66.41,高于 4×2 LLM Router 的 65.65;救援成功率与最终测试排名并非严格单调。画像、宽度、刷新各自贡献多少,仍有进一步拆分空间。
行为迁移:学到的是流程,不只是某个答案
撤掉辅助 Harness 后,策略的具体操作习惯发生了变化。
| 行为 | Base | GRPO | Harness-S |
|---|---|---|---|
| AppWorld:首次 API 调用前查 schema | 22.9 | 38.2 | 67.6 |
| AppWorld:显式分页循环 | 13.8 | 33.5 | 38.3 |
| AppWorld:重复执行相同代码,越低越好 | 15.4 | 30.1 | 9.8 |
| SWE-Gym:测试受阻后改用断言 | 15.4 | 13.3 | 48.5 |
| SWE-Gym:编辑后重测同一失败目标 | 9.2 | 18.2 | 24.1 |
| SWE-Gym:末次编辑后检查 diff | 16.3 | 23.5 | 27.5 |
最抓眼的是“测试受阻后改用断言”从 GRPO 的 13.3% 到 Harness-S 的 48.5%。这类行为不像背下某道题,更像学会一条备用验证路径。两个留出案例也呼应了这一点:训练救援中学到“多个歌曲来源取交集”,测试时能应用到新的歌曲实例;从 Venmo 账号恢复中学到读取验证码、重置密码、验证登录,换到 Amazon 实例也能完成。
当然,行为频率由 LLM 标注完整轨迹得到,案例也只有精选的两个。它们增强了机制解释,但还不能替代更大规模、带人工复核的因果归因。
路由依赖下降,跨 Harness 仍然敏感
训练前,Rank-1 相比 \(H_0\) 的 AppWorld Pass@3 优势为 14.21 个点;训练后缩到 0.76 个点。Avg@3 的差距也从 13.49 缩到 4.58。与此同时,\(H_0\) 被路由器排在首位的任务比例从 1.53% 升到 22.52%。
这组结果很聪明:它没有只靠最终分数讲“内化”,还观察了路由器是否越来越愿意选择原框架。策略变强后,辅助支持的自然需求确实下降了。不过 Avg@3 仍有 4.58 个点差距,说明执行支持对稳定性的作用没有消失。
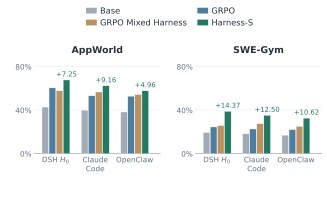
图 4:Qwen3.5-4B 在 Claude Code、OpenClaw 等未用于对应训练的 Harness 上,Harness-S 仍高于普通 GRPO。相对 GRPO 的 Pass@3 提升在 AppWorld 三种执行环境下分别为 7.25、9.16、4.96 个点,在 SWE-Gym 分别为 14.37、12.50、10.62 个点。所有外部环境的绝对分数又都低于 DSH \(H_0\),可见策略能力迁移了,接口敏感性并没有被消除。
成本与工程账:救援不是免费的,但花得比较有方向
AppWorld 4B 的 40 次更新中,普通 GRPO 使用 2,560 条训练 rollout 和 50.58 GPU 小时;Harness-S 使用 3,032 条和 67.19 GPU 小时,rollout 多 18.44%,换来 \(H_0\) Avg@3 增加 7.89 个点。\(H_0\) 重采样救援则用了 3,616 条和 97.77 GPU 小时,最终 Avg@3 只有 51.91,低于 Harness-S 的 56.87。
| 方法 | 搜索 rollout | 额外训练 rollout | GPU 小时 | 外部模型 API token |
|---|---|---|---|---|
| Meta-Harness | 8,000 | 0 | 35.24 | 4.89M |
| WHALE | 8,640 | 2,560 | 95.84 | 9.80M |
| HarnessForge | 5,680 | 0 | 65.39 | 24.40M |
| Harness-S | 4,010 | 3,032 | 75.79 | 18.69M |
Harness-S 的搜索 rollout 比这些基线少 29% 至 54%,但总成本不是全面更低:它比 WHALE 少用 GPU、多用 API token,比 HarnessForge 则相反。还有路由器多 LLM 投票和每 10 步验证集校准的开销。我的判断是,这套方法适合验证器可靠、失败归因可分、Harness 可复用的长期训练项目;只跑一个小 batch,建池和校准的固定成本很可能不划算。
我的判断:最值钱的是“把 Harness 当探索器”
这篇论文的贡献不是又发明了一种 PPO 变体。GRPO、剪辑目标、LLM 投票、演化搜索都已有成熟先例。真正新的组织方式是:保留多个局部修复,不急着合并;在基础策略彻底失败时,用它们改变轨迹生成分布;再用原 Harness 下的评测检查能力是否留下。
这比“策略与 Harness 联合进化”更容易解释,也更容易部署。线上可以继续使用原来的 \(H_0\),不必长期维护 20 个执行环境;有把握时再用 Rank-1 路由换额外收益。对工程团队来说,训练资源和部署复杂度被拆开了,这一点很实用。
但论文的“Generalizable”也有清楚边界。实验只覆盖 Qwen3.5 的 4B/9B、三个可自动验证的基准,以及一个共同执行框架。面对开放式写作、主观评价任务或跨完全不同工具协议的场景,二元奖励救援和兄弟池复用是否仍然成立,原文没有回答。救援组还会整组替换最初的 \(H_0\) 全失败样本,策略虽然保留生成上下文进行优化,训练分布与部署分布之间的差异仍值得做更细的敏感性实验。
兄弟池在训练期间固定也是一把双刃剑。它降低了联合演化的不稳定性,却可能在策略超过所有辅助变体后失去新鲜探索来源。论文把 Harness Scaling、跨策略复用和跨执行接口的状态交换留作未来方向,说明这套方法还处在“机制已被认真验证,系统边界仍待扩展”的阶段。
如果你正在做长程 Agent RL,我会优先借走三个做法:统计全零奖励组占了多少训练 token;把 scaffold 修复按失败根因保留成互补池,而不是只留全局最高分;评测时强制回到原始 scaffold,分开报告策略内化与推理路由收益。即使不完整复现 Harness-S,这三件事也足以改变一次训练实验的信息量。
参考资料
- Harness-S 原文:https://arxiv.org/abs/2611.04277
- Harness-S 代码:https://github.com/DeepExperience/Harness-S
- DAPO 项目与 Dynamic Sampling:https://dapo-sia.github.io/
- GRPO 出处 DeepSeekMath:https://arxiv.org/abs/2402.03300
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我