Drex:让模型只给决策,不写答案
线上系统让大模型做一个看似简单判断:这张工单该转人工,还是自动回复?你真正想要的往往只是 {人工: 0.82, 自动: 0.18},结果模型先写三段分析,再把字母 A 藏在结尾。为了这一句话,你要等几秒、付出输出 token 费用,还得写解析器兜底。更麻烦的是,把两个选项调换位置,答案有时也会跟着变。
Drex 盯上的就是这块不太性感、却很烧钱的环节:不把决策当文本生成,而把决策当概率读出。
核心摘要
Drex 是四个开放权重的决策模型,输入文档、记录或 Agent 上下文,以及用户当场给出的候选选项;模型不做自回归解码,直接返回各选项概率。系列包含 8B 的 DLM、9B 的 v1.5、35B 总参数且每 token 激活 3B 的 v2.0,以及支持图像的 27B Max。Max 在 Decision Index 0.4.1 公共套件拿到 67.52,高于 Jev 1.14.0 的 60.70;Decision Bench v4 准确率为 94.0%,比 Claude Opus 5.5 低 1.6 个点,但典型请求延迟从约 3.5 秒压到 183 毫秒。我的判断是:这不是一套凭空出现的新架构,真正有价值的是动态选项接口、训练配方、校准与顺序鲁棒性评估、推理优化被做成了一条完整工程链路。论文 51 页,实验比标题里的“Foundation”更值得细读。
论文信息
- 标题:Towards Foundation Decision Models: Drex
- 作者:Nischay Dhankhar、Alisher Amantay、Zhanibek Datbayev、Darkhan Akhmetov、Yash Shah、Nurmukhamed Ubaidullayev、Raman Saparkhan、Dos Baha、Abulhair Saparov
- 机构:Nace.AI Research Team
- 提交时间:2026 年 11 月 5 日,v1
- 论文:https://arxiv.org/abs/2611.07854
- 代码与权重入口:https://github.com/nace-ai/drex-decision-models
- 篇幅:51 页,13 张 Figure,25 张编号主表,附录另有扩展表格
决策模型到底省掉了什么
普通分类头的标签在训练时就固定了;Drex 面对的不是这种情况。一次请求里可以有三个退款动作,下一次可以有 150 个工具调用,标签集合由用户在推理时临时提供。
论文把请求写成状态 \(S\)、可选图像集合 \(\mathcal{I}\),以及一组问题 \(\{q_k\}\)。每个问题属于三种类型之一:
| 类型 | 用户给什么 | 模型返回什么 | 适合的工程场景 |
|---|---|---|---|
| choice | 最多 255 个命名选项 | 每个选项的概率及最高概率选项 | 路由、工具选择、动作筛选 |
| noul | 一个是否问题,可补充 yes/no 定义 | \(p(\mathrm{yes})\) | 审核、门控、充分性检查 |
| score | 有序的整数等级 | 各等级概率与期望分数 | 风险评级、质量打分、优先级 |
这里最容易被忽略的是“概率分布”三个字。只返回一个标签,应用只能机械执行;返回分布,应用才能把低置信度样本送人工、把高置信度样本自动执行,也能留下可审计记录。
与常见方案相比,差别很实际:
| 方案 | 动态选项 | 输出约束 | 推理代价 | 主要问题 |
|---|---|---|---|---|
| 提示聊天模型生成答案 | 支持 | 依赖提示与解析 | 一次生成,含输出 token | 格式漂移、延迟、口头置信度难校准 |
| 约束解码 | 支持 | 能保证生成合法字符串 | 逐 token 解码并反复归一化 | 共享前缀和长度会干扰整项概率 |
| 每个选项单独打分 | 支持 | 可归一化 | 每个选项一次前向 | 选项多时成本高 |
| 固定分类头 | 不支持 | 天然合法 | 一次前向 | 部署后不能更换标签集合 |
| Drex | 支持 | 输出空间天然限于所给选项 | 一次预填充与轻量读出 | 复杂推理仍弱于长思维链模型 |
说实话,这个接口比“又一个 27B 模型”更吸引我。它把模型从聊天机器人变成了可以直接接进业务状态机的组件。
四个模型,两种读出方式
Drex 并没有用一条架构路线硬推到底,而是保留了明确的成本梯度。
| 模型 | Backbone | 参数规模 | 决策头 | 输入 | 状态能否跨问题缓存 |
|---|---|---|---|---|---|
| DLM | Efficient-DLM-8B | 8B | 256 维 pointer | 文本 | 可以 |
| v1.5 | MiMo-V2.6-Distill-Qwen-9B | 9B | 256 维 pointer | 文本 | 可以 |
| v2.0 | Qwen3.6-35B-A3B | 总计 35B,激活 3B | 256 维 pointer | 文本 | 可以 |
| Max | Qwen3.8-27B | 27B,dense | 255 路 readout | 文本、图像 | 不可以 |
开放权重不等于统一的开源许可。DLM 随 backbone 使用 CC BY-NC 4.0;v1.5、v2.0 使用 Open RAIL-M;Max 使用修改版 Open RAIL-M;仓库代码则是 Apache-2.0。商用前得按具体模型核查许可,不能只看“open source”这个宣传标签。
Pointer:状态只读一次,问题各算各的
DLM、v1.5 和 v2.0 把状态与问题序列化。每个选项由 <opt> 和 </opt> 包住,问题末尾放 <decide>。问题可以读取状态和自身前缀,却不能读取其他问题,因此同一文档上新增一个问题,不会改变旧问题的答案。
Pointer head 的设计很轻巧:把 <decide> 的隐藏状态变成查询向量,把每个 </opt> 的隐藏状态变成键向量,再做缩放点积:
所有 released pointer checkpoint 都使用 \(d_p=256\)。v1.5 的 head 只有 2.1M 参数,v2.0 只有 1.0M,均不到 backbone 的 0.03%。真正的表示工作仍由 backbone 完成,head 只负责在运行时给出的候选集合上“指一下”。
这个结构还有两个工程好处。状态编码可以复用;full-attention 层的成本约为 \(O(|S|^2+\sum_k|b_k|(|S|+|b_k|))\),不必为每个问题重复整段状态。对“一份长合同,连续问二十个问题”这种负载,省下的不是小数目。
Max:牺牲缓存,换双向比较与视觉输入
Max 换了思路。每个问题独立编码,序列包含图像 token、状态、指令、带 A/B/C 编码的选项,以及末尾 <ans>。backbone 有 64 层,其中 48 层是 Gated DeltaNet,16 层是 full attention;每第四层为 full attention,并移除这些层的因果 mask。
于是,前文的证据、后文的选项、选项彼此之间都能在 full-attention 层双向交流。<ans> 的最终隐藏状态经过无偏置线性层 \(z=Wh\),只对当前问题的前 \(K\) 个选项 logit 做 softmax。head 约为 1.3M 参数,最多支持 255 个单 token 选项编码。
代价也很直接:状态表示会随问题改变,无法再跨问题共享完整缓存。我的第一反应是,这不就是把 multiple-choice prompting 的 A/B/C 读出训练化了吗?论文自己也很坦诚,Max 的注意力与 readout 设计沿用了公开的 pplx-decider。它真正的增量在训练、视觉阶段和系统评估,而不是发明了一个前所未见的输出头。
训练:重点不是“用了 RL”,而是反馈怎么调
Drex Max 的训练分为三段,配置相当具体:
| 阶段 | 可训练参数 | 数据量 | 步数与 batch | 峰值学习率 |
|---|---|---|---|---|
| 全参数 SFT | backbone 与 readout head | 115 万 records,290 万 questions | 9,000 步,256 | backbone 为 \(10^{-5}\),head 为 \(10^{-3}\) |
| 低秩 RLAF | 0.4B LoRA 与 readout head | 18 万 records,42 万 questions | 1,200 步,128 | adapter 为 \(5\times10^{-5}\),head 为 \(10^{-4}\) |
| 视觉 SFT | 0.6B 图像编码器与 projector | 9.5 万 records,14 万 questions | 1,500 步,64 | \(2\times10^{-5}\) |
三段最大序列长度均为 16,384 token,RLAF 的 LoRA rank/alpha 为 64/128。注意,训练长度与部署支持的最大上下文不是一回事;Max 部署最大上下文可到 262,144 token。
文本基础混合数据包含 1,150,460 条经过验证的记录。标签来自 gold answer、程序执行结果或游戏引擎,Decision Index 与 JevBench 的评测题被排除。最大两块是语言阅读和工具路由,最小的是游戏与空间任务。
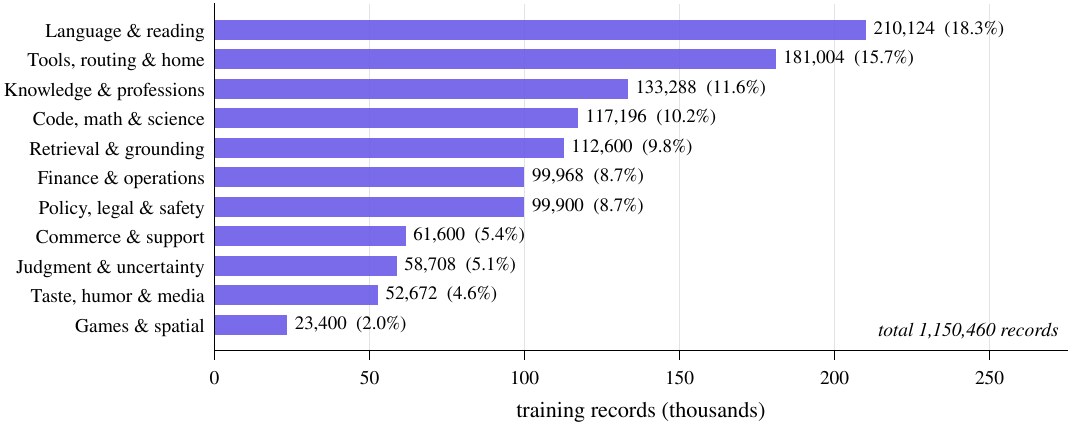
图4:语言与阅读占 18.3%,工具、路由与家居占 15.7%;数据并非单纯堆考试题,还覆盖财务、政策、安全、商业支持、判断不确定性和游戏。总量精确到 1,150,460 条。
SFT 不只学正确答案,还学“别被排列骗了”
监督损失里除了交叉熵,还有三项值得拆开看。
评分题加入平方 Cramér 距离,惩罚预测累积分布与正确等级之间的差异。它比把 4 分错成 0 分、错成 3 分一视同仁的普通交叉熵更符合有序尺度。
选项一致性损失要求选项随机排列后,映回原选项顺序的概率分布仍接近原分布;状态一致性损失则打乱句子或字段,让模型不要迷恋材料的表面排列。训练时还会随机插入 none 或干扰选项,避免模型在“没有合适答案”时硬选一个。
这些设计听着朴素,消融却证明它们确实在管顺序鲁棒性,而不是论文装饰。
RLAF:让验证结果修正 teacher,而不是盲目模仿 teacher
Pointer 模型的 RLAF 会先取 teacher 在选项上的分布,再用可验证答案调整,保留其余选项的不确定性。优化目标由 log score、spherical score 和评分题的 Cramér 项组成;实际可以直接对软目标求导。作者也试过 REINFORCE,但没有超过直接微分。
Max 使用带 KL 约束的版本。当前策略是 \(\pi_\theta\),冻结的 SFT 模型是 \(\pi_0\),judge 分布为 \(q^J\),奖励为 \(r(a)=\rho\mathbf{1}[a=y^\star]+\eta\log q_a^J\)。目标是:
其中 \(\beta=0.1\)、\(\eta=0.05\)、\(\rho=0.2\);没有可验证结果时 \(\rho=0\)。judge 不是更大的外部模型,而是同一个 Qwen3.8-27B 的生成式版本,以高推理强度先写长思维链,再读取选项编码概率。
这个设计挺聪明:单次前向的决策模型负责快,生成式分身负责提供另一种经过推理的意见,KL 则拉住模型别跑离 SFT 太远。
但有个坑作者没有回避。judge 与验证答案加权后,judge 理论上可能压过正确答案;如果二者经常一致,又可能把分布削得更尖,加剧过度自信。论文没有测量这种情况在训练里发生了多少次。坦白讲,这也是我读 RLAF 部分时最想继续追问的实验。
主结果:Max 强在哪里,又输掉了什么
Decision Index:公共与私有测试都领先,但不是全领域通吃
Decision Index 0.4.1 把不同任务的官方指标转成 chance-corrected skill,0 代表随机猜测水平,100 代表满分。公共部分有 37 个 benchmark;full score 还含同技能与新领域的私有测试。
| 模型 | 公共 Index | Full | 新领域私有分 | Raw |
|---|---|---|---|---|
| Drex Max | 67.52 | 66.60 | 56.45 | 75.40 |
| Drex v2.0 | 61.25 | 52.76 | 39.22 | 70.55 |
| Drex v1.5 | 58.08 | 45.78 | 30.82 | 68.08 |
| Jev 1.14.0 | 60.70 | 60.24 | 48.26 | 69.98 |
| GPT-6 Luna Decisions | 47.78 | 未报告 | 未报告 | 61.15 |
Max 的公共分比 full score 高 0.92 个点,v2.0 的公共分比 full score 高 8.49 个点,v1.5 则高 12.30 个点。新领域上的落差说明 Max 的泛化比小模型更稳,不只是把公开任务做熟。
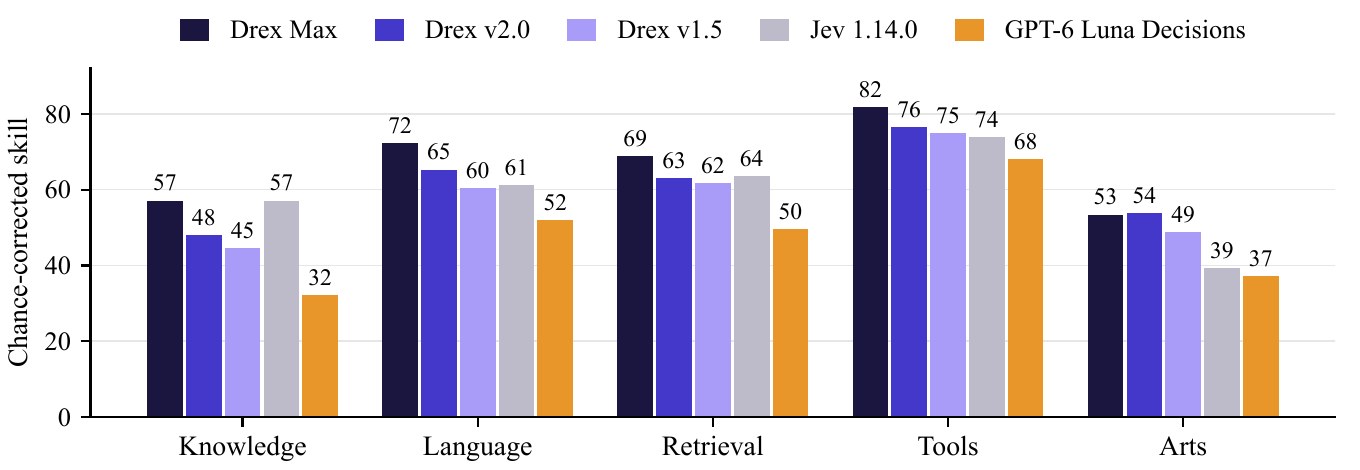
图5:Max 在 Language、Retrieval、Tools 领先,Knowledge 与 Jev 1.14 并列 57.1;Arts 中 v2.0 为 53.9,反而比 Max 的 53.4 高 0.5。
逐 benchmark 看更有意思。Max 在作者自测中赢了 v2.0 的 37 项中的 28 项,BBH 从 78.3 到 93.7,GSM8K 从 66.8 到 83.2,MuSR 从 59.6 到 70.3;但 POP909-CL 从 79.5 掉到 55.6,Habermas Machine 从 62.4 掉到 50.5。
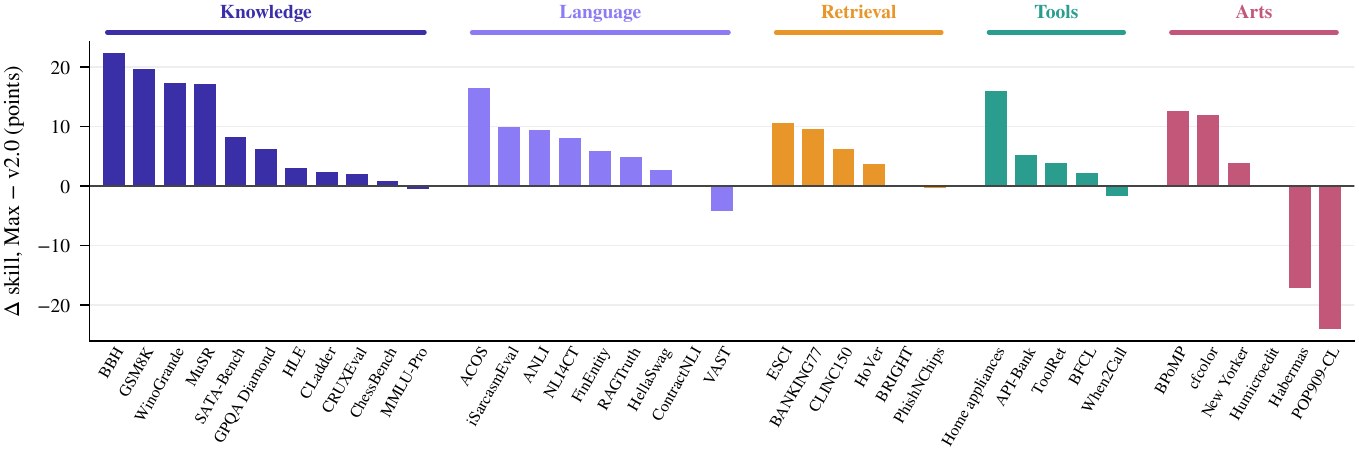
图11:增益分布在多个领域,不是单个异常 benchmark 撑起来的;右侧两个长负柱也很醒目,长结构化选项与偏好聚合仍是 Max 的短板。
看到这张图,我会对“更大加双向注意力就全面更好”保持警惕。Max 同时改了 backbone、head、mask 和训练数据,论文没有做同 backbone 下 pointer/readout、因果/非因果的完整交叉消融,所以不能把这些增益都记在某一个设计上。
Decision Bench v4:94.0% 的准确率,真正拉开差距的是图像
Decision Bench v4 有 1,071 个真实记录决策,覆盖 35 个任务和 11 个专业类别,其中 949 个纯文本、62 个文本加图像、60 个纯图像。
| 模型 | 总准确率 | 纯文本 | 纯图像 | ECE | 中位端到端时间 |
|---|---|---|---|---|---|
| Drex Max,图像编码器 | 94.0% | 93.4% | 98.3% | 1.40% | 0.66 秒 |
| Drex Max,只看图像文本描述 | 92.1% | 93.4% | 63.3% | 1.51% | 0.66 秒 |
| Drex v2.0 | 87.9% | 88.3% | 68.3% | 1.73% | 0.38 秒 |
| Jev 1.14 | 92.3% | 93.4% | 66.7% | 1.60% | 0.51 秒 |
| d3-turbo | 93.7% | 93.0% | 98.3% | 1.18% | 0.72 秒 |
| GPT-6 Sol | 94.7% | 94.0% | 100.0% | 不适用 | 2.05 秒 |
| Claude Opus 5.5 | 95.6% | 95.0% | 100.0% | 不适用 | 4.33 秒 |
Max 与 d3-turbo、GPT-6 Sol 的差异在统计上不显著;相对 Jev 的 1.8 点优势,McNemar 检验为 \(p=0.048\),但纯文本部分两者都是 93.4%,优势全部来自图像。Claude 高 1.6 点,\(p=0.046\)。作者做了很多检验且没有做多重比较校正,所以这种贴着 0.05 的结果只能当作提示,不宜写成确定胜负。
图像编码器把 60 道纯图像题从 63.3% 拉到 98.3%,提升 35 个点,而文本题保持 93.4%。不过 60 道题仍然很小,论文也把主要视觉证据放在另外 12,210 道视觉 benchmark 上,而不是只靠这 60 道下结论。
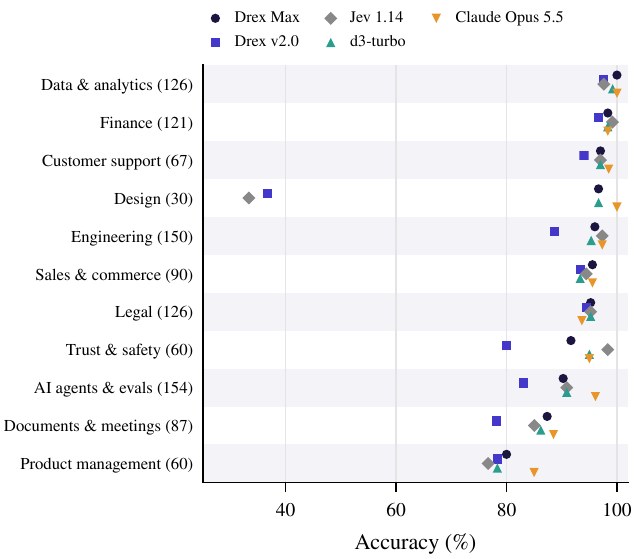
图12:Max 在 Data & analytics 达到 100%,Product management 只有 80.0%;Design 中 Max 为 96.7%,只看文本描述的版本仅 26.7%。Trust & safety 为 91.7%,落后 Jev 的 98.3%。
其他结果可以压缩成一张表:
| 评测 | Drex Max | 关键参照 | 我的读法 |
|---|---|---|---|
| JevBench-231 | 91.8% | d3-turbo 90.9%,Luna 91.3%;GPT-6 Sol 99.1% | 强决策模型彼此拉不开,和前沿聊天模型仍有差距 |
| DecideBench pair accuracy | 97.0% | Jev 96.0%,两个前沿聊天模型 98.5% | 对“只改一个细节就改答案”的 minimal pair 很敏感 |
| Artificial Analysis Decision Index | 63.7 | 前三名 65.3、65.0、64.7;Claude 79.0 | 独立榜单有竞争力,但 HLE-MC 只有 16.0 |
| OSWorld-Verified AUROC | 0.780 | 文本长度启发式 0.709,Jev 0.734 | 判断 Agent 轨迹是否成功,有实际路由价值 |
最刺眼的是闭卷知识。相同抽样下,Max 在 HLE 为 21%,GPT-6 Sol 为 39%,Claude 为 56%;GPQA Diamond 上三者分别为 55%、90%、89%。决策头能让知识以更快的方式读出,却不会凭空增加知识,也不能完全替代多步推理与工具使用。
校准与选项顺序:比总分更接近生产真相
总体 ECE 很漂亮,分领域后就没那么轻松
每个模型在约 23 万有 gold label 的 choice decisions 上评估,另一半约 11.5 万用于报告校准,温度在另一半拟合。
| 模型 | 准确率 | 发布温度下 ECE | 调温后 ECE | 调温后 NLL | 最自信 50% 的准确率 |
|---|---|---|---|---|---|
| Drex Max | 87.9% | 3.61% | 1.35% | 0.345 | 99.3% |
| Drex v2.0 | 86.0% | 1.37% | 0.79% | 0.381 | 98.9% |
| Drex v1.5 | 85.3% | 4.54% | 1.17% | 0.398 | 99.3% |
| GPT-6 Luna Decisions | 76.4% | 4.87% | 6.57% | 0.679 | 91.8% |
Max 发布温度只有 1.009,平均置信度 91.2%,高于 87.9% 的准确率;在 Decision Index 上拟合出的温度是 1.35,需要把分布压平。v2.0 则略欠自信,拟合温度 0.91,需要把分布削尖。
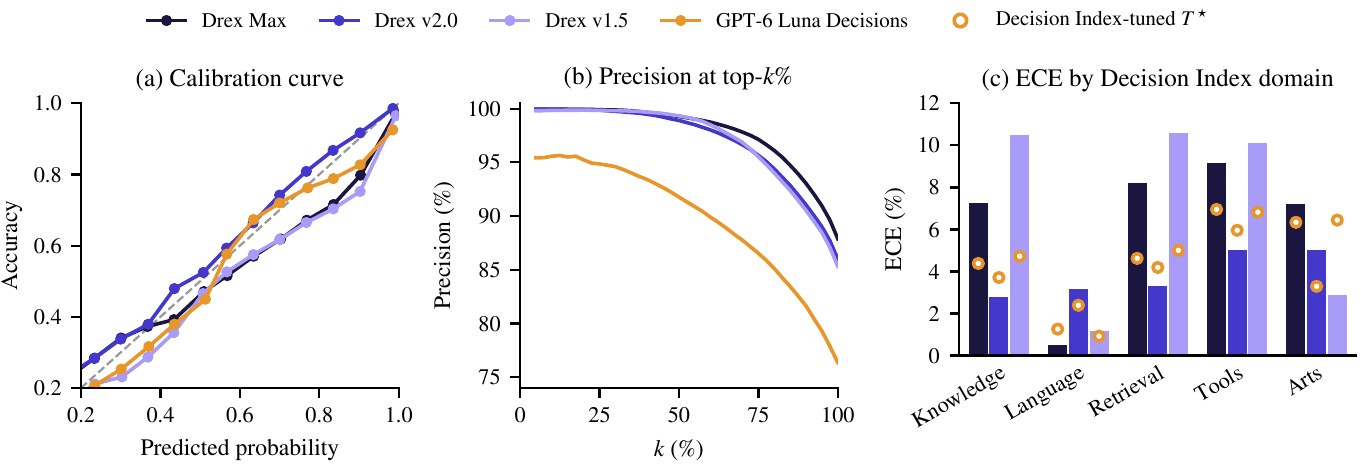
图7:左侧高置信区间里 Max 的预测概率高于实际准确率;中间只保留最自信的 50% 决策时,Max 与 v1.5 达到 99.3%;右侧显示聚合 ECE 会掩盖领域差异。
这里有个很值得带走的细节:Language 占 Max 决策量的 56%,ECE 只有 0.5%,把总分拉得很漂亮;其余四个领域的 ECE 却是 7.2%–9.2%。在 6–20 个选项的问题上,Max 的准确率为 71.7%,平均置信度 80.1%,ECE 达 8.4%。
所以,不能把论文里的一个温度原样搬进新业务。模型换了、任务分布换了、选项数量换了,阈值都应该重估。论文附录的文档搜索案例甚至给出三种模型的路由阈值:Max 为 0.80,v2.0 为 0.51,v1.5 为 0.25。把 Max 的 0.80 直接套给 v2.0,路由准确率会少 6 个点。
换选项顺序会翻答案,但主要发生在低置信度样本
作者从公共 Decision Index 抽样,让每个模型分别看到原顺序、逆序和固定随机排列。经过 API 失败与结构化选项排除后,剩 1,040 个请求、1,591 个决策,其中六个及以上选项的只有 173 个。
| 模型 | 原顺序准确率 | 随机排列准确率 | 随机排列 flip rate | 六选项及以上 flip rate |
|---|---|---|---|---|
| Drex Max | 83.6% | 83.4% | 4.3% | 13.3% |
| Drex v2.0 | 81.0% | 80.6% | 5.9% | 16.2% |
| Drex v1.5 | 78.8% | 79.6% | 5.3% | 15.6% |
| Jev 1.14 | 79.3% | 79.0% | 4.3% | 14.5% |
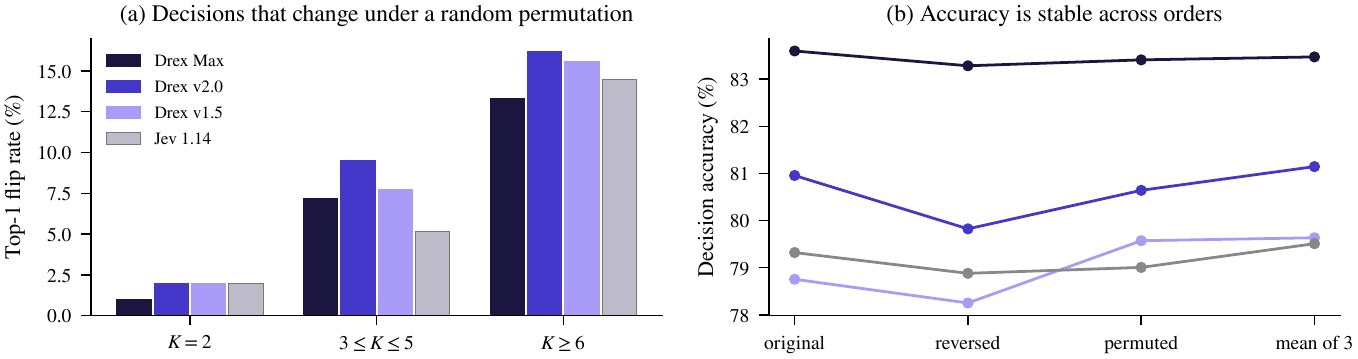
图8:二选项几乎不翻,六个及以上选项时各模型翻转率升到 13%–16%;右图表明不同顺序下准确率变化最多只有 1.2 个点,三次概率平均也没有带来明显准确率收益。
翻转样本的准确率只有 37.6%,稳定样本为 87.2%。这看起来像一种很好的拒答信号,但实验给出了更冷静的结论:按“顺序不稳定”拒答,与按同样数量的“最低置信度”拒答,剩余准确率分别为 87.2% 和 87.1%。多跑两种顺序只换来很少的额外信息,三次平均主要改善 log loss,而不是 top-1 准确率。
我个人挺喜欢这种不硬卖方法的结果。它省下了工程团队一轮“要不要做排列集成”的争论:预算紧就先做置信度路由,不必把请求放大三倍。
消融:哪些训练组件真的有用
Drex Max 的控制对比保持了 backbone、数据和训练日程一致:
| 变体 | Decision Index | 准确率 | ECE | 随机排列 flip rate |
|---|---|---|---|---|
| 仅 SFT | 64.9 | 86.5% | 4.4% | 5.3% |
| SFT → RLAF,不加一致性项 | 66.4 | 87.7% | 3.9% | 6.3% |
| SFT → RLAF,视觉训练前 | 66.9 | 88.0% | 3.5% | 4.2% |
| 发布版,再加视觉 SFT | 66.8 | 87.9% | 3.6% | 4.3% |
RLAF 带来 2.0 个 Index 点、1.5 个准确率点,ECE 降 0.9 个点,三项都有统计显著性。一致性项对准确率帮助不大,却把 flip rate 从 6.3% 压到 4.2%;在六选项及以上子集则从 17.8% 降到 13.0%,只是这个子集太小,差异未达显著。
视觉 SFT 前后,文本指标基本不动,图像题却从 63.3% 升到 98.3%。这至少说明视觉阶段没有把文本能力明显训坏。
v2.0 的七个 checkpoint 则讲了另一件事:大部分能力早在 SFT 就学到了,后续阶段只是修补特定能力。
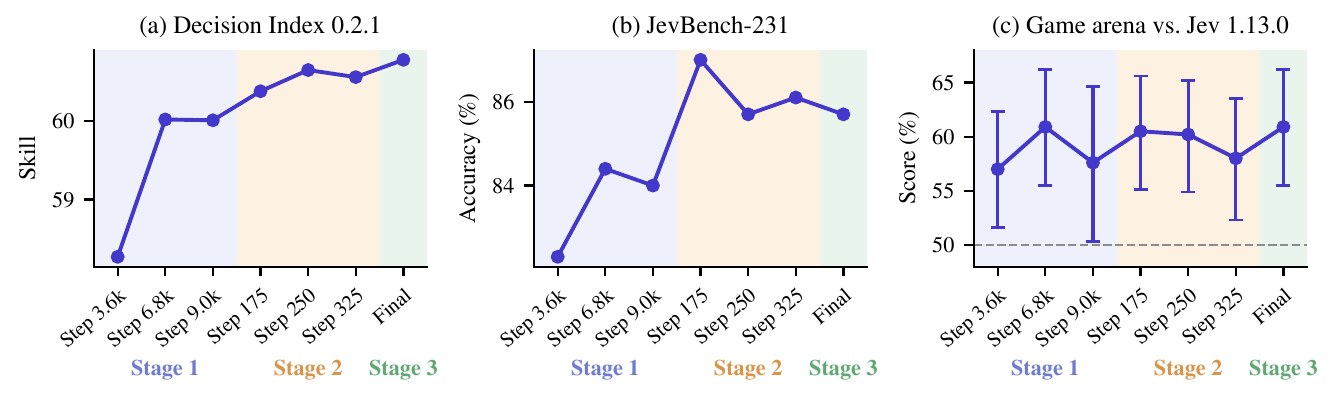
图9:Decision Index 从 SFT step 3.6k 的 58.27 升到 step 6.8k 的 60.02,随后趋于平台;specialization 主要改善 Retrieval 和 JevBench,RLAF 只再增加少量 Tools、Arts skill。游戏评测误差棒始终重叠。
这组轨迹是观察性比较,不是独立消融。stage 3 接在 stage 2 后面,无法回答“如果没有 specialization,RLAF 单独能做什么”。作者还测到同一模型重复评测的 Decision Index 波动可达 0.8 点,所以那些零点几的后段增益不该被过度解读。
推理优化:183 毫秒之外,还有长文档这笔账
论文报告的典型单请求中位延迟与 2026 年 10 月公开价格如下。测试机位于 Oregon,延迟包含 70–215 毫秒网络时间。
| 模型 | 中位延迟 | 每 1,000 次决策价格 |
|---|---|---|
| Drex Max | 183 毫秒 | $0.06 |
| Drex v2.0 | 151 毫秒 | $0.06 |
| Drex v1.5 | 145 毫秒 | $0.04 |
| Jev 1.14 | 196 毫秒 | $0.042 |
| GPT-6 Luna Decisions | 326 毫秒 | $0.10 |
| GPT-6 Sol | 约 2.0 秒 | $3.33 |
| Claude Opus 5.5 | 约 3.5 秒 | $10.17 |
Decision Bench 上 Max 的 0.66 秒与这里的 183 毫秒不是互相打架,它们来自不同请求分布与测量设置。引用延迟时必须保留上下文,不能只摘一个最小数字。
Pointer 模型真正漂亮的是缓存。v1.5 在 B200 上,对已经缓存的 114k–117k token 状态追加一个问题只需 21.6 毫秒,比处理一个全新的 2k token 状态还快,后者为 35.6 毫秒。
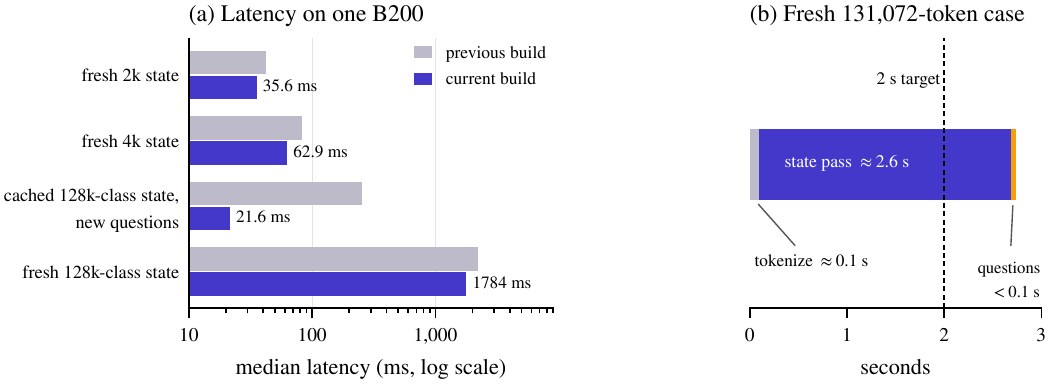
图13:左图横轴是对数刻度,缓存后新问题从 254 毫秒降到 21.6 毫秒;右图显示未缓存的 131,072 token 请求约需 2.7 秒,其中状态前向约 2.6 秒,仍超过 2 秒目标。
Shared prefill 在 16 个问题下带来 8k token 状态的 6–8 倍加速、32k token 状态的 11–12 倍加速;短请求则靠 CUDA Graphs 减少 kernel launch,1k token 单问题延迟约降三分之二。论文也没有只报喜:某个 grouped attention kernel 在合成测试里好看,真实记录上却慢约三倍;另一个 packed-prefill bug 能返回格式合法但答案错误的结果,只看延迟根本抓不到。
Max 因双向 full attention 无法共享状态缓存,所以“长文档、多问题”仍应选 pointer,而不是盲目上最大模型。这个取舍比模型排行榜更能指导部署。
我的判断:它像基础设施,但还不是通用决策者
我觉得这篇论文最值钱的地方有三块。
动态选项的统一接口很扎实。 choice、noul、score 共用一个概率输出协议,四种 backbone 都能接入,且输出空间由构造限制在用户选项内。这比让聊天模型“请只输出 JSON”更适合生产系统。
评估把准确率和可用性放在了一起。 校准、选择性准确率、选项顺序、配对统计、视觉输入、缓存与成本都被测了。特别是分领域校准和顺序翻转结果,不是只放一张总榜就结束。
训练与推理细节足够落地。 RLAF 的 judge、KL 与一致性损失有控制实验;shared prefill、CUDA Graphs、kernel 的负结果也写了。对于准备自研类似模型的人,这些信息比“Foundation”这个命名更有复用价值。
问题也同样清楚。
架构贡献有较多继承。System One 接口来自 Jev,pointer 模型建立在 Kev 的打包、block-causal mask、pointer head 与部分损失之上,Max 的 readout 和非因果注意力采用 pplx-decider 设计。Drex 的新意主要是 RLAF、Max 的训练与视觉阶段、系统评估和推理栈,不宜包装成从零发明决策模型。
“Foundation”也不能理解成通用推理已经解决。HLE、GPQA 上仍被前沿聊天模型甩开;Max 对长结构化选项会退步;多选项场景依旧过度自信并发生顺序翻转。它更像一个非常快的判别与路由层,而不是把 System 2 的思考彻底替代掉。
评估边界也要留着。私有测试由榜单维护者运行,作者没有逐题输出;公开数据集可能通过 teacher 蒸馏带来间接污染;视觉纯图像主对照只有 60 题;很多 \(p\) 值未做多重比较校正;Max 与 pointer 的架构差异没有完全解耦。作者把这些限制写出来了,这是加分项,但限制不会因此消失。
如果你在做 Agent 路由、工具调用、内容审核、检索充分性判断,我会认真试 Drex,尤其先测 v2.0 与 Max 在自己数据上的分任务校准,而不是直接照抄论文阈值。高置信度自动执行,低置信度转人工或交给长推理模型,记录请求、完整概率分布和模型版本;选项接近阈值时留出数值波动余量。长上下文多问题优先 pointer,图像与复杂单问题再考虑 Max。
Drex 没有让大模型变得更会“想”。它做的是一个同样重要、但常常被忽略的动作:让模型已经拥有的判断,以更稳定、更便宜、更方便程序消费的方式交出来。
参考资料
- Drex 论文,arXiv:2611.07854:https://arxiv.org/abs/2611.07854
- Drex 模型与推理代码:https://github.com/nace-ai/drex-decision-models
- Kev 开源决策模型栈:https://github.com/jaredpalmer/kev
- pplx-decider-v1.1-27b:https://huggingface.co/perplexity-ai/pplx-decider-v1.1-27b
- Decision Bench:https://github.com/atlanai/decision-bench
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我