工作型 Agent 的数据瓶颈,不只在轨迹数量:WorkFactory 先修复任务环境
你有没有遇到过这种合成任务:需求写得像模像样,参考资料也摆了一桌,真让模型去做,却发现报价单少了运费、预测表和折扣规则对不上,或者答案已经悄悄藏在输入文件里?
这时再强的教师模型也尴尬。它可能凭空补一个假设,可能跳过关键计算,也可能在死循环里消耗几十轮工具调用。把这些轨迹拿去 SFT,学生学到的不一定是专业能力,反而可能是怎么在一个坏掉的环境里“凑合交差”。
WorkFactory 盯上的正是这个不太光鲜、却很要命的环节:在收集教师轨迹之前,先把任务环境本身修好。
核心摘要:WorkFactory 把职业意图转成可执行的专业任务环境。它用职业体系、技能文档和真实交付物扩充意图,以 Semantic Workflow Graph 明确信息依赖及位置,再通过独立探测执行和保留工作内容的修复闭环清除环境缺陷。作者构建了覆盖 612 种职业的 112,686 个任务,训练出 4B、27B、35B-A3B 三档 WorkPilot;其中 35B-A3B 在 GDPval-AA v2.1 上从 879 升至 1565 Elo。我的判断是,这不是新的训练算法,而是一套很扎实的“数据环境工程”:真正值钱的是信息级规划与执行反馈的组合,但本地 Elo、探测式质检和每个尝试任务 11.656M token 的构造成本,都让结论需要带着边界来读。
论文信息
- 英文标题:WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training
- 作者:Ziyang Zeng, Tingyang Chen, Jia Deng, Qiyao Wang, Shuo Tang, Yike Yang, Tao Ren, Wayne Xin Zhao, Feng Chang, Jujie He, Chuan Hao, Ran Tao, Bryan Dai
- 署名机构:中国人民大学高瓴人工智能学院、北京大学、IQuest Research、浙江大学、深圳先进技术研究院、上海交通大学
- 版本:2026 年 10 月 27 日提交 v1;2026 年 11 月 3 日更新 v2
- 论文链接:https://arxiv.org/abs/2610.37161
- 项目与数据子集:https://github.com/IQuestLab/WorkFactory
坏任务比少任务更隐蔽
训练工作型 Agent,常见的做法是合成任务、让强模型执行、收集轨迹,再做监督微调。这个流水线看上去顺,实际有一个很容易被忽略的假设:任务环境真的支持那条专业工作流。
专业工作不是“读一个文件,写一句答案”。供应商选择可能要先从需求预测算出采购量,再映射到不同供应商的价格档位,结合运费、折扣和服务能力,再给出推荐。信息散在请求、PDF、表格和网页里,中间还隔着计算与判断。
只要其中一环断掉,教师轨迹就会被污染:
| 环境缺陷 | 教师可能出现的应对 | 学生可能学到的东西 |
|---|---|---|
| 缺少证据 | 自行补数字或假设 | 无依据地补全事实 |
| 跨文件冲突 | 任选一个版本继续算 | 忽略一致性检查 |
| 推导链断裂 | 绕开中间步骤 | 跳步、伪造推导 |
| 输入泄漏答案 | 直接照抄结果 | 走捷径而非完成工作 |
| 工具或文件不可用 | 反复尝试、提前终止 | 无效操作或过早放弃 |
说实话,我觉得这个问题比“数据有没有 10 万条”更基础。数量决定覆盖面,环境决定教师有没有机会展示目标能力。两者不能互相替代。
这条路线也并非凭空出现。NexForge 已从能力需求出发合成指令、文件和运行配置;Synthetic Computers 用文件依赖构造长期生产力环境;GraphForge 在真实文件上建立证据图,并把图同时用于任务与评分标准;WorkGenesis 则围绕真实材料合成上下文,用执行结果归因并修复任务和 rubric。
| 方法 | 意图或种子来源 | 工作流表达 | 材料来源 | 执行后的修复重点 |
|---|---|---|---|---|
| NexForge | 能力需求 | 任务指令与工作空间配置 | 检索或构造 | 摘要未强调保留原工作的独立审查 |
| Synthetic Computers | 用户画像 | 文件级依赖 | 合成计算机环境 | 重点在长期模拟,不是这类修复 |
| GraphForge | 职业知识 | 真实文件上的证据图 | 真实文件 | 修订任务陈述与 rubric |
| WorkGenesis | 职业知识与真实材料 | 未单独显式表示 | 真实材料加合成上下文 | 按 rubric 失败归因修复任务与 rubric |
| WorkFactory | 职业、技能、交付物三路混合 | 信息级 Semantic Workflow Graph | 真实检索加按需合成 | 修复输入环境,同时审查是否保留原工作 |
所以,WorkFactory 的定位很清楚:它不是第一次用图,也不是第一次做执行修复。更有辨识度的组合是从预期交付物反向规划信息支持,再把“不能把工作修没”单列为约束。GraphForge 更强调真实文件与可验证 rubric,WorkFactory 更强调混合材料下的信息可推导性,两者关注点并不相同。
WorkFactory:先画信息依赖,再让执行来挑错
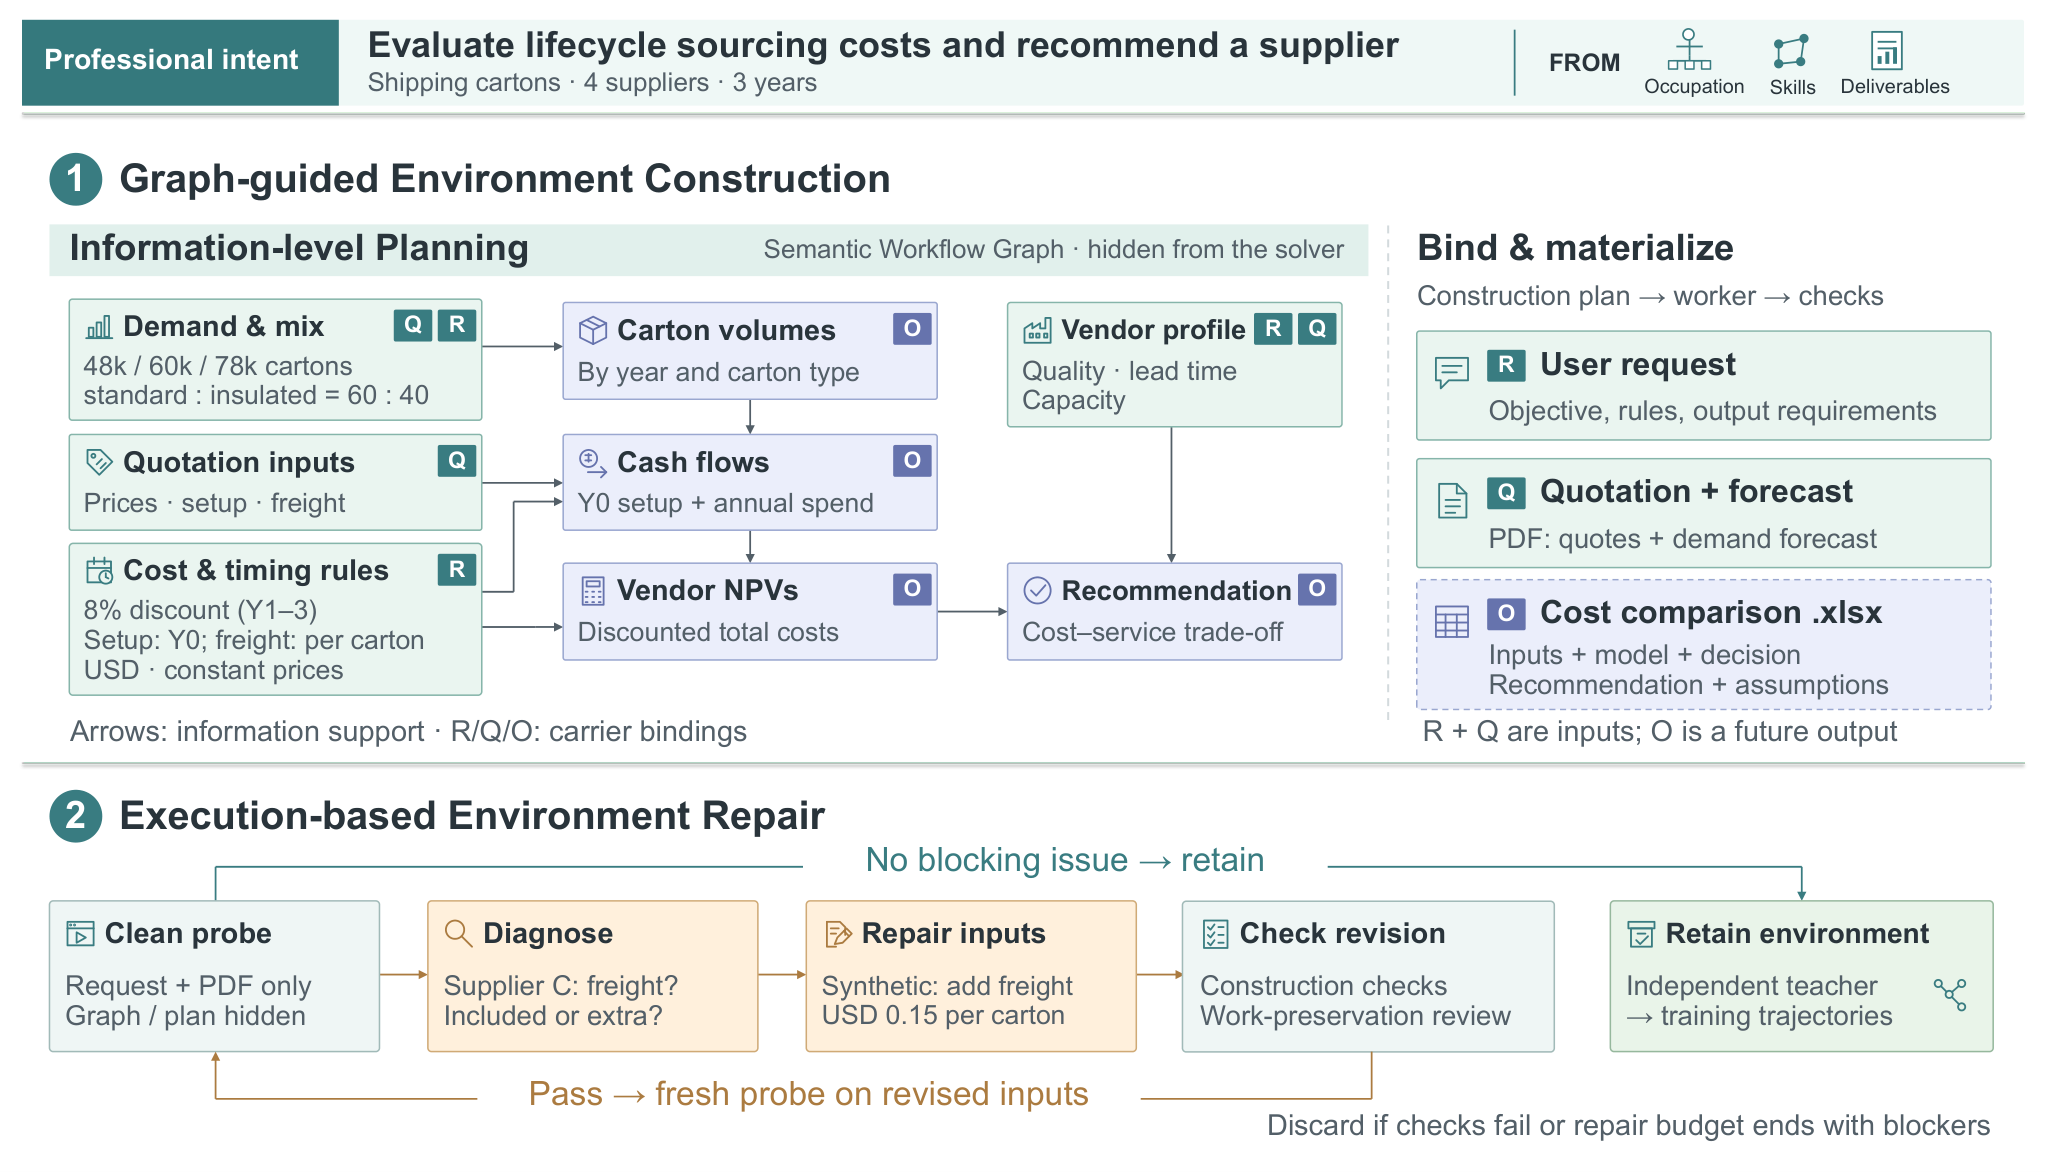
图 2:WorkFactory 用供应商采购例子串起完整流程。上半部分从需求、报价、成本规则和供应商画像建立信息支持关系,纸箱数量、现金流、NPV 与最终推荐留给求解者;右侧把信息绑定到用户请求、报价与预测 PDF、未来交付的成本比较表。下半部分由干净环境中的 probe 发现 Supplier C 运费定义缺失,修复器补入每箱 0.15 美元的条款,经过构造检查和工作保持审查后重新探测;通过保留、失败丢弃,合格环境才交给独立教师生成轨迹。
三条入口,避免任务只长得像某一类工作
WorkFactory 的意图库约 120K 条,来自三条互补路线。
职业驱动路线从公开职业层级扩展出细粒度角色,再检索职责、业务场景和触发事件。技能驱动路线读取公开技能文档,把“上游技能的输出能喂给下游技能”作为组合条件。交付物驱动路线则反着来:看到真实专业产物,推断它面向谁、如何使用、可能要经历什么生产过程,再反推出生成、更新、审查或比较这类产物的任务意图。
候选意图还要过一轮 LLM 审查,检查专业合理性、内部连贯性和现实可行性。这里没有特别花哨的算法,但三路来源互相补位:职业体系保证常见工作覆盖,技能组合带来操作链,真实交付物补上具体业务形态。
Semantic Workflow Graph:规划的是信息支持,不是标准答案
一句话解释这张图:它记录“要算出 B,必须先能从哪里得到 A”,却不替求解者把 B 算出来。
形式化定义为:
\(\mathcal{V}_{\mathrm{info}}\) 是信息单元,包括事实证据、规则定义、中间量、交付物和任务要求;\(\mathcal{V}_{\mathrm{carrier}}\) 是这些信息的载体,例如用户请求、参考文件、外部资源和未来交付物。\(\mathcal{E}_{\mathrm{info}}\) 描述关联、转换、证据与约束等支持关系,\(\mathcal{E}_{\mathrm{loc}}\) 则把信息绑定到具体位置,并区分求解者可见与构造过程内部的信息。
这个区分挺关键。图不是一份给 Agent 看的操作手册,也不规定唯一的工具调用顺序。它更像施工前的管线图:负责确认材料能支撑目标分析,同时把中间计算和最终判断留在任务里。
图随后被转成构造计划 \(\mathcal{P}=(u,\mathcal{A},\mathcal{D})\),分别对应具体请求 \(u\)、工件规格 \(\mathcal{A}\) 和无环构造依赖 \(\mathcal{D}\)。环境 worker 可以复用、改写检索到的真实文件,也可以补合成缺失材料。程序检查文件数量和类型,LLM 检查内容覆盖与请求一致性;初始构造失败后最多自动重试三次,仍失败就丢弃。
执行修复:既能补缺口,也不能顺手把答案塞进去
静态检查只能证明“文件看起来齐”,不能证明它们真能支持完整工作。WorkFactory 因而安排了一个独立 probe,只给它求解者可见的请求和资源,不让它看 Semantic Workflow Graph、构造计划、既往诊断或历史输出。
probe 会区分环境缺陷、求解器自身失误和合理开放选择。只有阻碍最低交付要求完成的 blocker 才触发修复。refiner 可以编辑请求和已有参考文件的内容,但不能改变文件数量、类型及依赖结构,也不更新最初的图。
每次修复还要过两道门:构造检查,以及独立的工作保持审查。后者对照原始意图与初始计划,检查核心目标、必要操作和实质交付要求是否还在。比如补上 Supplier C 的运费条款是合理修复;删掉 NPV 比较、直接提供供应商推荐,就把训练任务修成了另一种更简单的东西。
intent -> semantic graph -> construct workspace -> clean probe
                                      ^              |
                                      |       blocking defect?
                                      |              |
                            checked repair <---------+
                                      |
                              fresh probe in clean sandbox
                                      |
                         no blocker -> independent teacher
最多修复三轮。修完仍阻塞、构造检查失败或工作保持审查失败的任务都会被丢弃。5K 分析集里,69.58% 不需要修复,20.24% 修一轮,7.70% 修两轮,2.48% 到达三轮上限;其中 24 个任务仍有阻塞并被排除。
这个设计让我挺认可的一点,是 probe 和 teacher 都看不到内部图与历史诊断。否则教师可能借着构造者的“幕后答案”完成任务,得到一条看似漂亮、学生却无法复现的轨迹。
112,686 个任务,长轨迹只是表面特征
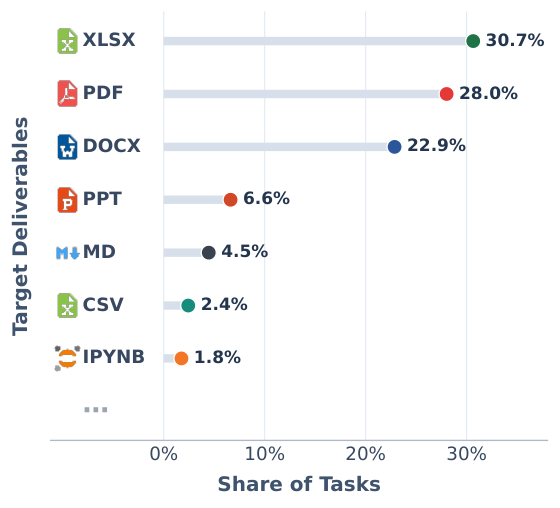
图 4:目标交付物以 XLSX、PDF、DOCX 为主,占比分别为 30.7%、28.0%、22.9%;PPT 为 6.6%,MD 为 4.5%,CSV 为 2.4%,IPYNB 为 1.8%。这不是单纯的文本问答语料,大部分任务要求模型产出可交付文件。
最终语料覆盖 23 个职业大类、612 种细粒度职业。每个任务平均提供 4.15 个参考文件,参考文件平均大小 1.56 MiB;出现至少 10 次的扩展名中,参考文件有 317 种,交付物有 53 种。
| 语料指标 | 数值 |
|---|---|
| 任务与环境数 | 112,686 |
| 细粒度职业数 | 612 |
| 平均参考文件数 / 任务 | 4.15 |
| 平均 assistant 轮数 / 教师轨迹 | 57.36 |
| 平均工具调用数 / 教师轨迹 | 62.95 |
| 平均总 token / 教师轨迹 | 136.18K |
教师是 GLM-5.3,94,077 个任务通过 GDPval-AA Stirrup 执行,18,609 个通过 Claude Code 执行。构造、规划、修复和 probe 则统一使用 DeepSeek-V4-Flash-0731。角色分开,减少同一个模型既搭题又答题造成的偏差。
轨迹筛选也分两层。全量先做重复推理、重复工具调用、缺失或过于单薄交付物的轻量过滤;初始轨迹长度排名前 5% 的任务再与 DeepSeek-V4-Flash-0731 的固定交付物做成对比较,教师未获胜时最多再尝试三次,仍不赢就连任务与工作空间一起排除。
训练采用 masked autoregressive SFT:
\(M_s\) 是被监督的 assistant token 位置。一个细节很实用:失败工具调用的 token 会从监督掩码里移除,但失败调用及其结果仍留在历史中,同一轮里的推理和普通文本继续参与训练。这样既不强迫学生模仿失败动作,又保留“看到失败后如何恢复”的上下文。
三种模型都训练 4 个 epoch,序列长度 256K,全局 batch 为 32 条 packed sequences,峰值学习率 \(3\times10^{-5}\),BF16 精度。视觉与 aligner 参数冻结,只更新语言模型。
主实验:三档模型都涨,但别把 Elo 当成准确率
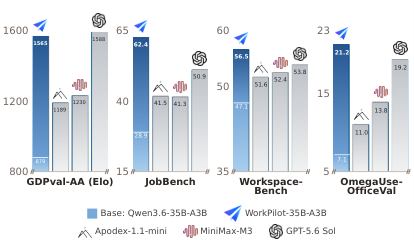
图 1:WorkPilot-35B-A3B 在 GDPval-AA、JobBench、Workspace-Bench、OmegaUse-OfficeVal 四个面板上均超过 Qwen3.6-35B-A3B 基座;图中还给出 Apodex-1.1-mini、MiniMax-M3 与 GPT-5.6 Sol 作为参照。四个面板量尺不同,不能横向比较数值大小。
| 模型 | GDPval-AA Elo | JobBench | Workspace-Bench | OmegaUse-OfficeVal |
|---|---|---|---|---|
| Qwen3.5-4B | 661 | 4.67 | 26.92 | 1.71 |
| WorkPilot-4B | 1375 | 39.87 | 51.30 | 11.77 |
| Qwen3.6-27B | 975 | 37.81 | 49.41 | 10.18 |
| WorkPilot-27B | 1612 | 63.05 | 59.18 | 26.61 |
| Qwen3.6-35B-A3B | 879 | 28.91 | 47.12 | 7.14 |
| WorkPilot-35B-A3B | 1565 | 62.35 | 56.53 | 21.18 |
35B-A3B 的四项提升分别是 686 Elo、33.44、9.41 和 14.04。27B 版本的 GDPval-AA 点估计为 1612,比 DeepSeek-V4.1-Flash 的官方 1600 高 12,比 GLM-5.3 的官方 1646 低 34。
看到这里要踩一下刹车。GDPval-AA 的 Elo 来自成对交付物比较,不是“做对了百分之多少”。更重要的是,带星号的是官方 v2.1 评分,WorkPilot 和若干基座的分数是作者用 GLM-5.3、DeepSeek-V4-Flash-0731 两个锚点本地估计后,再校准到官方量尺的。
本地评估覆盖 220 个任务、9 个行业、44 种职业,评委为 Gemini 3.1 Pro Preview。WorkPilot-35B-A3B 的 95% task-bootstrap 区间是 [1539, 1589],27B 是 [1594, 1631]。估计器在三个留出测试模型上的 MAE 为 19.00 Elo、RMSE 为 22.77 Elo,九成的验证与测试模型落在官方值上下 40 Elo 内。
这些验证让数字不是随口一报,但它们仍不是官方榜单成绩。区间也只覆盖任务抽样不确定性,不含评委、锚点和校准方法本身的误差。我的读法是:相对基座的跃升很有说服力,和前沿模型之间十几到几十点的距离则别抠得太细。
数据规模实验:先学会坚持做完,再学会少绕路
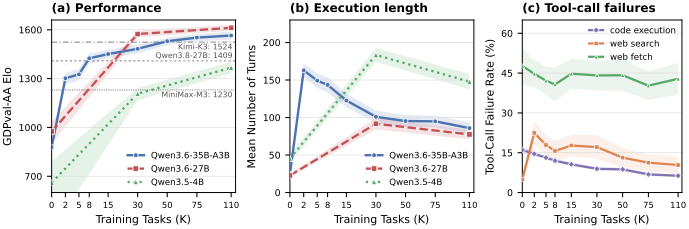
图 5:左图显示三种模型的 GDPval-AA Elo 随训练任务数增加而上升并逐渐变平;中图显示平均执行轮数在小数据阶段快速升高,随后下降;右图显示 35B-A3B 的代码执行和网页搜索失败率总体下降,而网页抓取失败率一直处在约 40%–48% 的高位。横轴使用平方根尺度,阴影为 95% 置信区间。
35B-A3B 从基座到 2K、5K、8K、15K、30K、50K、75K、110K 任务做了嵌套子集扫描,27B 和 4B 额外评估 30K 与 110K 两个点。
最值得记住的不是一条平滑曲线,而是收益分配极不均匀。35B-A3B 从 879 到 1565 的总提升中,前 5K 任务贡献 447 Elo;从 75K 加到 110K,只多 13 Elo。到 30K 时,35B-A3B 和 27B 已分别拿到基座至 110K 总增益的 88% 和 94%。4B 在 30K 时也拿到 546 Elo 增益,早期数据效率很高。
执行长度的变化更有意思。35B-A3B 基座平均 24.87 轮,2K 数据训练后冲到 162.88 轮,110K 时回落到 85.90 轮;触及 250 轮上限的轨迹比例从 2K 时的 21.9% 降至 110K 时的 2.7%,同期 Elo 仍在涨。
我的直觉解释是,小数据先让模型摆脱“稍微复杂就提前交卷”,所以轨迹变长;更多数据再让它学会组织步骤、减少无效尝试,轨迹随之收缩。不过论文没有直接验证这个认知机制,这只是一个与曲线相容的解释,不能当成已证实结论。
工具行为也在变。代码执行失败率从基座 16.0% 降到 110K 的 6.3%;网页搜索在 2K 时升至 22.4%,随后降到 10.4%。网页抓取始终约 40%–48%,说明光靠更多教师轨迹并不能消除外部访问与工具链瓶颈。
消融:规划擅长补推导,修复擅长抓落地事故
这组实验把同一个 Qwen3.6-35B-A3B 分别放到三种 5K 任务条件上训练:工件级规划、加入 Semantic Workflow Graph、再加入执行修复。缺陷由共同 probe 的报告归类,类别允许重叠。
| 缺陷或下游指标 | 工件级规划 | 加语义工作流图 | 再加执行修复 |
|---|---|---|---|
| 缺失证据 | 9.62% | 3.64% | 2.02% |
| 跨文件不一致 | 32.82% | 25.74% | 4.84% |
| 推导链断裂 | 24.86% | 6.86% | 3.26% |
| 请求欠指定 | 7.22% | 0.62% | 0.28% |
| 泄漏或捷径 | 1.92% | 3.36% | 0.84% |
| 执行可行性问题 | 10.80% | 6.64% | 0.48% |
| 单文件自相矛盾 | 3.28% | 4.46% | 1.74% |
| 事实真实性错误 | 4.52% | 2.56% | 1.30% |
| GDPval-AA Elo | 1245 | 1293 | 1326 |
语义图带来的最大改善是推导链断裂,下降 18.00 个百分点;下游 Elo 增加 48。执行修复则把跨文件不一致从 25.74% 拉到 4.84%,Elo 再增 33,累计增益 81。
但我更想强调两个反向数字:只加语义图时,泄漏或捷径从 1.92% 升到 3.36%,单文件自相矛盾从 3.28% 升到 4.46%。作者推测,更显式的依赖可能诱导构造器把本该由求解者推导的信息暴露出来,更密集的约束也更难保持一致。
这就是执行修复存在的理由。规划能减少结构性缺口,却不能保证材料落盘后仍然忠实于规划。 这个反例比一句“图规划很有用”有信息量得多。
评估口径也有边界。前两种条件使用初始 probe 报告,修复条件使用最终报告,并包含后来因未解阻塞而丢弃的任务;缺陷标签来自对执行报告的事后归类,不是独立人工金标。因此它很适合证明这条闭环的工程作用,但不应被读成对所有真实环境缺陷的精确测量。
同一批任务,换个教师就差了 235 Elo
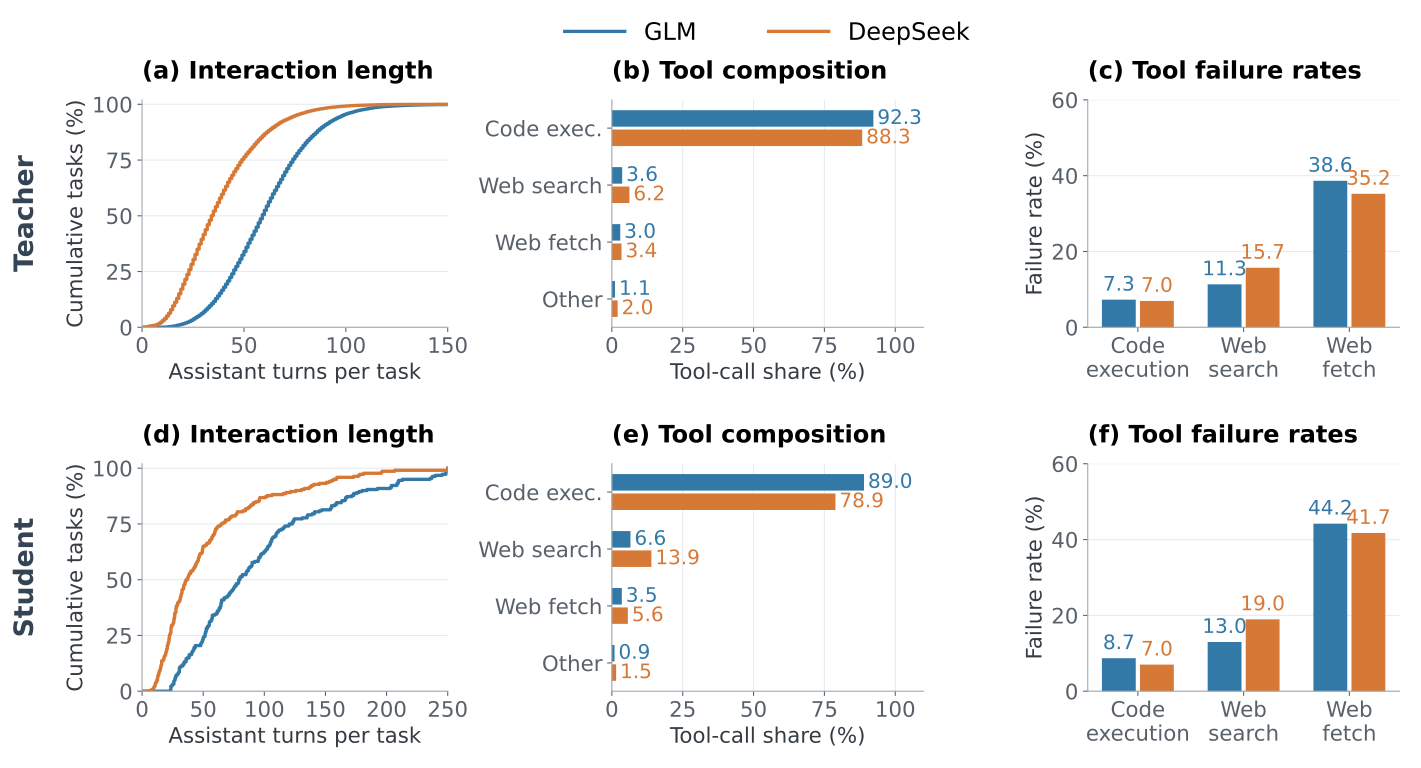
图 8:上排是教师行为,下排是对应学生行为。GLM-5.3 教师与学生的交互轮数分布都比 DeepSeek 组更长;代码执行在两类教师调用中占 92.3% 和 88.3%,在学生中占 89.0% 和 78.9%。两组网页抓取失败率都远高于代码执行,学生端分别为 44.2% 与 41.7%。
作者在同一套 30K 任务上,分别用 GLM-5.3 和 DeepSeek-V4-Flash-0731 生成轨迹,再用相同配置训练同一个 35B-A3B 基座。
| 指标 | GLM-5.3 轨迹 | DeepSeek-V4-Flash-0731 轨迹 |
|---|---|---|
| 教师平均 assistant 轮数 | 60.69 | 37.97 |
| 教师平均工具调用数 | 65.76 | 44.92 |
| 学生 GDPval-AA Elo | 1483 | 1248 |
| 学生平均 assistant 轮数 | 99.81 | 53.81 |
| 学生平均工具调用数 | 110.40 | 65.95 |
| 学生平均推理 token | 79,076 | 61,723 |
两个学生都超过 879 Elo 的基座,说明收益并非只能依附 GLM-5.3。可同一批任务、同一个学生,教师不同就差 235 Elo,任务覆盖率显然不是故事的全部。
更妙的是行为也跟着迁移。GLM 教师更爱多轮交互和调用工具,其学生也表现出同样倾向;两组教师的平均推理 token 却接近,分别为 48,127 和 48,368。坦白讲,这比单看分数更有启发:选教师不只是选“谁最聪明”,还是在选学生将模仿的工作方式。
成本图很漂亮,但价格假设比图线更值得看
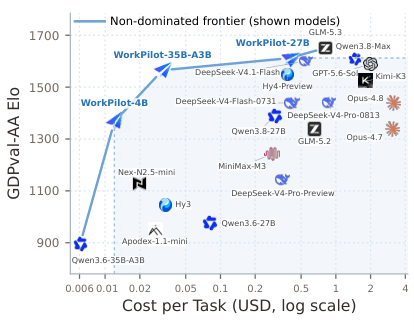
图 6:横轴是每任务推理成本的对数尺度,纵轴是 GDPval-AA Elo。三个 WorkPilot 都落在图中所示模型的非支配前沿上;4B、35B-A3B、27B 的估计成本分别约为 0.012、0.031、0.396 美元。
这里有个很容易看漏的细节:27B 的估计成本反而远高于 35B-A3B,不是模型必然更耗算力,而是价格映射造成的。附录把 WorkPilot-27B 映射到 Qwen3.8-27B 的 Wafer 价格,输出为每百万 token 2.30 美元;35B-A3B 则映射到 Nex-N2.5-mini 的同尺寸价格,输出为 0.10 美元。仅输出单价就相差 23 倍。
所以这张图更适合读成“在作者统一价格代理与缓存假设下的服务成本比较”,不能直接推导硬件效率或部署成本。
还有一笔账没进这张图:任务构造。每个尝试任务在信息规划、材料合成、执行修复三个阶段平均消耗 11.656M token,其中输入 11.448M、输出 0.208M;规划本身占 4.737M,执行与修复占 3.644M。对 110K 级生产规模来说,质量控制不是免费附加项,而是主要成本之一。论文没有给出不同管线在相同 token 预算下的成本收益对照,这是我读完仍觉得缺的一块。
我的判断:值得抄的是质检闭环,不是盲目复制数据规模
我觉得 WorkFactory 最值钱的地方有三层。
任务环境被当成一等训练对象。 很多合成数据流水线把重心放在指令多样性和教师强弱上,WorkFactory 则追问材料能否支撑目标推导。这个问题在真实工程里并不伪,尤其是多文件财务分析、采购、审计和办公交付场景。
“可执行”与“保留工作”被拆成两个检查。 只追求可执行,最简单的办法往往是降低难度、删掉步骤或泄漏答案。工作保持审查把这条捷径堵住,虽然审查仍由 LLM 完成、并非绝对可靠,但设计方向是对的。
实验不只给最终模型,还把规模、缺陷、教师和成本串起来。 尤其是语义图导致泄漏略升、轨迹先变长再缩短、教师行为传到学生,这些结果让文章比单纯发布一个大数据集更有可读性。
问题也同样清楚。教师 GLM-5.3 只支持文本,训练与求解评估都没有直接测试视觉证据学习;评委可以看渲染文档,却不能弥补学生端的文本输入边界。训练仍停留在教师轨迹 SFT,没有利用这些环境做强化学习。语料公开的是子集,外部研究者暂时不能凭论文完整复现 112,686 任务的生产与筛选。
如果要把这套思想搬进自己的 Agent 数据管线,我会优先做三件事:为每个交付物维护信息依赖与可见位置;让独立求解者在干净沙箱里先跑一遍,并把环境缺陷和模型失误分开记录;给修复器加一条硬性审查,确认它没有删掉必要推导或泄漏答案。数据预算则别直接照抄 110K,先用小规模扫描找收益拐点,再把钱花在更强教师或更难任务上。
WorkFactory 没有发明新的学习范式。它做的是更朴素的事:把“这道题到底能不能做、做完是否还真的在训练目标能力”变成生产流程里的显式检查。对工作型 Agent 来说,这种朴素,可能正好是最缺的那块工程基础。
参考资料
- WorkFactory,arXiv:2610.37161:https://arxiv.org/abs/2610.37161
- GraphForge,arXiv:2609.38923:https://arxiv.org/abs/2609.38923
- WorkGenesis,arXiv:2609.39325:https://arxiv.org/abs/2609.39325
- NexForge,arXiv:2607.14186:https://arxiv.org/abs/2607.14186
- Synthetic Computers at Scale,arXiv:2604.28181:https://arxiv.org/abs/2604.28181
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我