路由器不是万能大脑:Route Anything 如何把 5.4 分上限变成 8.82 倍效率
一个通用 AI 系统今天可能要答数学题,明天要生成视频,后天还得操控机械臂。最省事的部署方式,是给每一类任务固定一个“最强模型”;但账单会很诚实:大量简单请求也在为旗舰能力付费。反过来,全切到便宜模型,质量又可能瞬间塌方。
真正难的不是多接几个模型,而是知道这一次该叫谁。
Route Anything 把这个问题从语言模型路由扩展到了图像、视频、语音、代码智能体和机器人策略。它最值得看的地方,不是又做了一个分类器,而是把“理论上最多能赢多少”“学习路由器实际拿到多少”“便宜多少才算够用”放进了同一套账本。
核心摘要:这项工作构建了覆盖 25 个基准、452 种候选配置和 374,401 次评分的全模态轨迹矩阵。逐输入 oracle 比每个基准上的最佳固定候选高 5.38 分,说明候选之间确有互补;但学习型路由器在 16 个基准上只领先 0.30 分,拿到 oracle 差距的 6%。更有分量的结果来自成本侧:四个测试环境中的质量成本效率平均达到参考策略的 8.82 倍。我的判断是,它不是“一个路由器统治所有模态”的故事,而是一份很扎实的路由评测与决策框架——上限很诱人,真正可靠的收益仍是省钱。
论文信息
- 标题:Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
- 作者:Pengfei Zhou, Yixing Ma, Hexin Wang, Weidong Tang, Zhenglin Wan, Wangbo Zhao, Yang You
- 提交日期:2026 年 11 月 3 日
- 机构:arXiv 摘要页未列出
- 链接:https://arxiv.org/abs/2611.05275
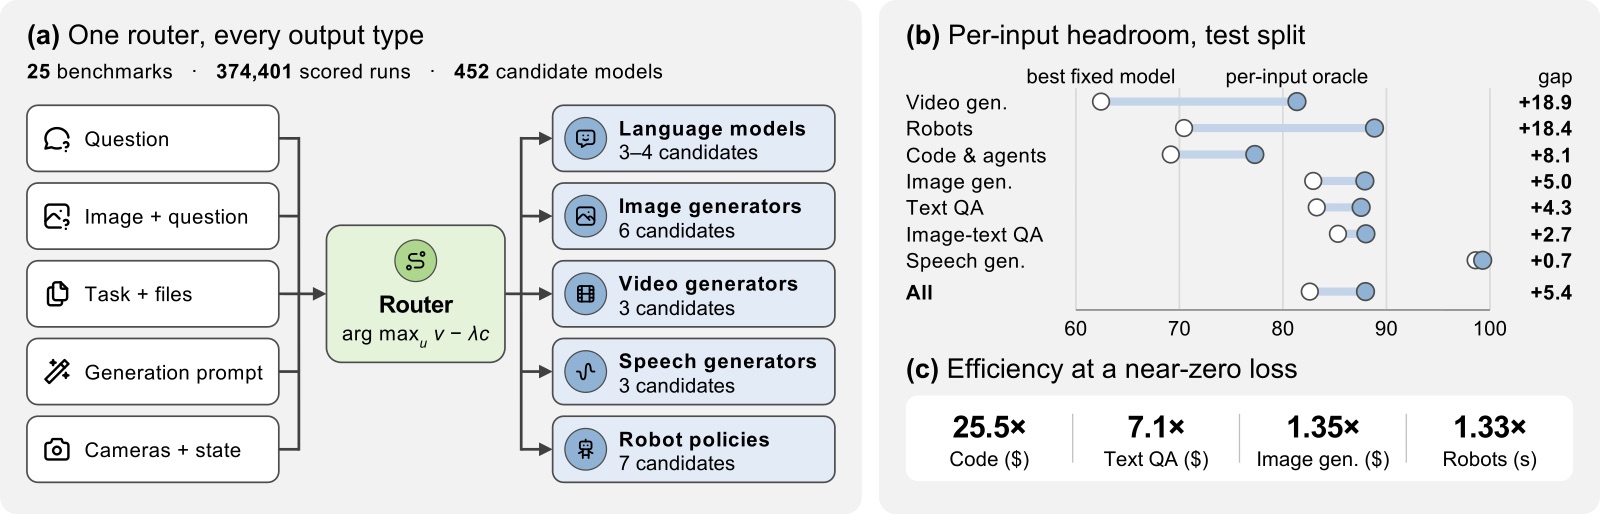
图 1:左侧把问题、图文输入、带文件的任务、生成提示和机器人观测交给同一个路由框架,候选涵盖语言模型、三类生成器和机器人策略。右上比较最佳固定候选与逐输入 oracle:视频生成和机器人分别有约 18.9、18.4 分空间,语音只有 0.7 分。右下给出代码 25.5 倍、文本问答 7.1 倍、图像生成 1.35 倍、机器人 1.33 倍的效率比。注意,这些数字来自不同评测面板,不能当成同一次实验里的统一提升。
一张轨迹矩阵,先把“谁擅长什么”量出来
讨论路由之前,得有一份不太舒服的事实:如果所有候选在同一批输入上的表现几乎一样,再聪明的路由器也无事可做;如果每个候选都有得分但从没跑过相同输入,路由收益又很容易被数据统计口径伪造出来。
Route Anything 因而让同一候选池里的模型、工具或策略跑相同输入,再用各基准自己的指标评分,统一缩放到 0–100。整个矩阵包含 103,307 个任务、374,401 次有效评分和 452 种候选配置。这里的“配置”不只换模型名,也包括执行框架与推理 effort,所以它不是一张简单的模型排行榜。
| 任务组 | 基准数 | 候选规模 | 典型评测内容 |
|---|---|---|---|
| 文本问答 | 7 | 3–4 | MMLU-Pro、GPQA、HLE 等 |
| 图文问答 | 3 | 3 | MMMU-Pro、MMMU、VLM-ExecRouterBench |
| 图像生成 | 5 | 4–6 | GenEval2、OneIG、WISE 等 |
| 视频生成 | 1 | 3 | VBench-2.0 |
| 语音生成 | 2 | 3 | Seed-TTS 英文与中文 |
| 代码与办公智能体 | 5 | 4 | Terminal-Bench、AutomationBench、GDPval 等 |
| 机器人操作 | 1 | 7 | RoboTwin 2.0 |
数据按来源组做 70/10/20 的训练、开发、测试切分,避免同源重复题跨集合。机器人更严格:测试的 2,000 个场景来自训练中没见过的 10 个任务。这一点我挺认可,路由若只记住题型,放到新任务上很容易露馅。
不过,矩阵里的 25 个基准并没有全部进入每张主表。计算 oracle 上限时,只使用所有候选均有分数的 19,814 个测试输入,覆盖 24 个基准;SciCode 因后续步骤依赖各模型自己此前生成的代码而被排除。学习型路由器的跨模态主结果则落在 16 个基准、3,444 个输入上。读后面的数字时,这些边界比小数点更重要。
路由的统一目标:价值减去计价成本
先给一个直观版本:候选不是按“平均分最高”来选,而是按“它多带来的质量,值不值多付的钱”来选。
输入为 \(x\),路由器能看到的状态是 \(s=\sigma(x)\)。状态可以很粗,比如只知道这是哪个基准;也可以很细,比如看到完整提示、三张相机图像和机器人状态。候选 \(u\) 在该状态下的期望质量为 \(v(s,u)\),期望资源消耗为 \(c(s,u)\)。资源价格记作 \(\lambda\),最优决策满足:
\(\lambda=0\) 时只看质量;价格越高,昂贵候选越难入选。完整执行计划也算候选,因此“先跑便宜模型,验证失败后升级”的级联策略,不必另起一套理论。
这套框架还回答了一个经常被混淆的问题:效率变高,不代表质量够用。定义路由效率 \(\eta=\mathbb{E}[V_g]/\mathbb{E}[D_g]\),参考策略效率为 \(\eta_B\)。若质量变化为 \(Q\),节省成本为 \(\mathcal{S}\),则:
效率提升要求 \(Q+\eta_B\mathcal{S}>0\),质量底线则另算:\(Q\geq-\epsilon\)。两条都得要。一个正确率只有 15%、成本只有参考十分之一的策略,效率可以达到参考的 1.5 倍,但质量已经掉了 85 分。单看“性价比”会把这个灾难遮住。
信息阶梯:看得越细,上限越高
如果状态 \(\sigma_1\) 是 \(\sigma_2\) 的粗粒度压缩,那么最优可达收益满足从粗到细的单调关系:每个基准固定一个候选,不超过按能力类型选择;按类型选择,又不超过看到完整输入后再选。
最右端还有一个逐输入 oracle,它直接知道每次实际结果。这个上限包含结果噪声,不等于可实现收益。论文里的 AA-LCR 例子很直观:每题跑三次时,单次记录上的 oracle 比固定候选高 2.4 分;先对三次结果求平均,这个差距就消失了。老实说,这类检查很有必要,否则“路由上限”很容易变成对随机性的事后挑选。
5.38 分空间是真的,但大部分藏在类型内部
逐输入 oracle 的结果如下。Fixed 是在训练输入上为每个基准选出的最佳固定候选,Best fixed in hindsight 则是在这些测试输入上事后重选;Oracle 为每个输入挑选实际表现最好的候选。
| 任务组 | 测试输入 | Fixed | 事后最佳固定 | Oracle | Oracle 差距 |
|---|---|---|---|---|---|
| 文本问答 | 9,482 | 83.27 | 83.27 | 87.56 | 4.28 |
| 图文问答 | 5,708 | 85.32 | 85.32 | 88.02 | 2.70 |
| 图像生成 | 1,515 | 82.93 | 82.99 | 87.92 | 4.99 |
| 视频生成 | 158 | 62.43 | 62.43 | 81.36 | 18.93 |
| 语音生成 | 608 | 98.62 | 98.63 | 99.30 | 0.68 |
| 代码与办公智能体 | 343 | 69.17 | 69.78 | 77.29 | 8.11 |
| 机器人操作 | 2,000 | 70.45 | 70.45 | 88.85 | 18.40 |
| 全部 24 个基准 | 19,814 | 82.60 | 82.62 | 87.98 | 5.38 |
这里的 All 是按输入汇集后的分数,不是七行差距的算术平均。视频只有 158 个输入,却有 18.93 分差距;语音已接近满分,路由自然没多少油水。
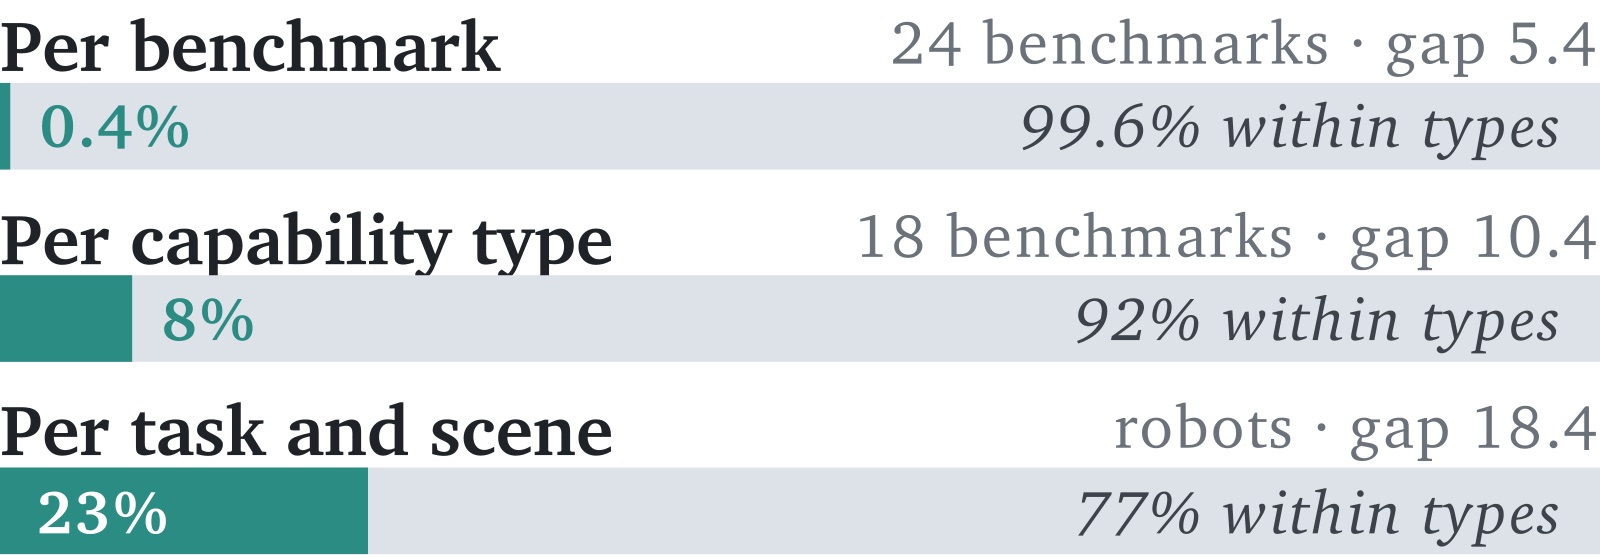
图 2:仅在基准层面事后换候选,5.4 分空间只能解释 0.4%;在 18 个基准上按能力叶节点选择,10.4 分空间只拿到 8%;机器人按任务和场景条件选择,则拿到 18.4 分空间的 23%。大头仍在类型内部,需要针对具体输入或场景做判断。
这个结果让我对“给任务贴标签,再查一张模型映射表”的方案谨慎了不少。规则能力树有 107 个叶子,训练后类型分类器准确率也有 86–89%,但类型内部哪个候选最好,仍然随输入变化。标签有用,只是远没有想象中够用。
学习型路由器:跨 16 个基准只前进 0.30 分
学习方案以 Qwen3.5-4B 为骨干。跨模态实验用能力树分类器预测叶节点,再从训练集拟合的“类型到候选”表中选模型;机器人实验则让结果路由器读取指令、三张 240×320 相机帧和机器人状态,分别预测七个策略的成功概率。
| 任务组 | 输入数 | Fixed | Router | Oracle | 路由增益 | 占 oracle 空间 |
|---|---|---|---|---|---|---|
| 文本问答,3 个基准 | 588 | 65.14 | 64.97 | 71.43 | -0.17 | -3% |
| 代码与办公智能体,5 个 | 519 | 69.24 | 70.01 | 74.78 | +0.77 | 14% |
| 图像生成,5 个 | 1,559 | 82.96 | 83.21 | 87.92 | +0.25 | 5% |
| 视频生成,1 个 | 161 | 62.17 | 64.28 | 80.22 | +2.12 | 12% |
| 语音生成,2 个 | 617 | 98.63 | 98.63 | 99.30 | 0.00 | 0% |
| 全部 16 个基准 | 3,444 | 79.68 | 79.98 | 84.80 | +0.30 | 6% |
| 机器人结果路由器 | 2,000 | 70.45 | 71.55 | 88.85 | +1.10 | 6% |
说实话,0.30 分不算漂亮。路由器在 16 个基准中的 10 个上,与固定候选的差异不超过 0.01 分;主要收益来自 Terminal-Bench 的 8.3 分和 VBench-2.0 的 2.1 分,而 AA-LCR 掉了 2.4 分。 Terminal-Bench 在这里只有 36 个测试输入,所以那 8.3 分很醒目,也很需要更大的样本复核。
图像生成的额外研究更冷静:31 种路由设计、124 种配置里,没有一个以置信区间高于零的方式击败固定生成器,44 个配置还显著更差。未训练、直接让 Qwen3.5-4B 自己挑候选,则低了 1.15 分。把通用模型提示成“路由专家”,并不会自动获得路由能力。
机器人是更有意思的正例
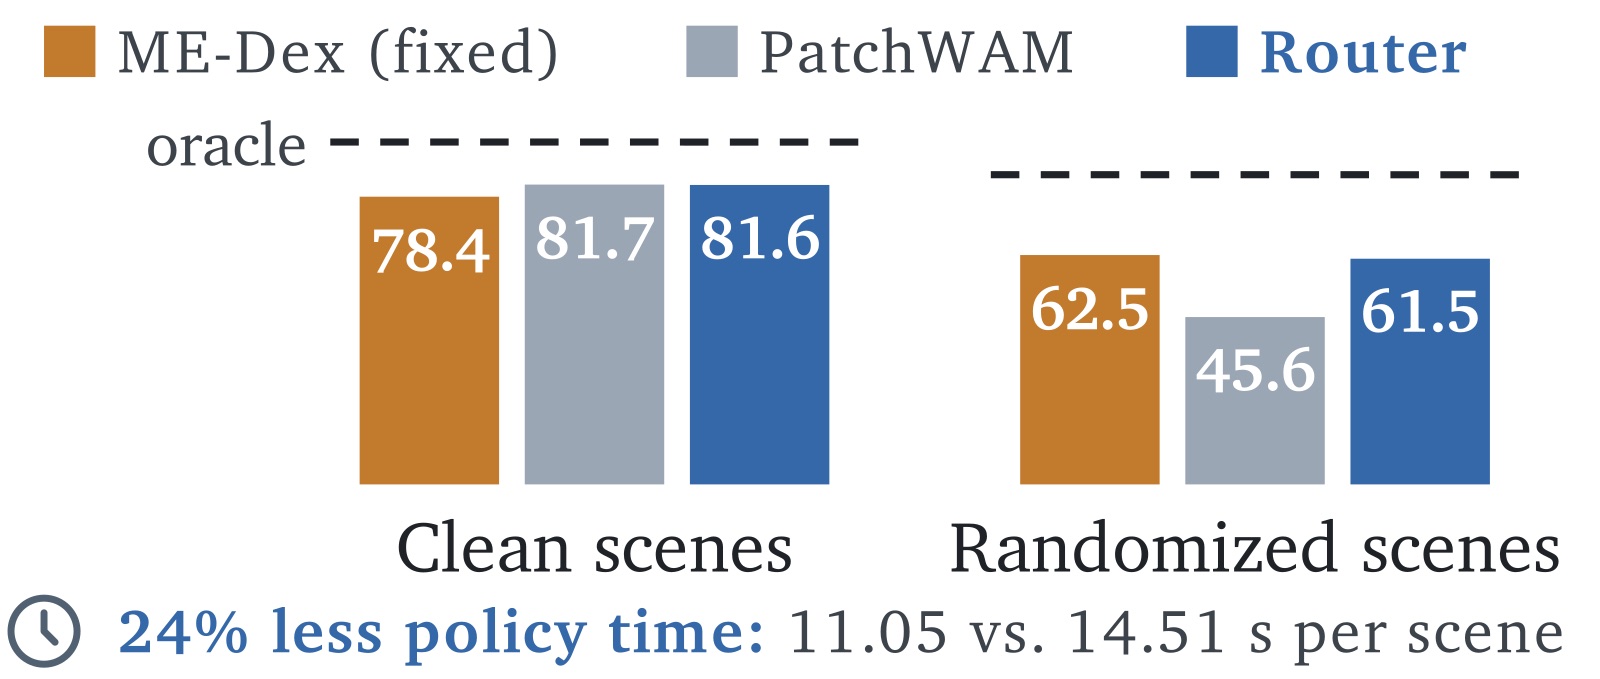
图 3:干净场景中,PatchWAM 为 81.7%,路由器为 81.6%,ME-Dex 为 78.4%;随机化场景中,ME-Dex 为 62.5%,路由器为 61.5%,PatchWAM 降至 45.6%。路由器跟随了两种场景下的优势策略,并把每场景策略推理时间从 14.51 秒降到 11.05 秒。
路由器把 1,000 个干净场景中的 929 个交给 PatchWAM,把 1,000 个随机化场景中的 842 个交给 ME-Dex。整体成功率为 71.55%,比 ME-Dex 的 70.45% 高 1.10 分,同时少用 24% 策略时间。
但置信区间是 \([-0.40,+2.55]\),跨过零。也就是说,省时结果很清楚,质量提升还不能算稳。按任务和场景条件直接选择的理想化策略能到 72.1%,甚至略高于这个像素路由器;它真正的增量,是不依赖显式场景标签而从图像里学到条件差异。
学“每个候选做得怎样”,别只学“谁赢了”
路由训练有个看似无害的选择:给每个输入标注本次赢家,训练多分类器;或者保留每个候选的实际结果,分别做结果回归。论文明确站在后者一边。
原因不只是信息量少。假设候选 A 每次都得到 0.8,候选 B 有 60% 概率得 1、40% 概率得 0。B 的胜率是 60%,赢家分类器会选 B;但 B 的期望质量只有 0.6,反而不如稳定拿 0.8 的 A。若还有按延迟打破平局的规则,标签会进一步偏爱“快但不可靠”的候选。
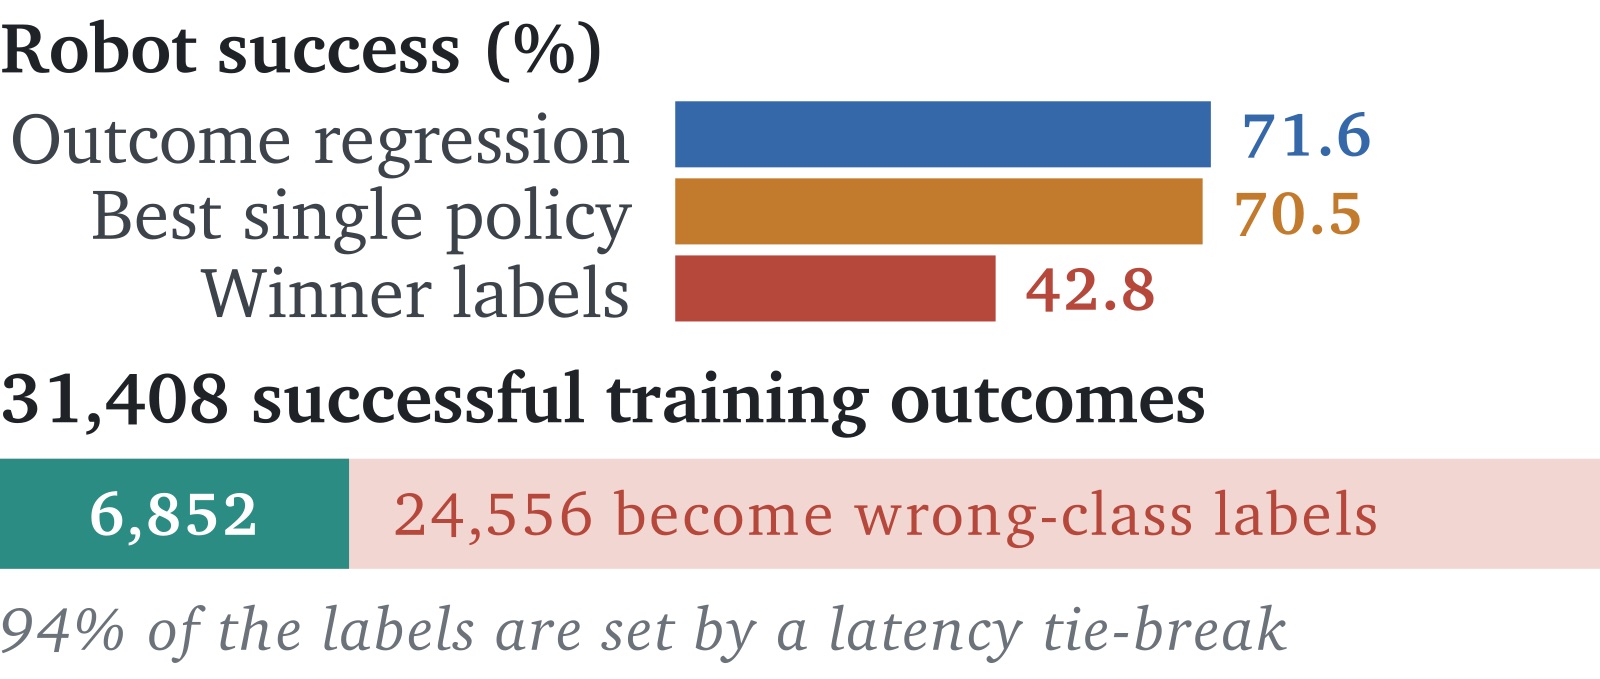
图 4:结果回归达到 71.6% 成功率,最佳单策略约 70.5%,赢家标签分类器只有 42.8%。31,408 个成功训练结果中,24,556 个因平局处理变成其他类别的标签;94% 的标签由延迟平局规则决定。
机器人实验里,多个策略经常同时成功。赢家标签只保留其中一个,还把大量成功结果变成其他策略的负样本,分类器于是学会挑快策略:每场景只花 1.9 秒,却经常失败。
这个对比很有冲击力,不过别急着把 28.75 分差距外推到所有模态。机器人之外,论文没有同样严格的目标对照面板;在 11 个文本、智能体和图像基准上,结果路由器比匹配后的固定候选低 0.40 分,区间跨零。它证明的是训练标签可能造成严重失真,不是结果回归已经解决了通用路由。
一个缺失分数,就能把落后 0.40 变成领先 2.38
这是全文我最喜欢的实验,因为它抓到了一种很常见的评测幻觉。
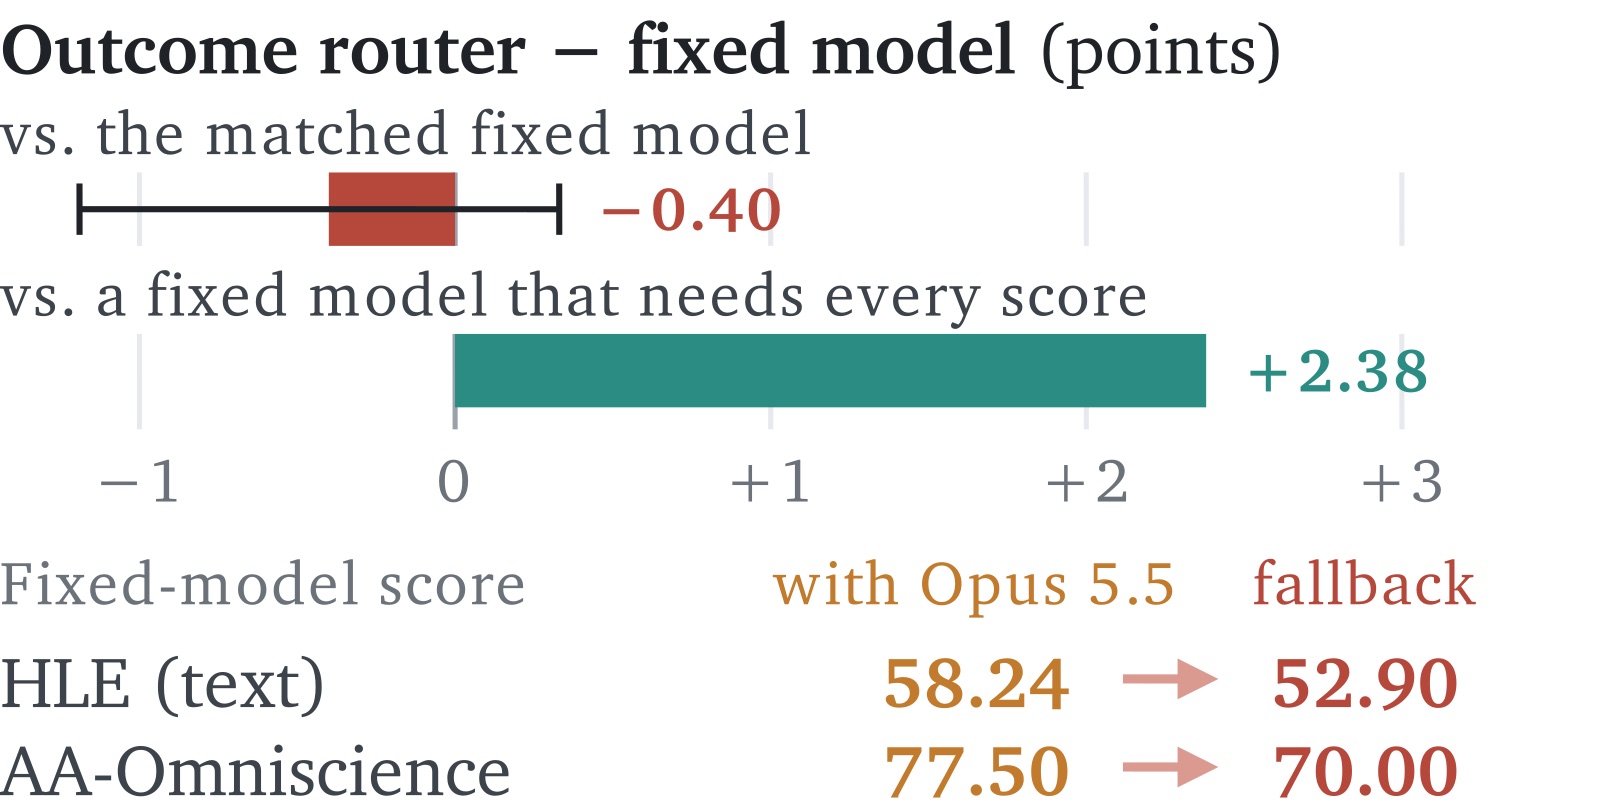
图 5:相对匹配固定候选,结果路由器低 0.40 分;相对“必须在每个训练输入上都有分数”的固定候选,却高 2.38 分。下方显示,旧基线因 Opus 5.5 的少量缺失而回退后,HLE 从 58.24 变成 52.90,AA-Omniscience 从 77.50 变成 70.00。
旧规则只要候选漏了一个训练分数,就取消它担任固定基线的资格。Opus 5.5 在 HLE 的 1,122 个训练输入中只缺 11 个,却被换成次优模型。七个基准都受到类似影响,固定基线总分从 68.30 降到 65.52。路由器本身没变,账面收益却从低 0.40 变成高 2.38。
这就是关键:路由论文最容易刷出来的,不一定是路由能力,也可能是基线选择能力。公平做法是固定候选与路由器面对同一输入、同一回退规则,再做配对比较。新增候选也一样,应在相同任务上比较两个候选池,而不是拿冻结的旧平均分配新平均值。
真正扎实的收益:便宜路线常常已经够用
成本实验使用了四个环境。代码来自 CodeRouterBench,文本来自 RouterBench;图像直接记录生成价格,机器人记录策略推理秒数。参考策略在代码中是始终调用 Opus 4.6,在文本中是始终调用 GPT-4,在图像中是每个基准的最佳固定生成器。
| 环境 | 路线与质量容忍 | 测试质量变化,单位分 | 相对参考效率 |
|---|---|---|---|
| 代码,美元 | 拟合,\(\epsilon=0\) | -0.44,95% 区间 [-1.75, +0.97] | 25.5 倍 |
| 代码,美元 | 认证,\(\epsilon=0\) | 200 次划分均不低于参考 | 19.4 倍 |
| 文本问答,美元 | 拟合,\(\epsilon=0\) | -0.40,95% 区间 [-0.84, +0.08] | 7.1 倍 |
| 文本问答,美元 | 认证,\(\epsilon=0\) | 200 次划分均不低于参考 | 6.7 倍 |
| 图像生成,美元 | 拟合,\(\epsilon=0.5\) | -0.47,95% 区间 [-0.87, -0.06] | 1.35 倍 |
| 图像生成,美元 | 拟合,\(\epsilon=2\) | -1.56,95% 区间 [-2.39, -0.73] | 2.03 倍 |
| 机器人,秒 | 结果路由器 | +1.10,95% 区间 [-0.40, +2.55] | 1.33 倍 |
摘要中的 8.82 倍,是代码 25.5、文本 7.1、图像 1.35 和机器人 1.33 这四项的无权算术平均。它混合了美元与秒,也不是 25 个基准的总体效率。这个口径可以用,但不能理解成“任意业务部署都会省近九倍”。
代码环境的 25.5 倍尤其强。始终用 Opus 4.6 每任务花费 11.655 毫美元,拟合零损失路线只花 0.452 毫美元,测试质量低 0.44 分且区间跨零。最便宜的 Qwen3-Max 单独使用已有 20.1 倍效率,但低 4.2 分;按状态路由补回了大部分质量缺口。
文本环境则相反:完全避开 GPT-4 的最佳路线会低 9.7 分,所以零损失路线必须让便宜主模型先答,再把一部分请求升级给参考模型。两个环境合在一起说明,级联不是永远正确,直接路由也不是永远正确,关键在参考模型于被升级输入上的边际价值。
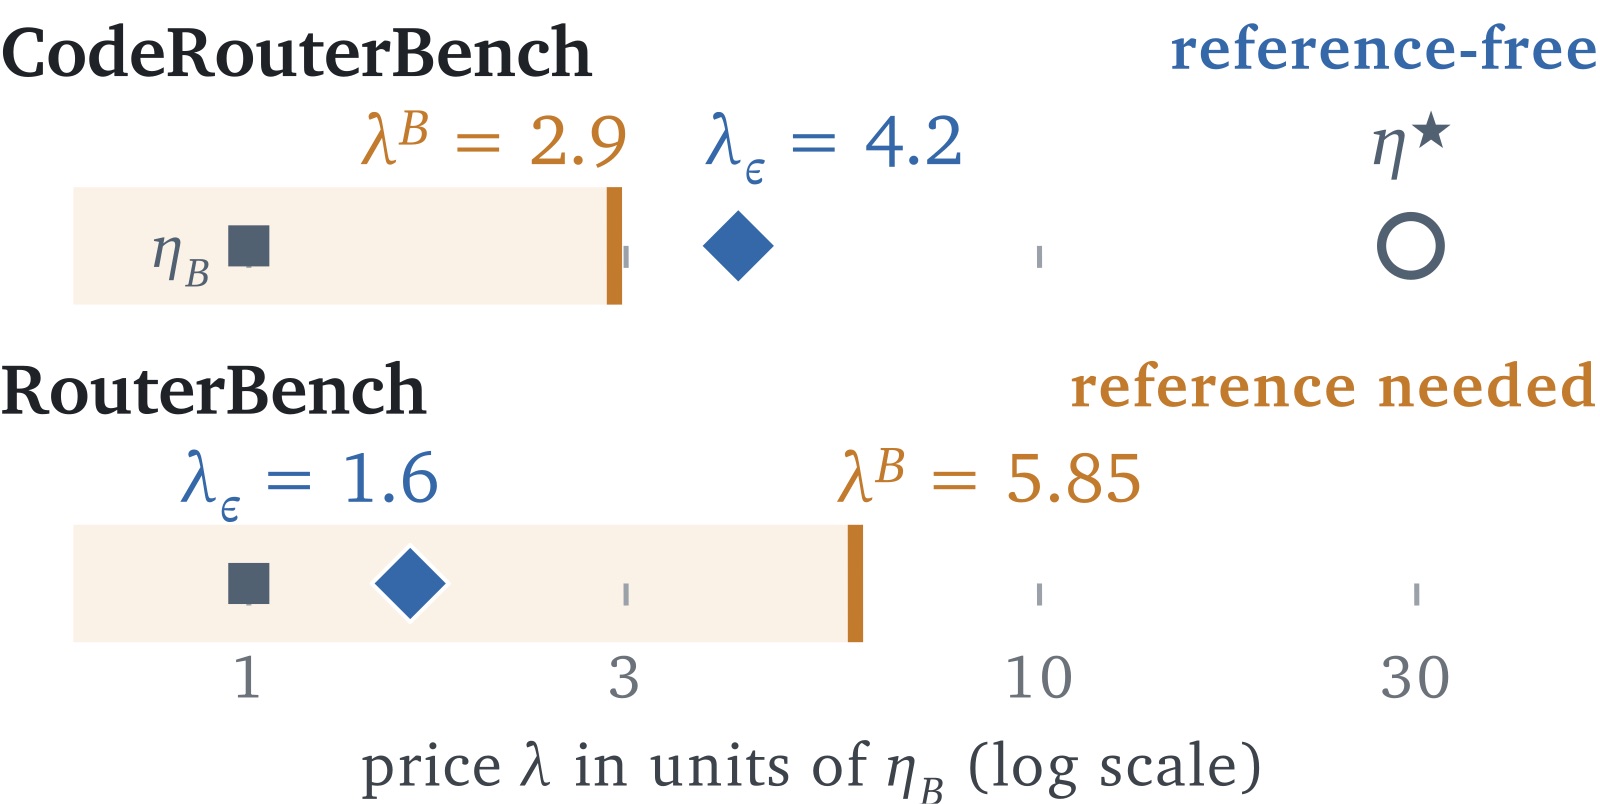
图 6:横轴是以参考效率 \(\eta_B\) 为单位的资源价格。CodeRouterBench 中,参考准入价格 \(\lambda^B=2.9\) 低于零损失价格 \(\lambda_\epsilon=4.2\),最优路线无需调用参考;RouterBench 中 \(\lambda_\epsilon=1.6\) 低于 \(\lambda^B=5.85\),参考模型仍值得进入级联。
拟合时不掉分,不代表测试时不掉分
价格从零逐渐增加,会得到一串质量下降、成本下降、效率上升的路由器。认证过程按这个顺序检查,在独立数据上无法确认质量底线的位置停下;若第一个都过不了,就退回参考策略。
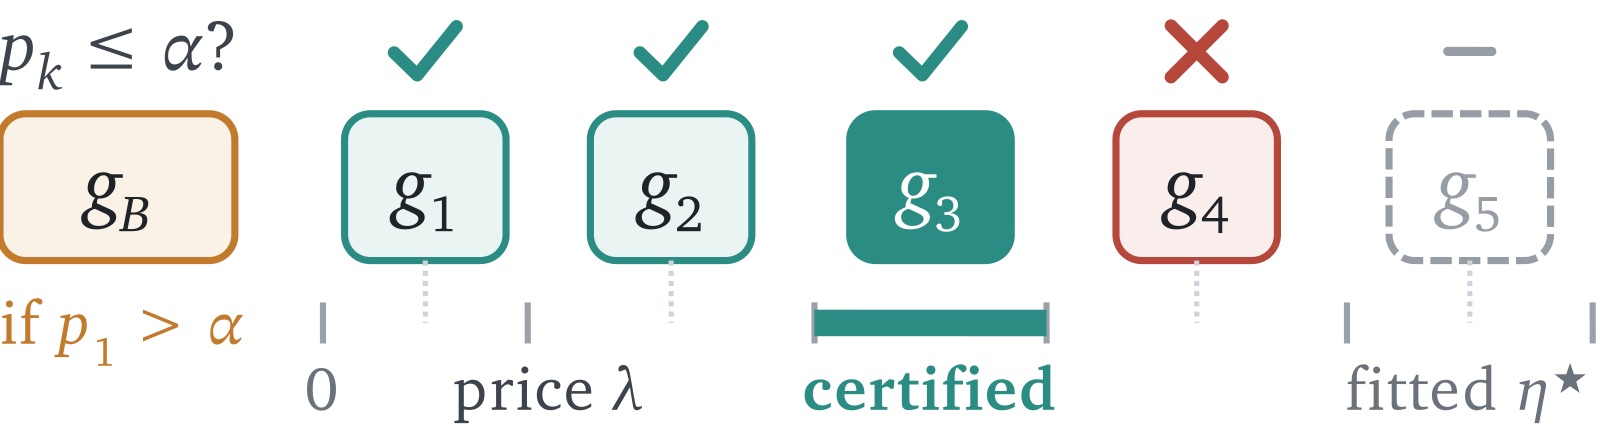
图 7:\(g_B\) 是参考策略,\(g_1\) 到 \(g_5\) 沿价格路径排列。\(g_1\)、\(g_2\)、\(g_3\) 的检验通过,\(g_4\) 失败,于是选择 \(g_3\)。固定顺序检验避免了在整条路径上反复挑选带来的多重比较问题。
代码实验中,只用一半 probing 数据拟合零质量损失底线,测试集上只有 12.5% 的 200 次随机划分真正守住底线。用另一半独立数据做 empirical-Bernstein 认证,并在相邻路由器之间加入混合策略后,200 次都守住了汇总质量底线,中位效率仍有 19.4 倍。文本认证也得到 200 次全通过、6.7 倍中位效率。
这个认证很工程友好,但保证是总体均值层面,不保证每个任务切片。附录提到,认证代码路由器在 21 个测试 cell 中,中位数仍有 8 个出现质量下降。做生产系统时,关键业务切片还得单独设护栏。
多试一次、加个验证器,也未必划算
论文还把重试和验证器放进同一本账。结果有点泼冷水:在 42 个有序模型对中,第二个模型在“第一个已经失败”的任务上成功率都更低,中位条件成功率比为 0.49。失败后留下的本来就更难,不能拿边际成功率直接规划重试。
验证器同样要计费。Qwen3-Max 在阈值 0.5 的设置下,免费编译器门控带来 4.09 倍美元效率,但质量低 2.4 分;LLM judge 若免费是 2.63 倍,按刊例价收费后只剩 0.30 倍。若比较实际秒数,始终用 Opus 反而比所有受验证级联更快,因为便宜主模型本身响应更慢。
路由信号也不能免费化。用 DeepSeek-v4-pro 预测模型是否成功,按刊例价相当于 2.4 次主模型尝试;只用提示文本的 TF-IDF 路由器,成本约为一次尝试的 0.06%。看到这里,我第一反应是:很多路由方案不是输在主模型,而是输在自己的“小附件”上。
放到已有工作里,它新增了什么
路由并不是新概念。FrugalGPT 已把便宜模型、答案评分和按需升级组成级联;RouteLLM 用偏好数据学习强弱模型选择,其 ICLR 2025 页面报告在保持响应质量的情况下把成本降低两倍以上;RouterBench 提供超过 40 万次语言模型推理结果,用质量成本前沿比较路由器。算法组合研究里的 virtual best solver,也与这里的逐输入 oracle 对应。
| 工作 | 主要对象 | 决策方式 | 与 Route Anything 的关系 |
|---|---|---|---|
| FrugalGPT | 语言模型 API | 便宜模型先试,验证后升级 | 提供级联式成本思想 |
| RouteLLM | 强弱语言模型 | 从偏好数据学习路由 | 代表学习型文本路由 |
| RouterBench | 11 个语言模型、多类文本数据 | 用记录的质量与成本评测路由 | 成为这项工作的文本成本测试床 |
| Route Anything | 模型、生成器、执行计划、机器人策略 | 结果预测、类型路由、直接分派与级联统一建模 | 扩展模态与候选类型,并加入参考、质量底线和有限样本认证 |
所以,这篇论文的定位更像理论整合加跨模态大规模评测,而不是凭空发明路由。它的增量在于统一坐标系:信息决定质量上限,参考策略与容忍度决定价格,独立样本决定质量承诺能否被相信。
相关公开资料:
- FrugalGPT:https://arxiv.org/abs/2305.05176
- RouteLLM:https://arxiv.org/abs/2406.18665
- RouterBench:https://arxiv.org/abs/2403.12031
我的判断:最值得抄的是评测纪律,不是路由器结构
这篇论文让我最有好感的,是它没有把 5.38 分 oracle 空间包装成实际收益。学习路由器只拿到其中一小部分,图像路由大量失败,赢家标签在机器人上严重失真,基线缺失值还能制造虚假领先。作者愿意把这些不漂亮的数放在一起,文章反而更可信。
短板也同样清楚。跨 16 个基准的 0.30 分提升很小,而且主表只有一个训练种子;机器人 1.10 分提升的区间跨零;25 个基准的指标虽然都缩放到 0–100,汇集后仍受各基准输入数影响;8.82 倍是四个效率比的平均,不是普遍部署结论。至于真实线上流量中的分布漂移、模型静默更新和路由缓存污染,这套静态矩阵还回答不了。
如果你准备在自己的系统里做路由,我会按下面的顺序落地,而不是先训练一个更大的分类器:
| 步骤 | 工程动作 | 防住的坑 |
|---|---|---|
| 建配对矩阵 | 让候选跑同一批真实输入,保留每次结果、成本、延迟和缺失原因 | 用不完整的弱基线制造收益 |
| 先看固定与 oracle | 测最佳固定候选、事后固定候选和去噪后的逐输入上限 | 在没有互补空间的任务上白做路由 |
| 学结果而非标签 | 为每个候选预测期望结果,平局也保留 | 平局规则把快而差的候选标成赢家 |
| 写清参考与容忍度 | 明确相对谁省钱、允许掉多少质量,并计算完整链路成本 | 只报性价比,掩盖质量塌陷 |
| 独立认证并持续重测 | 用未参与拟合的数据检验底线,按关键切片监控漂移 | 把训练集承诺误当线上保证 |
回到标题里的矛盾:路由器确实不是万能大脑,它甚至很难稳定打败一个认真选出的固定候选。但只要候选质量接近、价格相差悬殊,一套简单、配对、可认证的路由,就可能比继续堆一个更大的统一模型更实用。
这才是 Route Anything 最值得带走的东西。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我