不是模型越大越对齐:JEPA 用“好视图”改写柏拉图表征假说
一个只看图片的模型,和一个只读文字的模型,从没一起训练过,却可能在心里画出相似的“概念地图”。想把它们接起来,通常做法是多模态配对训练,或者把模型越堆越大。
这篇论文给了一个很不一样的答案:决定两张地图能否重合的,可能不是模型规模,而是训练时把哪些样本当作“同一个东西”。
说实话,我看到“109M 文本模型在表征对齐上超过 72B 语言模型”时,第一反应是去找评测口径。它说的不是推理、问答或生成能力全面反超,而是一个更聚焦的问题:文本嵌入的邻居结构,能不能和独立训练的视觉嵌入对上。把这个边界先说清楚,后面的结果反而更值得细读。
核心摘要:柏拉图表征假说认为,不同模态的大模型会随规模扩大而收敛到共享的世界表征,却一直缺少可操作的保证。Randall Balestriero 和 Yann LeCun 把问题改成“正样本对是否连接同一世界状态”,在理想化条件下证明:采用好视图的 JEPA 即使分模态独立训练,也只差一个旋转。实验中,好视图用 21.6M 样本达到 next-token 预测在 900M 样本上的对齐水平,样本量少 42 倍;109M 文本 JEPA 在 WIT-1024 上取得 0.184,高于所测 Qwen2.5-72B 的 0.154。真正吸引人的不是“小模型超过大模型”,而是训练信号从“同一条数据的两种损坏”转向“同一场景的两种观察”。不过,好视图本身需要场景分组,网络文本又借助了图像字幕器,这些代价不能藏在漂亮的倍数后面。
📖 论文信息
| 项目 | 内容 |
|---|---|
| 英文标题 | Proving and Improving the Platonic Representation Hypothesis with JEPAs |
| 作者 | Randall Balestriero、Yann LeCun |
| 作者单位 | Brown University、New York University、AMI Labs |
| arXiv | 2610.39302,v1,2026 年 10 月 29 日提交 |
| 学科 | cs.AI、cs.CV、stat.ML |
| 论文链接 | https://arxiv.org/abs/2610.39302 |
| 代码 | https://github.com/galilai-group/prh-proof |
| 在线演示 | https://huggingface.co/spaces/galilai-group/prh_demo |
🎯 柏拉图表征假说,缺的并不只是一个证明
2024 年,Huh 等人在 ICML 的立场论文中提出柏拉图表征假说:图像、文字等数据是同一个现实的不同投影,不同神经网络随着规模、数据和任务多样性增长,表征会越来越相似,趋近某个共享的现实统计模型。
这个直觉很有吸引力。视觉模型把“狗追球”和“狗接飞盘”放得近,文本模型也把相应句子放得近,那么两个空间的相对几何就可能相似,即便坐标轴完全不同。
你想想看,两张城市地图可以一张朝北、一张旋转 30 度,街道关系仍然是同一张地图。论文里的“只差一个旋转”也是这个意思:不是要求第 17 维对第 17 维,而是样本之间的距离、角度和邻域能够在正交变换后对应起来。
原假说更多来自经验观察。它告诉我们“规模大了似乎会更像”,却没有回答三个工程问题:什么训练目标会产生这种相似?为什么有的模型读了很多文本仍然对不齐?除了继续扩规模,还能动哪个旋钮?
这篇论文把旋钮对准了 positive pairs,也就是正样本对。
| 路线 | 跨模态关系如何进入训练 | 学到相似几何的主要机制 |
|---|---|---|
| CLIP 式联合训练 | 图像与文本直接在对比损失中配对 | 显式跨模态监督 |
| 原始 PRH 的观察 | 不强制联合训练,比较不同模型的表征 | 规模、数据与任务带来的收敛趋势 |
| 这篇论文的好视图 JEPA | 各模态分开训练,但各自正样本连接同一场景的不同观察 | 不同模态求解同一个世界状态图上的谱嵌入问题 |
这里有个很容易被标题遮住的点:好视图 JEPA 并不是“完全没有配对信息”。同一张图的多条人工字幕属于同一场景,这个分组本身就是配对知识。它省掉的是跨模态联合损失,不是凭空消灭所有配对先验。
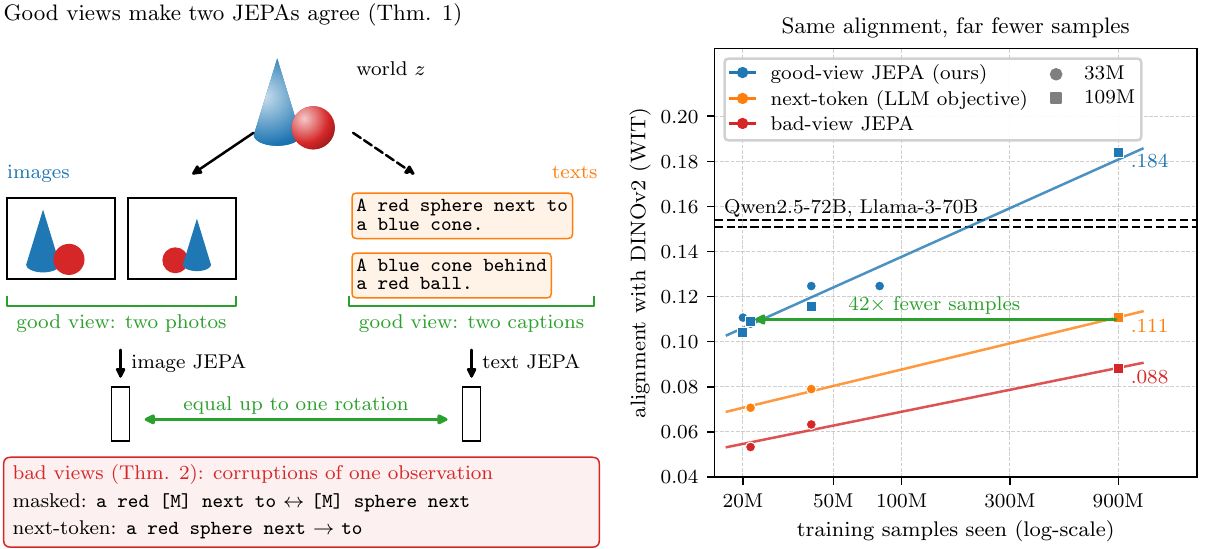
图 1:论文总览。左侧把同一个世界状态渲染为两张照片或两条字幕,独立训练的图像、文本 JEPA 在好视图下只差一个旋转;同一观察的遮罩损坏和前缀到续写则被归为好视图之外。右侧在 WIT-1024、DINOv2 的 PRH 协议下比较训练样本数:好视图在 21.6M 样本达到 0.109,next-token 在 900M 样本达到 0.111;900M 样本的好视图模型来到 0.184。虚线标出 Qwen2.5-72B 与 Llama-3-70B 所在水平。
🧠 核心定理:不同模态,其实在解同一道图嵌入题
把世界、观察和正样本分开
作者先设一个有限世界,状态为 \(z\in\mathcal Z\),出现概率为 \(p(z)\)。模态 \(m\) 通过单射 \(x=g_m(z)\) 观察世界:图片是一种渲染,文字是另一种渲染。训练目标可以写成:
\(\pi_m\) 决定哪些世界状态被拉成正样本,\(\ell\) 负责让对应嵌入接近,\(\Omega\) 防止所有输出塌成一个点。两个项都对旋转保持不变。
关键观察很简洁:如果 \(g_m\) 是单射,它只换了坐标,没有改变世界状态之间的关系。只要各模态共享 \(\pi_m=\pi\),并且总体最优解除了旋转之外唯一,那么每个模态的最优编码器都满足 \(f_m^\star\circ g_m=Q_mh^\star\)。这里 \(h^\star\) 是同一个世界嵌入,\(Q_m\) 是各模态自己的旋转。
对于平方距离加白化约束的谱 JEPA,答案还能写得更具体:模型学到正样本图归一化邻接矩阵的前 \(k\) 个特征向量;第 \(k\) 与第 \(k+1\) 个特征值之间有谱隙时,解在旋转意义下唯一。不同模态于是不是在猜彼此,而是在各自坐标系里算同一张图的主特征方向。
这套证明的边界同样清楚:有限世界、单射渲染、相同边缘分布、总体最优、旋转外唯一性,以及谱情形下的谱隙。真实文本会有损地描述场景,真实训练也到不了精确总体最优。作者明确承认,没有实验严格满足全部假设。把它读成一个可检验的充分条件,比读成“所有 JEPA 必然对齐”准确得多。
正样本不一样,误差有界; nuisance 会占用维度
如果两个模态的正样本图不同,论文用归一化核的差异和谱隙给最优旋转后的误差上界。谱隙越大、正样本核越接近,表征越能对齐;谱方向挤在一起时,靠后的方向可以很不稳定。实验里 300 个随机有限世界都满足上界,实测误差最多为上界的 18%。
更直观的是 nuisance,可以译成“模态特有的干扰因素”。同一场景的两条字幕共享主体和关系,却各有措辞;同一张照片的两个裁剪共享机位、光照和画面边界。措辞对文本建模有用,机位对视觉世界模型也有用,但它们不一定能跨模态对应。
论文把编码器中由场景解释的比例记为 \(\rho\)。任何分配给 nuisance 的维度,都可能成为旋转也无法修复的对齐损失。在 Flickr 的 \(k=32\) 分析中,好视图、坏视图和 next-token 模型的场景解释比例分别为 0.804、0.655 和 0.608。这组数把“为什么对不齐”从玄学变成了可测量现象。
| 训练方式 | 正样本从哪里来 | 容易保留什么 | 论文中的归类 |
|---|---|---|---|
| Caption views | 同一图片的不同字幕 | 场景共享内容 | 好视图 JEPA |
| Masked spans | 同一条字幕的不同截断、遮罩 | 该字幕的措辞与局部共现 | 坏视图 JEPA |
| 图像 crops | 同一张照片的不同裁剪 | 机位、光照、构图等视觉 nuisance | 坏视图 JEPA |
| Next-token | 同一文档的前缀与后续 token | 文档措辞、风格和续写统计 | 具有坏视图形式的预测目标 |
“坏”在这里只针对跨模态对齐,不是说这些目标学不到好特征。DINOv2 自己就是裁剪正样本,论文也把它叫作 bad-view JEPA;它依然是很强的视觉编码器。这个命名有点冲,概念边界倒是很明白。
Next-token 为什么也被写成 JEPA
把上下文编码记为 \(h(c)\),token \(v\) 的输出向量记为 \(w_v\),线性 softmax 的 next-token 损失可以拆成:
预测项拉近上下文和真实续写,log-partition 防止所有 logit 一起无限增大。从这个角度,next-token 的正样本是同一序列里的“前缀—续写”,目标编码器则是 token 表。
但这里要踩一下刹车。作者也强调,next-token 使用两个编码器,最优解一般只能在 \(\mathrm{GL}(k)\) 可逆线性变换意义下识别,并不满足前面单编码器谱 JEPA 的全部条件。因此,“next-token 是 bad-view JEPA”带来的是一个有理论依据、再由实验检验的解释,不是从定理直接推出的严格推论。坦白讲,这个分寸我很喜欢,论文没有把类比偷偷升级成证明。
🔧 实验怎样只改变“视图”,而不偷换模型和数据
Flickr30k 的基础实验用 29k 训练图片,每张五条字幕,约 145k 条文本。文本编码器从头训练,是 12 层、隐藏宽度 384 的 BERT-S,33M 参数;图像侧为 ViT-S/16。好视图、坏视图和 next-token 三组使用相同文本、相近训练配方,彼此都看不到对方模态。
好视图从同一图片的不同字幕生成 8 个视图;坏视图从同一条字幕生成 8 个截断遮罩视图;next-token 则把同一 BERT 改成因果注意力并接 tied softmax head。JEPA 使用 LeJEPA 的预测项和 SIGReg,默认 \(\lambda=0.02\)。基础实验跑 200 epochs,batch 256,AdamW 学习率 \(5\times10^{-4}\),weight decay 0.05,报告三个随机种子的均值。
截断不是小装饰。全局视图保留连续 50%–100% 文本,局部视图保留 15%–50%,再遮罩保留 token 的 15%。它让同一图片的两条字幕更集中于共同内容。把整条字幕直接当视图,R@1 从默认的 0.246 降到 0.185,约损失四分之一;遮罩比例、视图数、batch、宽度和训练时长对均值的改变至多 0.016。梯度裁剪主要管稳定性,不是涨分魔法。
评测分成两类。Mutual 10-NN 比较两个空间中 10 近邻集合的重叠,不拟合任何映射;WIT-1024 上随机水平约为 0.01。检索指标则在验证配对上拟合一个正交映射,再测图像到字幕的 R@1、R@5,检验“只差旋转”是否真能用于对应样本。
🧪 结果一:同样的数据,好视图从头就更能对齐
Flickr 的主结果很干净。
| 文本编码器 | Mutual 10-NN | R@1 | R@5 |
|---|---|---|---|
| 好视图 JEPA | 0.062 ± 0.003 | 0.044 ± 0.002 | 0.133 ± 0.004 |
| 坏视图 JEPA | 0.047 ± 0.001 | 0.027 ± 0.002 | 0.095 ± 0.003 |
| Next-token | 0.042 ± 0.001 | 0.021 ± 0.002 | 0.077 ± 0.005 |
| Next-token,同图字幕对 | 0.043 ± 0.001 | 0.023 ± 0.003 | 0.083 ± 0.008 |
好视图的 R@1 是 4.4%,随机水平为 0.1%,也就是 44 倍随机。绝对数不高,图像侧只在 29k 图片上从头训练,不能把这张表读成成熟检索系统的水平;真正重要的是相同骨干、相同文本下的相对差距。
还有个挺妙的对照:把同图两条字幕拼给 next-token,Mutual 10-NN 只从 0.042 到 0.043,R@1 只从 0.021 到 0.023。知道两条字幕属于同一张图,还不够;怎样使用这份关系,才是差异来源。
视频实验补上了另一侧。MSR-VTT 中,图像好视图来自同一视频的不同帧,文本好视图来自不同字幕。图像和文本都用好视图时 Mutual 10-NN 为 0.067;只用文本好视图为 0.059,只用图像好视图为 0.043,两者都不用为 0.039。与此同时,冻结的 DINOv2 反而更喜欢同样使用 crops 的图像 JEPA,0.144 对 0.132。正样本是否一致,比“好视图”这个名字本身更能解释方向。
📊 结果二:42 倍样本效率,109M 超过所测 72B 模型
小规模实验之后,作者把文本换成 Recap-DataComp:每张网络图片带 alt-text 和两条由 LLaVA 生成的 recaption,同一图片的三条文本充当观察。数据从 2.16M 张图片对应的文本,扩到 940M 张图片对应的文本。
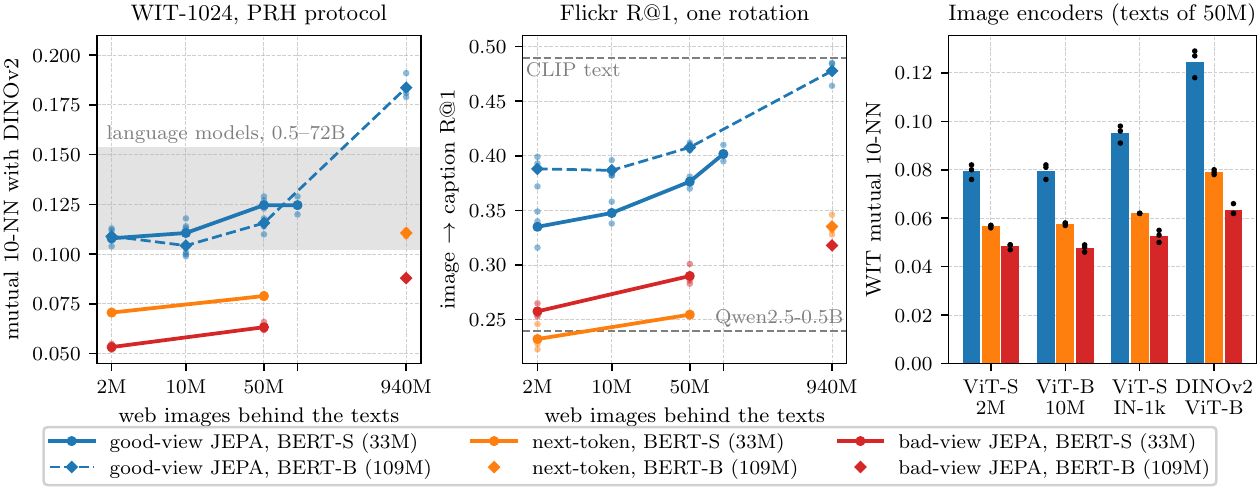
图 9:左图是 WIT-1024 上与 DINOv2 的 Mutual 10-NN,灰色区域覆盖所测 0.5B–72B 语言模型;中图是经过一个旋转后的 Flickr 图像到字幕 R@1;右图换成多个独立视觉编码器后,好视图、next-token、坏视图的排序仍保持一致。圆点与菱形区分 33M BERT-S 和 109M BERT-B,940M 处的三个单点对应相同文本规模下的三种目标。
最抓眼的是 42 倍。同一个 109M BERT-B、同一语料来源下,好视图看 21.6M 样本得到 WIT 0.109,next-token 看 900M 样本得到 0.111。换算成文本 token 是少 14 倍,因为一个好视图样本会读三条文本;换算成独立图片来源则少 435 倍。
这个倍数有吸引力,也有两个脚注。两组大规模 run 的 batch 和学习率并不完全相同,作者没有做严格等算力比较;21.6M 对 900M 又是跨数据规模、跨训练配置的匹配点。因此,42 倍是样本效率结果,不是训练成本全面降低 42 倍。
更大的主表如下。三种作者的模型都是 109M BERT-B,使用 940M 图片对应文本、900M 训练样本。WIT 使用 DINOv2 ViT-B 的 Mutual 10-NN,另列线性 CKA、CLIP ViT-H/14、5,000 对 COCO 以及 Flickr R@1。
| 文本编码器 | WIT DINOv2 10-NN | WIT CKA | WIT CLIP-H 10-NN | COCO DINOv2 10-NN | Flickr R@1 |
|---|---|---|---|---|---|
| 好视图 JEPA 109M | 0.184 | 0.507 | 0.230 | 0.161 | 0.478 |
| Next-token 109M | 0.111 | — | 0.146 | — | 0.335 |
| 坏视图 JEPA 109M | 0.088 | — | 0.116 | — | 0.318 |
| Qwen2.5-72B | 0.154 | 0.418 | 0.210 | 0.108 | — |
| Llama-3-70B | 0.151 | 0.380 | 0.206 | 0.113 | — |
| CLIP B/32 text | 0.124 | 0.339 | 0.159 | 0.132 | 0.489 |
| all-mpnet-base-v2 | 0.118 | 0.390 | 0.159 | 0.156 | 0.481 |
109M 好视图模型读过 116B 文本 token,Qwen2.5-72B、Llama-3-70B 的训练量为 15–18T token。参数量差约 660 倍,token 量差超过 100 倍,而 WIT DINOv2 分数是 0.184 对 0.154、0.151。
不过,CLIP 文本编码器在 Flickr R@1 上仍以 0.489 略高于 0.478;它和 all-mpnet 都用过大量配对数据。好视图模型最突出的地方是与独立视觉模型的几何一致性,不是所有检索指标都拿到第一。这个区分很有必要。
随机种子也不是无关紧要。一个有效 SIGReg 权重翻倍的第四个种子只得到 WIT 0.121;四个种子平均为 0.168,仍高于表中的语言模型,但低于三种子均值 0.184。WIT-1024 本身也小,50M 模型与部分中型语言模型的差距落在采样噪声内,而不同视图之间的差距更稳定。数据重叠同样被查过:至少 43 条 WIT 字幕与 Recap alt-text 完全或前缀重合,移除对应配对后,九种文本模型的分数变化都不超过 0.002;但 WIT 图片无法标识,不能据此排除图像级重叠。看到 0.184 时应该同时看到这些脚注,而不是只抄最大的数。
对齐也有 scaling law,但外推会坏
作者把每个训练项以概率 \(q\) 取好视图,否则取坏视图,拟合“坏视图基线随 \(\log M\) 增长,再加上好视图项”的经验定律。模型是 BERT-S,语料对应 10.2M 网络图片,拟合网格最多到 80M 样本。

图 11:横轴是训练所见样本数的对数刻度,纵轴是 Flickr R@1。颜色表示好视图比例 \(q\),黑色为 \(q=0\);圆点是拟合网格,菱形是训练前预测的 run。各条曲线随样本量对数近似线性上升,好视图比例越高,斜率越大;拟合范围外的虚线也提示外推并不可靠。
定律拟合 45 个网格单元,RMSE 为 0.007;随后预测 85 个未见 run,RMSE 为 0.0093,而同一 run 换随机种子的差异为 0.0096。预测误差和重跑噪声差不多,这个结果挺漂亮。
但 320M 样本、重复数据 31 遍时,\(q=1\) 的实测 R@1 为 0.418,预测却是 0.455;\(q=0.1\) 为 0.348,预测 0.389。没有好视图的 run 仍吻合。模型没有重复数据衰减项,指数也识别得不充分。它是单一配方的经验摘要,不是定理推导出来的普遍规律。
🧩 结果三:一个旋转,把独立编码器变成字幕系统
这部分最能体现“表征对齐是件可用的工具”。
图像编码器冻结 DINOv2 或 DINOv3;文本解码器只根据好视图文本 JEPA 的嵌入重建字幕,训练时不看图片。推理时,图片嵌入经过带正交行约束的线性映射,再交给解码器生成文字。只有这个映射在图像—字幕配对上拟合,没有神经网络通过图像—字幕对做联合训练。
| 组件 | 看到的数据 | 是否用图像—字幕对训练 |
|---|---|---|
| 图像编码器 | 图片 | 否 |
| 文本 JEPA 与解码器 | 文本 | 否 |
| 正交行约束映射 | 配对嵌入 | 是,唯一使用配对的拟合部件 |
解码器训练还要加高斯噪声,让它容忍旋转后的残差。作者没有随意调噪声,而是用验证配对上的平均余弦 \(c\approx0.29\) 推出 \(\sigma=(c^{-2}-1)^{1/2}\approx3\),直接取 \(\sigma=3\)。这种从对齐误差推训练参数的做法,比再网格搜索十组噪声更有理论味道。
最强配置使用 100M 网络图片对应文本训练的文本 JEPA、Qwen2.5-1.5B 文本解码器、冻结 DINOv2 ViT-g 与 DINOv3 ViT-L,并对 32 个采样字幕做共识解码,在 COCO 上得到 CIDEr 0.838。注意论文把 CIDEr 统一放在 0–1 刻度,许多旧工作会乘以 100。

图 10:四组 COCO 示例,每组上方黑色文字是生成字幕,下方灰色文字是人工参考。模型能描述鞋架上的猫、桌旁切蛋糕的女性、吃巧克力甜甜圈的小女孩和冲浪者;措辞与细节粒度并不完全相同,例如猫的例子更强调猫本身,人工参考更强调金属鞋架。图中系统使用冻结视觉编码器、文本侧解码器和在 30k Flickr 配对上拟合的一个映射。
正交约束还有迁移价值。同样拟合 30k Flickr 配对,无约束线性映射在 Flickr 上略好,却在 COCO 上损失约五分之一;两层 MLP 两边都更差。只允许旋转,反而不容易把 Flickr 的配对噪声学进去。
但“没有训练一个网络在图像—字幕配对上”不等于“整个系统没用配对数据”。30k 配对用于映射,Recap 文本来自看图的 captioner,解码器也可使用 Flickr 和 COCO 文本。宣传时少了这句,结论就会变形。
连旋转也可以不用配对来估计
论文接着采用 Schnaus 等人的 Wasserstein Procrustes 方法,在 COCO train2014 的互不相交图片池和字幕池上,从几何结构估计正交映射,再到 40,504 个验证配对上评测。FOSCTTM 越低越好,0 为完美,0.5 为随机。
| 文本编码器 | FOSCTTM ↓ | CIFAR-10 Top-1 | CIFAR-100 Top-5 | ImageNet-100 Top-5 |
|---|---|---|---|---|
| 好视图 JEPA 109M | 0.018 | 86.0% | 67.2% | 64.4% |
| 坏视图 JEPA 109M | 0.026 | 78.1% | 55.3% | 46.7% |
| Next-token 109M | 0.287 | 25.5% | 19.9% | 20.3% |
| Qwen3-8B,同条件重跑 | 0.018 | 83.4% | 61.7% | 47.6% |
| Schnaus 等已报最佳,任意设置 | 0.010 | 82.0% | 62.0% | 56.0% |
| CLIP B/32 text | 0.006 | 84.0% | 67.0% | 68.7% |
好视图 JEPA 在 ImageNet-100 Top-5 上比同条件 Qwen3-8B 高 16.8 个点,CIFAR-100 高 5.5 个点;CLIP 文本编码器则在 FOSCTTM 和 ImageNet-100 上更好。坏视图 JEPA 也拿到 0.026,所以这组 COCO 结果更支持“JEPA 比 next-token 更容易无配对对齐”,并不能把全部功劳都归给好视图。
🔬 我对这篇论文的判断:最值钱的是视图观,不是 109M 对 72B
我觉得这篇论文最扎实的地方,是把一个偏哲学的假说拆成了可以干预的训练变量。模型规模不再只是“大”或“更大”,正样本图变成了可以设计、可以测 nuisance、可以做消融的对象。视图改变以后,同数据、同骨干的对齐差距反复出现,这比单个 0.184 更有说服力。
它也不是凭空出现的一条线。原始 PRH 提供跨模态收敛现象,谱对比学习和 Laplacian eigenmaps 提供数学语言,I-JEPA 把预测放到表征空间,LeJEPA 用 SIGReg 约束各向同性高斯,Orthogonal Procrustes 与 Wasserstein Procrustes 则负责把已有空间接起来。论文的贡献在于把这些部件组成一条因果链:正样本决定世界核,世界核决定谱几何,谱几何决定跨模态能否用一个旋转连接。
问题也同样实在。
好视图从哪里获得,是最大工程门槛。 Flickr 和 COCO 靠人工为同一图片写多条字幕,天然有场景分组;普通网页语料通常没有。Recap-DataComp 的两条 recaption 由 LLaVA 生成,而其视觉侧包含 CLIP ViT-L/14,已经吸收了图像—文本训练的信息。只做 alt-text 加纯文本改写时,WIT 为 0.060;使用 recaption 后为 0.107。同文本下比较视图仍然公平,但与 CLIP、LLM 做绝对分数比较时,这条数据链路必须一起摆出来。
理论与实验之间还有距离。 大规模文本侧用 LeJEPA,图像侧多数仍是 crops,也就是论文定义的坏视图;旋转外唯一性只在二阶白化等谱情形下证明,不覆盖 LeJEPA 完整分布约束。真实观察有损,有限样本优化还依赖网络归纳偏置。作者自己把这些写进 limitations,读者不该替他们删掉。
比较范围是表征对齐,不是通用模型能力。 实验没有证明 109M JEPA 能在语言理解、数学、推理或生成上替代 72B LLM,也没有证明 next-token 是低效的语言学习路线。它证明的是:若目标就是让文本几何贴近独立视觉模型,直接预测下一个 token 会浪费很多容量在文档局部统计上。把结论限定在这个目标里,依然足够有分量。
调参公平性可以更强。 论文说明超参数主要调好视图 JEPA,大模型比较也采用特定的层级特征与 PRH 协议。相同文本下的 next-token、坏视图对照已经很有帮助,但等算力、同等调参预算、更多文本目标与更强多模态基线,会让 42 倍和 0.184 更牢靠。说实话,这部分我也不能替作者给出更强结论,现有实验能支持到哪儿就说到哪儿。
💡 放回工程里,应该怎么用
如果你在做跨模态检索、科学数据对齐或多传感器表征,我会优先检查数据里有没有“同一场景的多次独立观察”,而不是先加一轮随机遮罩。多张医学报告对应同一检查、多段语音描述同一事件、多视角视频对应同一过程,都可能比同一样本的数据增强更接近好视图。
概念上的训练循环可以非常短:
for scene in batch:
    observations = sample_observations_of_same_scene(scene)
    views = [trim_and_mask(x) for x in observations]
    embeddings = encoder(views)
    loss = invariance_loss(embeddings) + 0.02 * sigreg(embeddings)
这段伪代码省略了具体 projector 和分布式细节,真正想强调的是采样器。数据采样器在定义模型要保留的世界信息,loss 只是把这个意图落实到几何上。
如果只有单条文本,没有同场景多描述,也不必硬套。可以先做纯文本改写,但要检查改写是否保留场景、是否引入相同模板;也可以混合好视图与坏视图,用 \(q\) 控制比例。论文的 scaling law 暗示增加好视图比例比单纯重复坏视图更值得,不过长训练、重复数据和不同模态都要重新验证。
落地时还应把两种评测分开:无需拟合的 Mutual 10-NN 用来观察几何是否自然靠近,Procrustes 后的检索用来检验能否组合。若后者好、前者差,可能主要学到了映射;若两者都差,继续堆一个更大的编码器未必对症。梯度裁剪、截断比例、nuisance 测量和多种子结果,也都比单看一条 loss 曲线更有用。
回到那个“109M 胜过 72B”的标题,我的结论会克制很多:这不是规模失效的证明,而是一次很清楚的提醒——规模会放大训练信号,却不会替你把训练信号选对。 对跨模态表征而言,让模型看见同一场景的不同叙述,可能比让它反复看同一句子的不同残缺版本重要得多。
📚 公开资料
- Balestriero, R., & LeCun, Y. Proving and Improving the Platonic Representation Hypothesis with JEPAs. arXiv:2610.39302. https://arxiv.org/abs/2610.39302
- Huh, M., Cheung, B., Wang, T., & Isola, P. Position: The Platonic Representation Hypothesis. ICML 2024. https://proceedings.mlr.press/v235/huh24a.html
- Assran, M., et al. Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture. CVPR 2023. https://openaccess.thecvf.com/content/CVPR2023/html/Assran_Self-Supervised_Learning_From_Images_With_a_Joint-Embedding_Predictive_Architecture_CVPR_2023_paper.html
- Balestriero, R., & LeCun, Y. LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics. arXiv:2511.08544. https://arxiv.org/abs/2511.08544
- Schnaus, D., et al. Shared Geometry as a Rosetta Stone: Cross-Modal Alignment Without Paired Data. arXiv:2610.09411. https://arxiv.org/abs/2610.09411
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我